llama.cpp 部署 llama-server 还是用 ollama?Mac mini 24GB 同一个 GGUF 实测:ollama 底下跑的就是 llama-server
问题背景
在 Mac 上跑本地模型,绕不开一个选择:直接用 llama.cpp 的 llama-server,还是装 ollama?
网上的对比大多停留在「ollama 简单,llama.cpp 灵活」。真部署过就会发现,影响结果的往往不是哪个更快,而是一些默认值:上下文有多长、超长了会怎样、几个请求能同时跑、内存占多少。这些默认值不同,同一个模型在两边的表现就会完全不同。
这次在一台 Mac mini M4 24GB 上,让两边加载同一个 GGUF 文件,用同一套脚本、走同一个接口(OpenAI 兼容的 /v1/chat/completions,流式)逐项测:部署、接口、速度、默认上下文、长文、并发、内存,以及 27B 模型在 24GB 机器上的表现。
问题分析
开测前先看了一眼进程,结论在第一步就出来了:ollama 0.35.1 的推理进程,就是它安装包里自带的 llama-server。
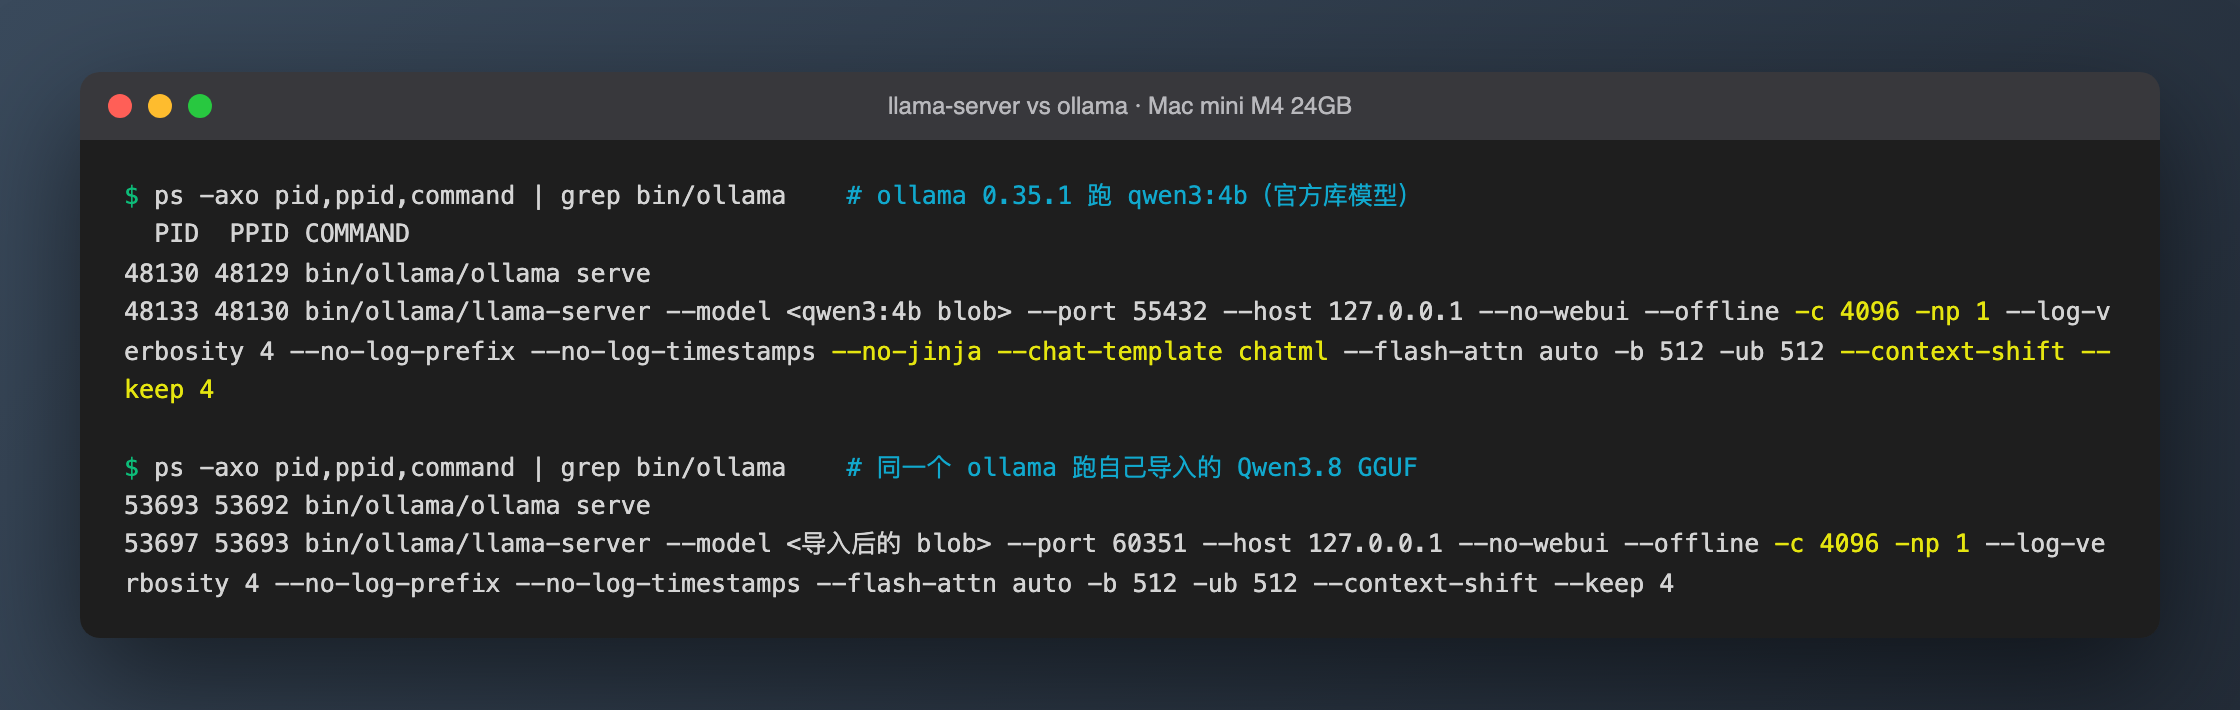 图:测速脚本在 ollama 运行时采到的进程表(路径已缩写)。上面是 ollama 官方库里的 qwen3:4b,下面是我用
ollama create 导入的 Qwen3.8 GGUF。
ollama 解压后的目录里能看到 llama-server(--version 显示 0.5.0-dev (build 1, commit 6f767fe96)),还有 mlx_metal_v3/v4 等 MLX 相关文件。加载 GGUF 模型时,ollama serve 会拉起这个 llama-server 当 runner,传给它的关键参数是:
| ollama 传的参数 | 含义 |
|---|---|
-c 4096 -np 1 |
上下文 4096,只有 1 个并发槽 |
--no-jinja --chat-template chatml |
官方库模型由 ollama 自己套模板(导入的 GGUF 没有这两个参数) |
--context-shift --keep 4 |
生成写满上下文时丢掉旧 token 继续生成 |
-b 512 -ub 512 |
逻辑批大小 512,llama-server 默认是 -b 2048 -ub 512 |
--no-webui |
关掉 llama-server 自带的网页界面 |
所以这道题不是「两个引擎谁快」,而是同一个 llama-server,ollama 替你填了哪套参数、包了哪层管理。下面的实测基本都在验证这件事。
技术方案与选型
- 版本:llama.cpp 官方 release
b11376(2026-10-03,macos-arm64 预编译包);ollama 官方 releasev0.35.1(2026-09-29,ollama-darwin.tgz)。两个都解压到临时目录运行,没有动本机原来装的 brew ollama 0.19。 - 模型,两边都是同一个文件:
- 4B:ollama 官方库
qwen3:4b的 GGUF blob(2.5GB,Q4_K_M,元数据名为 Qwen3 4B Thinking 2507)。llama-server 直接-m加载这个 blob(硬链接,不另占空间)。 - 27B:本机已有的
Qwen3.8-27B-UD-Q4_K_S.gguf(15.4GB)。ollama 用ollama create从这个文件导入,llama-server 直接加载。
- 4B:ollama 官方库
- 测法(Python 脚本,标准库实现):每个 case 起一个服务,依次测冷启动、顺序解码(长文写作,max_tokens 300 / 27B 为 200,各 5 轮 / 3 轮)、预填充(约 2,500 token 的值班记录,各 5 / 3 轮)、长文找针(开头埋一句「暗号是青鸟-7421」,后面堆满无关文字,结尾提问;4B 约 15.7k token,27B 约 7.6k token)、并发(4B 4 路 / 27B 2 路同时发)、内存(macOS
footprint)。每个 prompt 前加随机 UUID,避免命中前缀缓存。temperature 0。 - 读数口径:解码速度 =(completion_tokens − 1)÷(最后一个流式片段时间 − 第一个片段时间);预填充速度 = prompt_tokens ÷ 首 token 时间,属于客户端计时,含 HTTP 开销。内存用的是 footprint,不包含 mmap 映射的权重文件,看的是 KV 缓存、计算缓冲区这类额外开销;ollama 计入 serve 和 runner 两个进程之和。
实测过程
1. 部署:都是一条命令,差别在默认值
# llama.cpp:下载 release 包解压即可运行;模型加载完才开始监听
./llama-server -m Qwen3.8-27B-UD-Q4_K_S.gguf --host 127.0.0.1 --port 8080

# ollama:先起服务,模型在第一次请求时才加载
ollama serve                         # 默认监听 127.0.0.1:11434
ollama create qwen38-ud -f Modelfile # Modelfile 只有一行:FROM /path/to/Qwen3.8-27B-UD-Q4_K_S.gguf
两点实测观察:
-
ollama 导入 GGUF 会复制一份。
ollama create用了 17.5 秒,把 15GB 文件拷进了它自己的模型目录,同一个模型会占两份磁盘。导入后ollama show正确识别出了tools、thinking能力,说明它从 GGUF 里读出了模板。 -
反过来不一定行。拿 ollama 官方库
qwen3.5:27b的 blob 给上游 llama-server 加载,直接报错退出:error loading model hyperparameters: key qwen35.rope.dimension_sections has wrong array length; expected 4, got 3qwen3:4b的 blob 没问题。ollama 自带的 llama-server 和上游不是同一个 commit,GGUF 元数据约定有出入,所以「把 ollama 下好的模型拿给 llama.cpp 用」不是总能成功。
启动时间:模型文件已在系统缓存里时,llama-server 4B 用 -c 4096 0.6 秒就绪,用默认配置约 3 秒(要先分配 14GB 的 KV 缓存)。ollama 服务 0.20.6 秒就能响应,但模型在首个请求时才加载,4B 首 token 1.21.4 秒。27B 的 15GB 文件如果不在缓存里,两边首次加载都要 14~16 秒。另外,新下载的二进制第一次运行明显更慢(llama-server 17 秒、ollama 9.5 秒,第二次分别是 3.8 秒和 0.3 秒),应是 macOS 对新二进制的首次运行检查(推测),和引擎无关,测启动时间要剔除第一次。
2. 接口:都兼容 OpenAI,细节不同
两边都提供 /v1/chat/completions,同一个客户端改个 base URL 就能切换。我的脚本对两边发的是完全相同的请求体(stream: true + stream_options.include_usage),两边都返回了 usage。差别:
- llama-server 用
--alias给模型起名,请求里填这个名字(本次填的是m);流式最后一个片段带timings(服务端统计的 prompt/生成速度),压测很方便。 - ollama 的
model填模型列表里的名字(如qwen3:4b),服务会按名字加载对应模型;OpenAI 兼容接口的流式响应里没有timings,要看服务端耗时得用原生接口/api/chat。 - ollama 默认把模型在内存里保留 5 分钟后卸载(官方 FAQ:
By default models are kept in memory for 5 minutes),之后的请求要重新加载。llama-server 进程活着,模型就一直在内存里。
3. 速度:同参数下一模一样
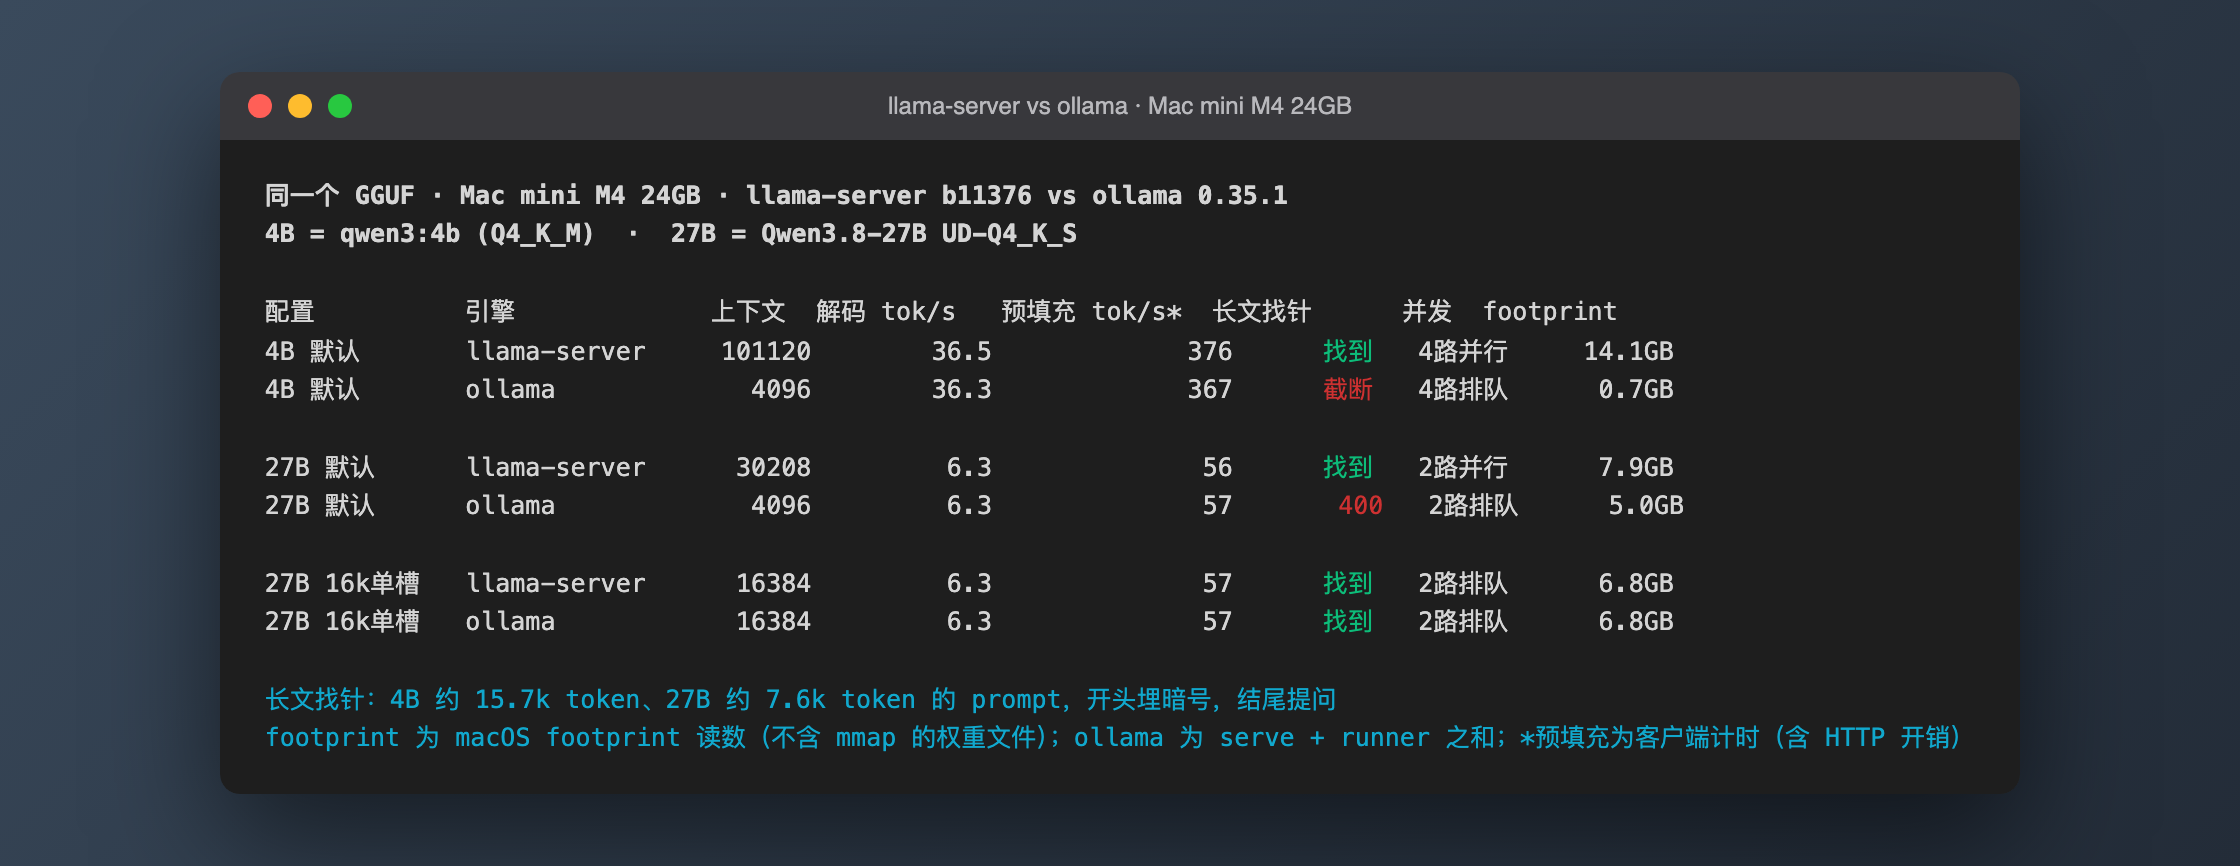 图:全部 case 的读数汇总。解码为 5 轮 / 3 轮中位数。4B 默认配置那两行的长文与内存读数来自单独的长文 case(B1/B2)。
| 模型 | 解码 tok/s(llama-server / ollama) | 预填充 tok/s,客户端计时 |
|---|---|---|
| 4B,各自默认 | 36.5 / 36.3 | 376 / 367 |
| 27B,各自默认 | 6.3 / 6.3 | 56 / 57 |
| 27B,都设 16k 单槽 | 6.3 / 6.3 | 57 / 57 |
27B 的 6.3 tok/s 和本站之前测 Qwen3.8-27B 纯自回归基线的 6.06.5 tok/s 一致。4B 预填充上 ollama 慢约 2%,我把 llama-server 改成 ollama 同款 389 tok/s,仍略高于 ollama。剩下的差别可能来自 ollama 传的 -c 4096 -np 1 后,服务端统计是 384-b 512(llama-server 默认 -b 2048),这一点我没有单独测,属于推测。总之差距在噪声边缘,选哪个都不会因为速度后悔。
4. 默认上下文:4096 和「能开多大开多大」
这是差别最大的一项。
- ollama 默认 4096。官方 FAQ 写的是
By default, Ollama uses a context window size of 4096 tokens,服务日志里也有一行vram-based default context total_vram="17.8 GiB" default_num_ctx=4096,说明这个默认值是按显存档位算出来的,这台机器落在 4096 档。 - llama-server 默认
-c 0,也就是用模型自己的上下文长度,再由默认开启的--fit按显存往下压。这份 4B 模型自带 262,144 的上下文,--fit压到 101,120,开 4 个槽共享。27B 被压到 30,208。
于是同一条约 1.57 万 token 的长 prompt,两边结果完全不同:
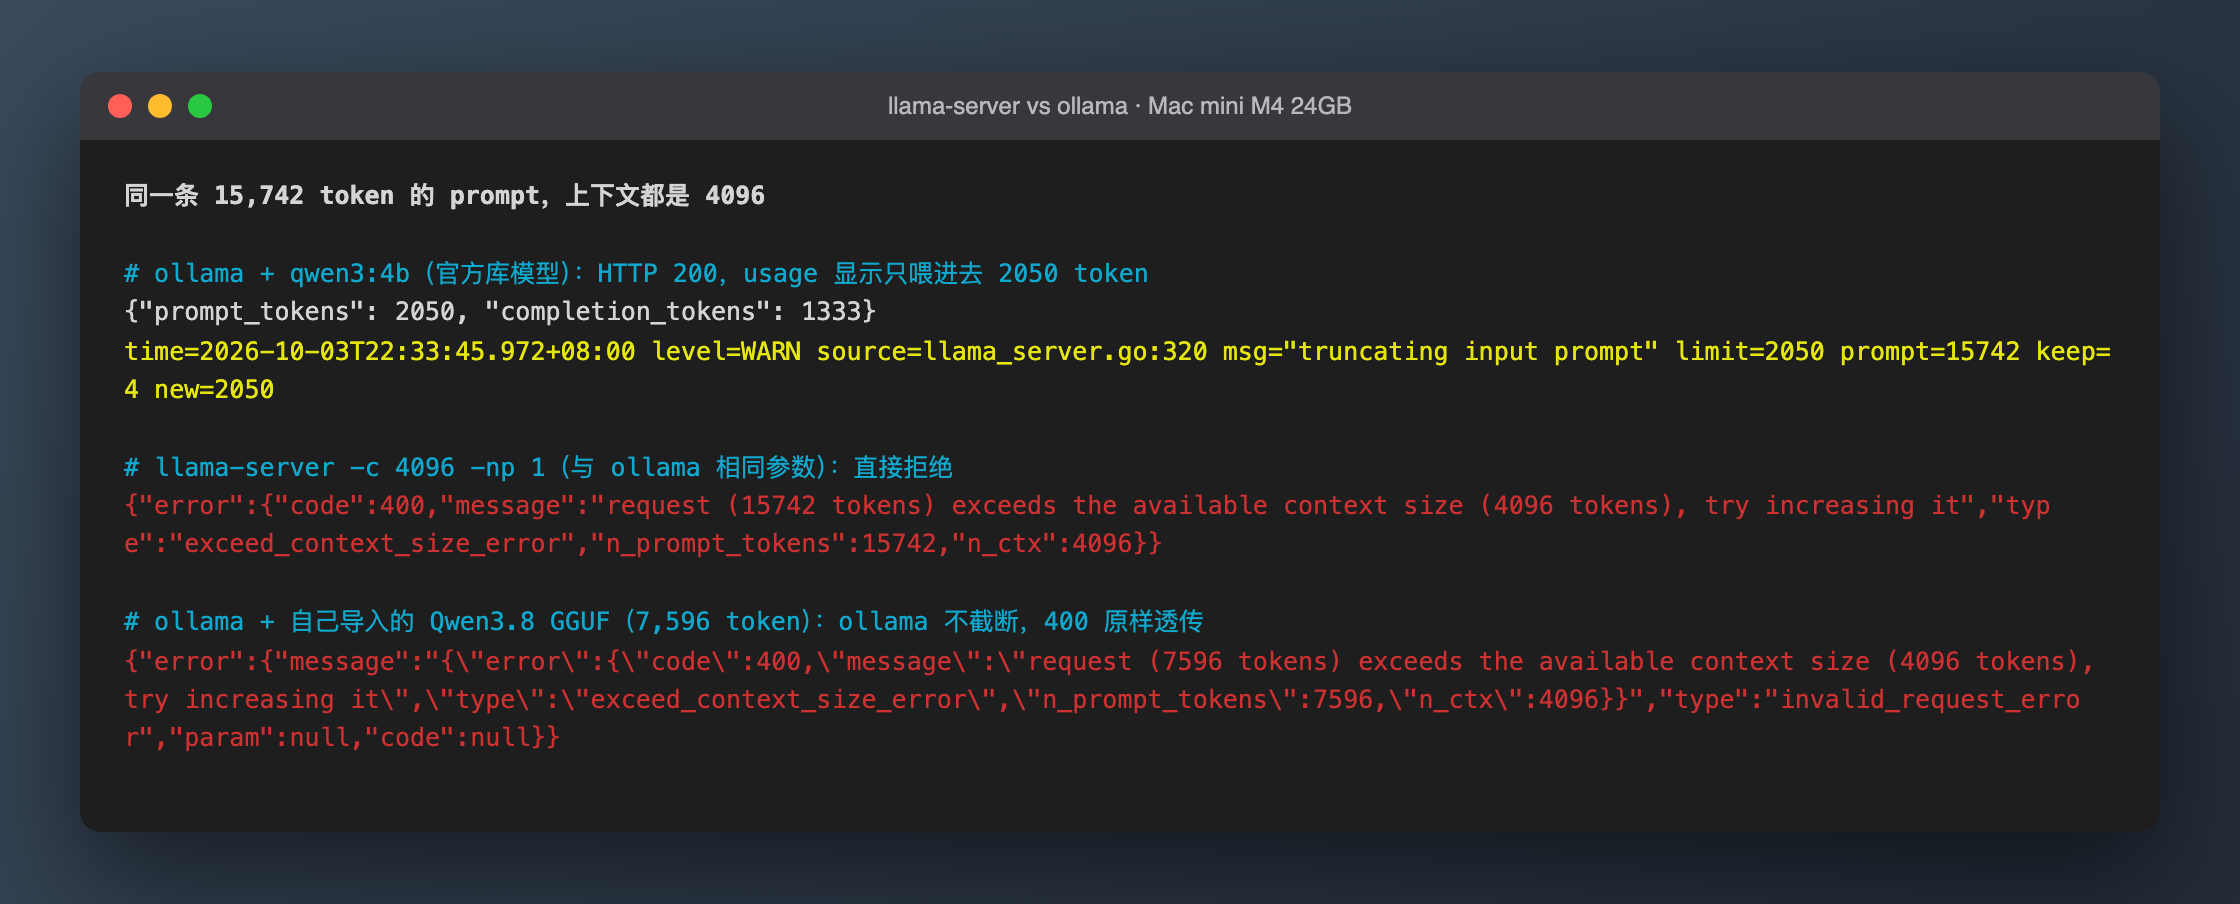 图:同样是 4096 上下文,三种处理方式。黄色那行是 ollama 服务日志里唯一的提示。
- ollama + 官方库模型:HTTP 200,
usage.prompt_tokens只有 2050。开头的暗号被截掉了,模型输出了 1,333 个 token,没有给出暗号。服务日志里只有一行level=WARN msg="truncating input prompt" limit=2050 prompt=15742 keep=4 new=2050,API 调用方完全感知不到。 - llama-server 用同样的
-c 4096 -np 1:直接 400,request (15742 tokens) exceeds the available context size (4096 tokens), try increasing it。 - ollama + 自己导入的 GGUF(27B,7,596 token):不截断,400 原样透传给调用方。原因在上面那张参数表里:官方库模型由 ollama 自己套模板(
--no-jinja --chat-template chatml),截断也是 ollama 在这一层做的;导入的模型交给 llama-server 处理,就走了 llama-server 的报错逻辑。
把上下文开够以后,两边都能找到针:llama-server 默认配置、llama-server -c 32768、ollama OLLAMA_CONTEXT_LENGTH=32768、27B 两边都设 16k,全部答对了「青鸟-7421」。
同一个 ollama,换个模型来源,超长 prompt 的行为就从「静默截断」变成「报错」。 用 ollama 做 RAG、代码库问答、长文总结时,最容易出问题的就是前一种:结果看起来正常,其实模型只看了一半。
5. 并发:默认 4 槽并行 vs 默认排队
同时发 4 个写作请求(4B,每个 200 token):
| 每路首 token(秒) | 每路解码 tok/s | 总吞吐 tok/s | |
|---|---|---|---|
| llama-server 默认(4 槽) | 2.36 / 2.37 / 2.37 / 2.37 | 11.6 | 40.9 |
| ollama 默认(1 槽) | 0.27 / 6.0 / 11.7 / 17.4 | 36.3 | 34.9 |
llama-server -c 32768(4 槽共享) |
1.02 × 4 | 11.6 | 44.0 |
ollama OLLAMA_CONTEXT_LENGTH=32768 + OLLAMA_NUM_PARALLEL=4 |
7.53 × 4 | 11.8 | 32.7 |
llama-server 的并行在 4B 上换来约 17% 的总吞吐,代价是每一路都慢到三分之一。ollama 默认排队,第 4 个请求要等 17 秒才出第一个字。27B 上并行的收益更小:2 路总吞吐 6.86 对 5.9 tok/s,每一路掉到 3.8 tok/s。
一个人用、一次只发一个请求,排队反而让单个请求最快;多个 agent / 多人共用时,才需要并行槽。
6. 内存:同样写「32k + 4 并发」,内存差了 3 倍
| 配置(4B) | 实际传给 llama-server 的参数 | footprint |
|---|---|---|
| ollama 默认 | -c 4096 -np 1 |
0.7 GB |
ollama OLLAMA_CONTEXT_LENGTH=32768 |
-c 32768 -np 1 |
4.7 GB |
ollama 32k + OLLAMA_NUM_PARALLEL=4 |
-c 131072 -np 4 |
21.0 GB |
llama-server -c 32768(自动 4 槽) |
-c 32768,kv_unified = 'true' |
6.9 GB |
| llama-server 默认 | -c 0 → fit 到 101120,4 槽 |
14.1 GB(只跑完长文 case 时) / 18.3 GB(跑完整套测试后) |
两个容易踩的点:
- ollama 的
OLLAMA_CONTEXT_LENGTH是每一路的长度,开并发会按路数相乘(官方 FAQ:Required RAM will scale by OLLAMA_NUM_PARALLEL * OLLAMA_CONTEXT_LENGTH)。llama-server 的-c是总量,开了统一 KV(kv_unified)后由各槽共享。同样写「32k、4 并发」,ollama 保证每路都有 32k,llama-server 是 4 路一共 32k。语义不同,内存差了 3 倍。 - llama-server 默认配置在 24GB 机器上会占掉大半内存,哪怕模型只有 2.5GB。原因有两个:
--fit把 KV 开到显存上限附近(默认只留 1024 MiB 余量),以及默认--cache-ram 8192会在内存里缓存最多 8GB 旧 prompt 的状态,请求跑得越多占得越多。同一个默认配置,只跑完长文 case 时是 14.1GB,跑完整套测试后是 18.3GB。
27B 的情况:llama-server 默认(30,208 上下文)7.9GB,ollama 默认 5.0GB,两边都设 16k 时都是 6.8GB。Qwen3.8 是混合注意力,每 4 层里只有 1 层是全注意力,KV 缓存比 4B 那种全注意力模型小得多,所以 27B 的额外开销反而比 4B 默认配置还低。
顺带一个反例:ollama 官方库的 qwen3.5:27b(/api/ps 报 17.2GB,runner 额外挂了 --mmproj 视觉模块)在这台机器上,/api/ps 显示 size_vram 15.6GB,也就是约 1.6GB 放在了 CPU 上(/api/ps 的字节数换算,十进制 GB),解码 5.8 tok/s,footprint 21.1GB。17GB 级的模型放在 24GB 机器上已经到边缘了;同为 27B 的 UD-Q4_K_S(15.4GB)能全部放进 GPU。
7. 自带网页界面:llama-server 有,ollama 关掉了
llama-server 默认就带 Web UI,浏览器打开 http://127.0.0.1:8080 就能对话,还会显示 token 数和速度:
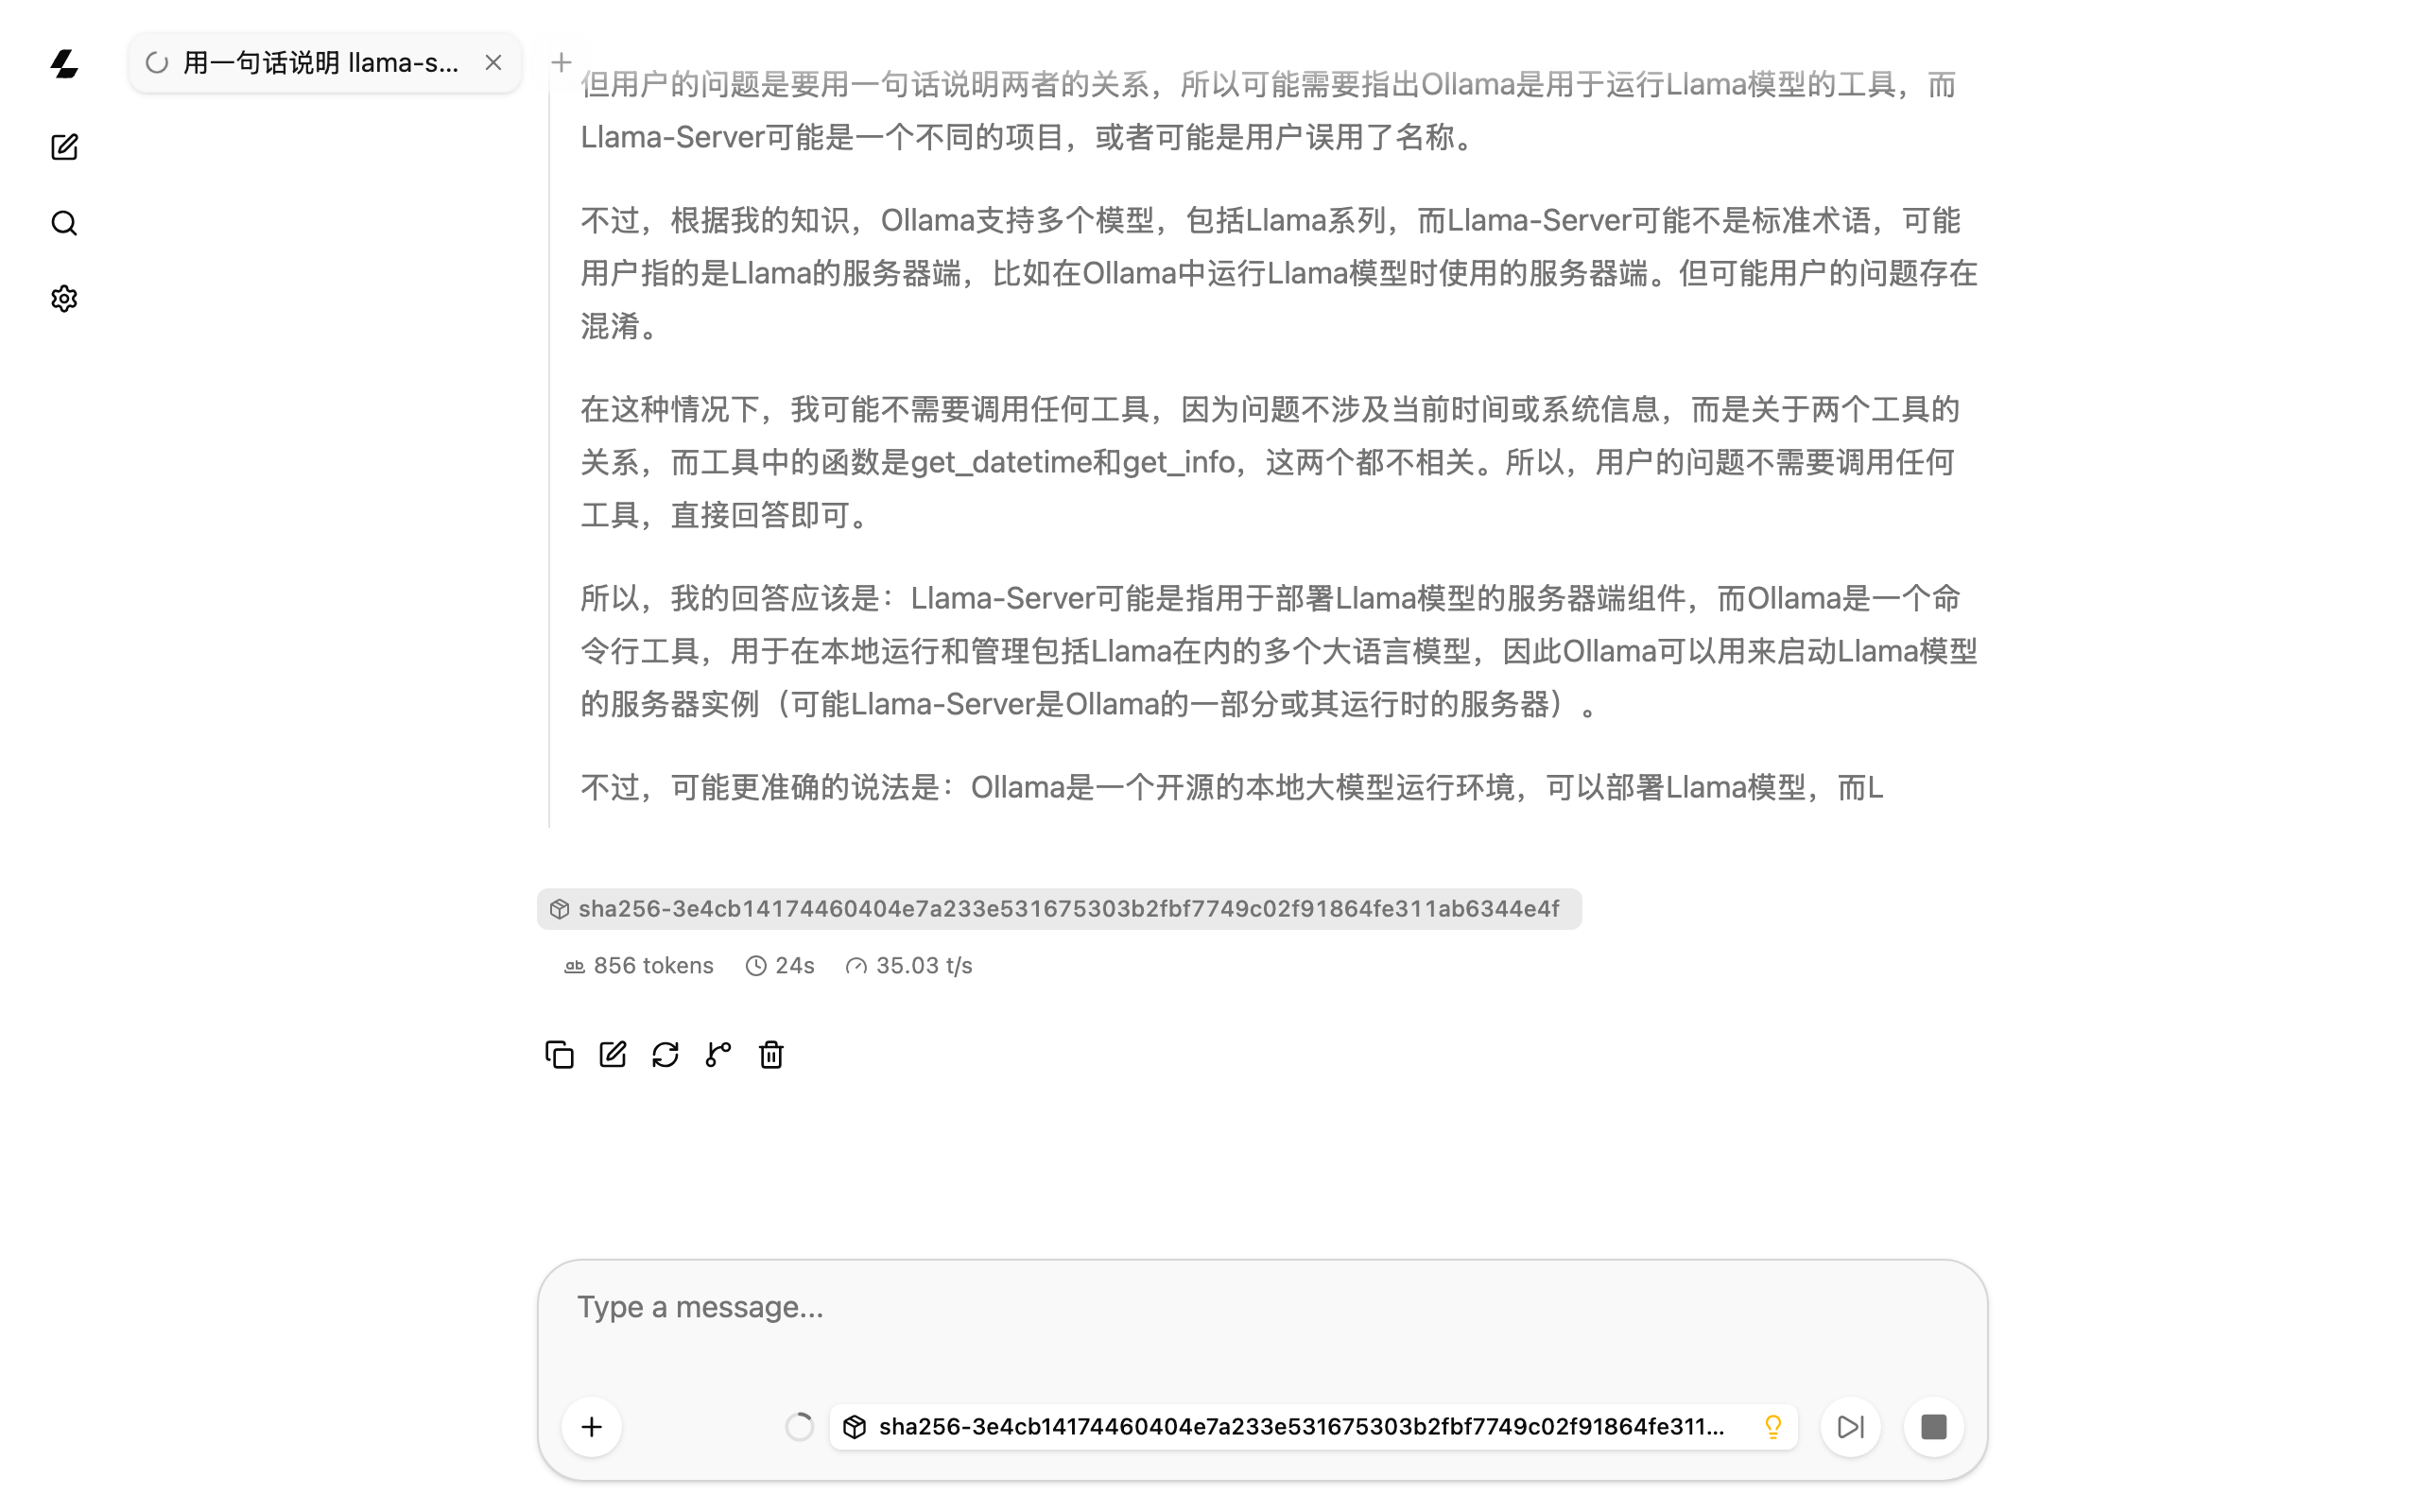 图:llama-server b11376 自带的 Web UI,模型为 4B(
-c 8192 -np 1)。截图停在思考阶段;这个 4B 模型在思考里把 llama-server 和 ollama 的关系猜错了,仅作界面演示。
ollama 启动 runner 时显式传了 --no-webui,命令行版本没有网页界面(macOS 桌面 app 自带聊天窗口,不在这次测试范围)。想给 ollama 配网页界面,需要另装 Open WebUI 这类前端。
实践效果
怎么选
| 你的情况 | 选择 |
|---|---|
| 想要「装上就能用」、模型从官方库拉、经常切换模型 | ollama,但先把 OLLAMA_CONTEXT_LENGTH 调大 |
| 自己管 GGUF 文件、要精确控制上下文 / 并发 / 内存,或者想要自带网页界面 | llama-server |
| 给 Claude Code 类工具、RAG、长文总结当后端 | 两个都行,关键是上下文要显式设够;ollama 官方库模型超长会静默截断,必须注意 |
| 多个 agent 或多人同时调用 | llama-server 默认就有并行槽;ollama 要设 OLLAMA_NUM_PARALLEL,并且按「每路长度 × 路数」算内存 |
24GB Mac 上的推荐启动参数
# llama-server:显式设上下文和槽数,别让 --fit 和 prompt 缓存吃满内存
./llama-server -m model.gguf -c 16384 -np 1 --cache-ram 2048 \
  --host 127.0.0.1 --port 8080

# ollama:服务端设默认上下文(命令行启动的写法)
OLLAMA_CONTEXT_LENGTH=16384 ollama serve
27B 用 -c 16384 -np 1 时,两边的 footprint 都是 6.8GB,加上约 14.3GB(15.4GB 文件)映射的权重,总共接近 21GB。24GB 机器上余量不多,跑之前最好关掉吃内存的大应用。
--cache-ram 2048 这个值我没有单独测,是按「默认 8GB 在 24GB 机器上太大」给的保守值。想完全关掉 prompt 缓存可以设 0(官方说明:0 - disable)。ollama 桌面 app 不经过你的 shell,环境变量要按官方 FAQ 用 launchctl setenv 设置后重启 app。单次请求也可以在原生接口里用 options.num_ctx 覆盖默认上下文(官方 FAQ 的写法)。
安全提醒
- llama-server 启动时会打印
security: no API key is set and CORS allows all origins。默认只听 127.0.0.1 没问题;如果改成--host 0.0.0.0对局域网开放,记得加--api-key。 - ollama 默认绑定 127.0.0.1:11434(官方 FAQ)。按教程设
OLLAMA_HOST=0.0.0.0之后,局域网里谁都能调用,它本身没有鉴权。
踩坑
- ollama 静默截断只在官方库模型上发生。 同一个 ollama,导入的 GGUF 超长时返回 400,官方库模型返回 200 加一半的 prompt。排查「模型怎么没看到前面的内容」时,先看
usage.prompt_tokens对不对,再看 ollama 服务日志里有没有truncating input prompt。 OLLAMA_NUM_PARALLEL会让内存乘以路数。 4B 设 32k 加 4 并发就是 21GB;换成 27B,24GB 的机器不可能装得下。- llama-server 默认配置会把内存占满。 4B 模型 footprint 14.1~18.3GB。在共享的 Mac 上跑,记得显式设
-c和--cache-ram。 - ollama 的 blob 不保证能给上游 llama.cpp 用。
qwen3.5:27b实测报rope.dimension_sections长度不符。要两边共用文件,用上游 GGUF 让 ollama 导入。 - 这份 qwen3:4b 是 Thinking 版,
/no_think不起作用。 第一轮长文测试我只给了 32 个 token 的输出预算,全部花在思考上,两边都答不出来,差点误判成「两边都截断了」。改成 2048 才看清真实结果。 - 实验本身的坑:有一组 llama-server 在长文请求上返回 400,测速脚本没接住异常直接退出,留下的 llama-server 成了孤儿进程,占着 8080 端口和十几 GB 内存。下一组 ollama 在内存被占的情况下跑,再下一组 llama-server 的就绪检查直接连到了这个孤儿进程。这三组读数全部作废(保留原始记录),脚本改成 try/finally 收尾加启动前检查端口后重跑。另外,footprint 不含 mmap 的权重,llama-server 的 prompt 缓存又会随测试推进增长,内存对比必须在相同阶段采样,上表已注明。