果蝇大脑怎么下载?13.9 万个神经元,我在 Mac mini 上 33 秒跑完一次实验
果蝇大脑怎么下载?13.9 万个神经元,我在 Mac mini 上 33 秒跑完一次实验
搜「果蝇大脑下载」的人,大多是看了「科学家把果蝇大脑上传到电脑」的新闻,想自己试试。好消息是:真的可以,而且比想象中简单。坏消息是:官方示例照着 README 改一行配置就会报错。
我在一台 Mac mini 上从零走了一遍,全程计时。先给结论:
- 「果蝇大脑」是两个文件:138,639 个神经元的清单(3.3 MB),和一张 15,091,983 行的连接表(101 MB)。每一行写着「谁连着谁、有几个突触、是兴奋还是抑制」。
- 普通电脑就能跑:克隆 57 秒,装依赖 21 秒,官方的糖味觉示例(30 次试验 × 1 秒脑时间)33 秒跑完。
- 照 README 切到公开版 v783 数据会直接
KeyError,因为示例里的神经元 ID 是旧版本的。改法很简单,下文给出能直接跑的版本。 - 跑通以后,你可以做真实果蝇上很难做的实验:一次关掉一个神经元,看整只脑怎么变。
问题背景:下载的到底是什么
2024 年 FlyWire 联盟在 Nature 上发布了第一张完整的成年果蝇全脑接线图(连接组)。同期 Shiu 等人在 Nature 上发表了一个基于它的全脑模型:把每个神经元简化成「会漏电的积分器」(LIF),连接强度直接用突触数量,在 Brian2 模拟器里跑。
这个模型的官方仓库 philshiu/Drosophila_brain_model 把公开版数据一起放在了里面,所以「下载果蝇大脑」最直接的做法就是克隆它:
| 文件 | 大小 | 内容 |
|---|---|---|
Completeness_783.csv |
3.3 MB | 138,639 个神经元的 FlyWire ID |
Connectivity_783.parquet |
101 MB | 15,091,983 条连接:上游 ID、下游 ID、突触数、兴奋/抑制 |
model.py / utils.py |
14 KB | 模型本体与读结果的工具函数 |
| 旧版 v630 数据 | 90 MB | 论文当时用的版本,示例默认还指着它 |
整个仓库克隆下来 380 MB,其中一半是 git 历史。想要更全的数据(细胞类型、神经递质、三维形态),去 FlyWire 的 Codex(codex.flywire.ai),那里是官方数据门户。许可是 CC BY-NC 4.0:署名、不可商用。
这张表里有什么
在跑模型之前,先把表拆开看看,几个数字挺有意思:
| 项 | 数值 |
|---|---|
| 神经元 | 138,639 |
| 有连接的神经元对 | 15,091,983 |
| 突触总数(把「突触数」一列加起来) | 54,492,922 |
| 兴奋性连接占比 | 60% |
| 只有 1 个突触的连接 | 49.7% |
| 5 个及以上突触的连接 | 17.9% |
| 每个神经元平均连向 | 109 个下游 |
| 两个神经元之间最多的突触 | 2,405 个 |
| 连接密度 | 0.08%(每个神经元只连了全脑的万分之八) |
第三行是一个很好的交叉验证:Nature 论文写的是「5,450 万个突触」,这张表加起来是 5,449 万,对得上。
还有两个值得一提:
- 一半的连接只有 1 个突触。 自动检测会有误报,所以 FlyWire 在 Codex 上默认用「至少 5 个突触」才算一条连接。按这个标准,这张表只剩不到五分之一。Shiu 的模型没做这个过滤,1 个突触的连接也算进去了,只是权重小。
- 全脑连接最多的神经元只有两个,而且是同一种。 连出最多的(9,783 个下游)和连入最多的(10,356 个上游)分别是左右视叶里的 CT1——这种细胞全脑只有 2 个,每侧一个,单个细胞的分支横跨视叶的髓质和小叶(细胞类型来自 FlyWire 官方注释,Schlegel et al. 2024)。
实测过程
环境:Mac mini M4(10 核、24 GB),Python 3.12,Brian2 2.10.1(代码生成后端自动选了 Cython)。我用 uv 管环境,下面给等价的 pip 命令。Windows 我没有测。
第一步:克隆和安装
git clone https://github.com/philshiu/Drosophila_brain_model.git   # 57 秒,380 MB
cd Drosophila_brain_model
python3 -m venv .venv && source .venv/bin/activate
pip install brian2 pandas pyarrow joblib                           # 21 秒(无缓存)
README 推荐的是 conda 环境(锁在 Python 3.10、Brian2 2.5.1),不装 conda 直接 pip 装最新版也能跑。
第二步:照 README 换成 v783,然后报错
示例 example.ipynb 默认用的是论文当时的 v630 数据。README 的「Version 783」一节说:要用公开版,把配置换成这样——
config = {
    'path_res'  : './results/new',
    'path_comp' : './Completeness_783.csv',
    'path_con'  : './Connectivity_783.parquet',
    'n_proc'    : -1,
}
照做,再跑示例里「刺激右侧糖味觉神经元」那一段:
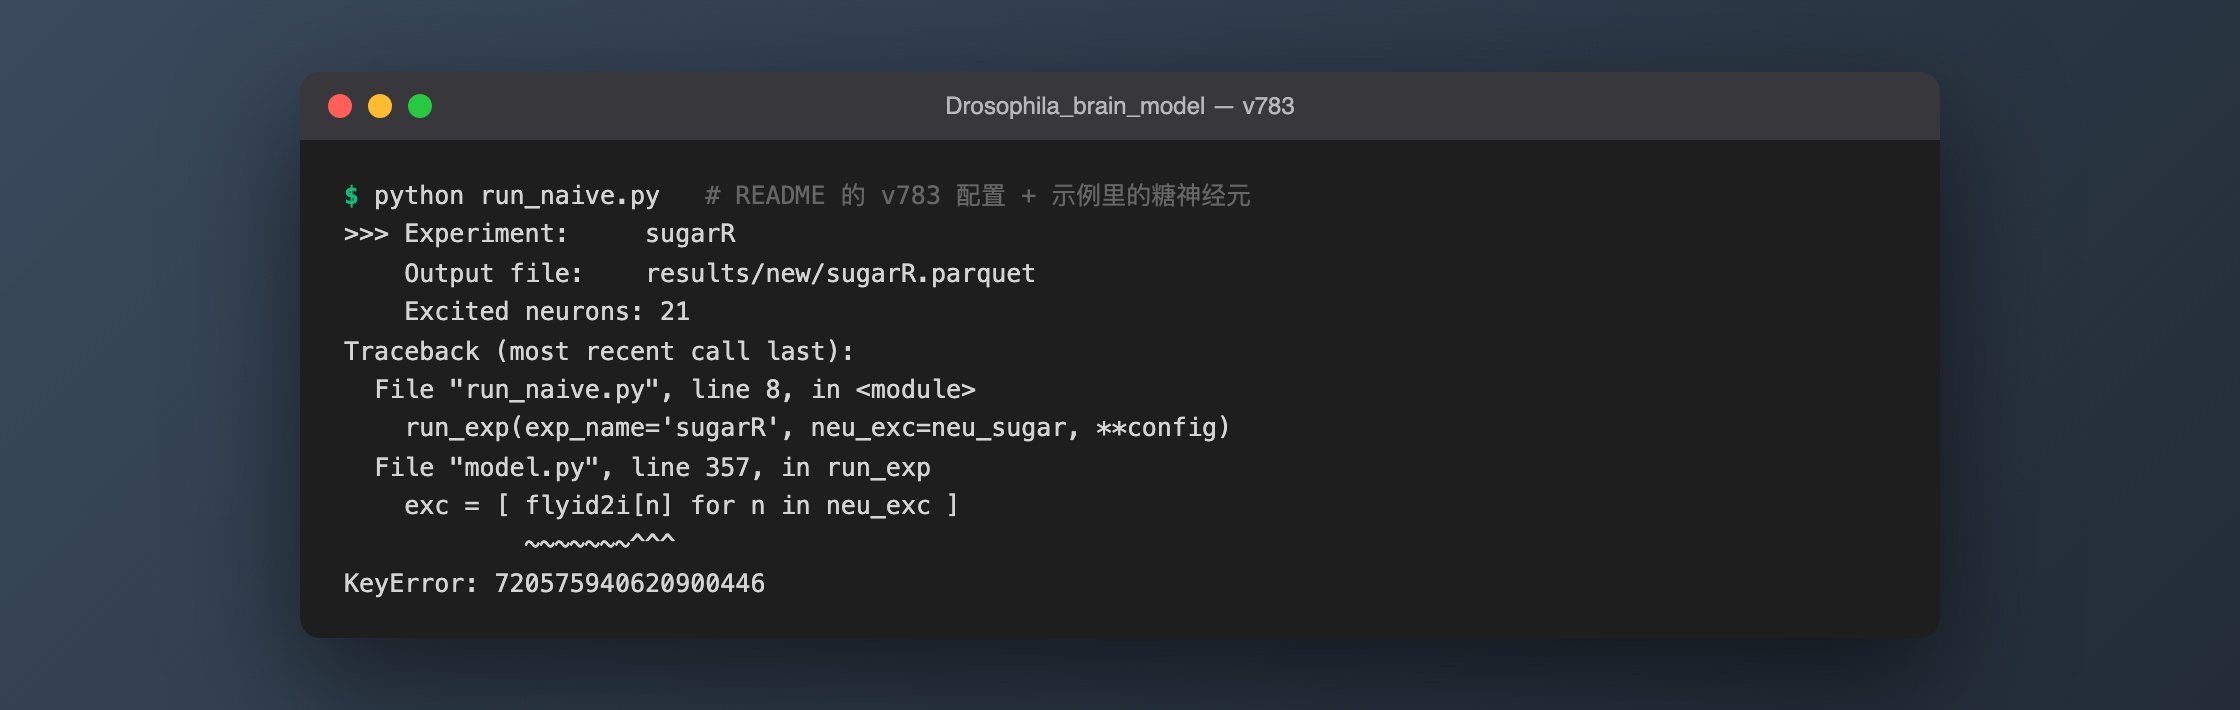
原因是 FlyWire 的神经元 ID 会随着校对变化:一个神经元被重新拆分或合并后,就会得到新 ID。示例里的 21 个糖神经元是 v630 的 ID,我逐个比对,其中 20 个在 v783 里还在,720575940620900446 已经没了。两个版本的神经元只有 106,220 个 ID 重合(v630 共 127,400 个,v783 共 138,639 个)。
这里还有第二个坑:README 给的 ./results/new 目录仓库里并不存在。模型不会先检查目录,而是跑完整个模拟、保存结果时才报 Cannot save file into a non-existent directory——前面算的全白费。
第三步:能跑的版本
mkdir -p results/v783
import pandas as pd
from model import run_exp

neu_sugar = [...]  # 把 example.ipynb 里的 21 个 ID 粘过来

# v783 里已经不存在的 ID 过滤掉(会剩 20 个)
valid = set(pd.read_csv('./Completeness_783.csv').iloc[:, 0])
neu_sugar = [n for n in neu_sugar if n in valid]

config = {
    'path_res'  : './results/v783',
    'path_comp' : './Completeness_783.csv',
    'path_con'  : './Connectivity_783.parquet',
    'n_proc'    : -1,          # 用上所有 CPU 核
}
run_exp(exp_name='sugarR', neu_exc=neu_sugar, **config)
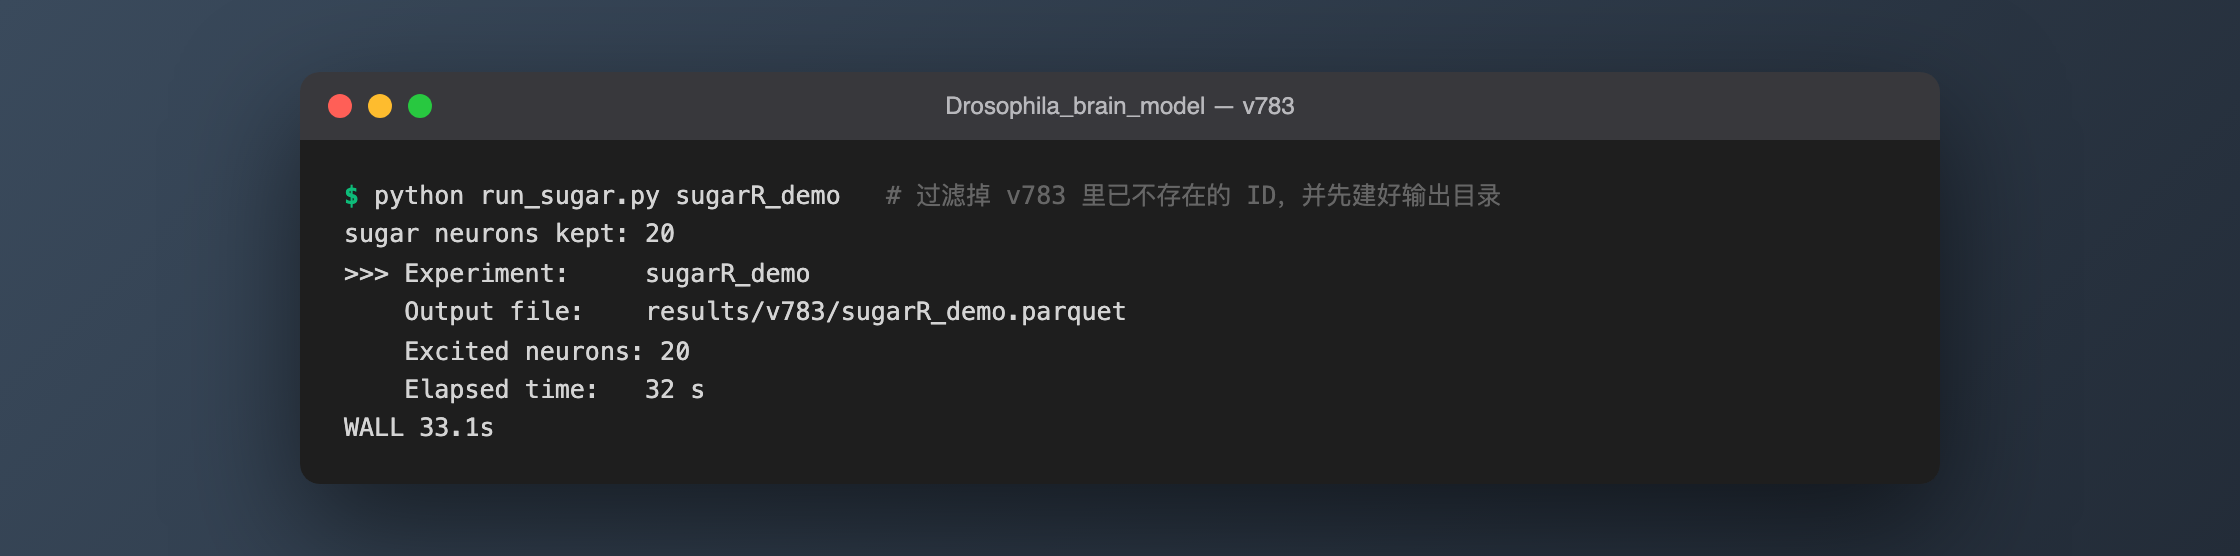
默认参数是 30 次独立试验、每次 1 秒脑时间,joblib 把 30 次分到所有核上并行。我前后跑了两次,分别是 33 秒和 32 秒。
读结果:
import utils as utl
from model import default_params as params

df = utl.load_exps(['./results/v783/sugarR.parquet'])
rate, _ = utl.get_rate(df, t_run=params['t_run'], n_run=params['n_run'])
print(rate.loc[720575940660219265])   # MN9:控制伸喙的运动神经元
和仓库里自带的 v630 结果对比:
| 刺激的糖神经元 | 30 次试验总脉冲 | 有放电的神经元 | MN9 放电率 | |
|---|---|---|---|---|
| 我的实测(v783) | 20 个 | 388,402 | 427 | 80.2 Hz |
| 仓库自带结果(v630) | 21 个 | 511,566 | 448 | 93.3 Hz |
量级一致:刺激 20 个感觉神经元,13.9 万个神经元里只有 400 多个被带动起来,其中包括控制伸出口器(喙)的运动神经元 MN9。数字不完全相同,一是少了一个刺激神经元,二是两个版本的接线图本身不同。
顺带一提,示例的文字说明写「默认以 200 Hz 刺激」,但 model.py 里 r_poi 的默认值是 150 Hz。以代码为准。
第四步:做一个真果蝇上很难做的实验
数字大脑最好玩的地方在于,可以一次只关掉一个神经元。真实果蝇上要做到这一点,需要为那个细胞专门构建遗传工具;这里只要一个参数:
run_exp(exp_name='sugarR-silence', neu_exc=neu_sugar,
        neu_slnc=[720575940640589171], **config)   # 把这个神经元的所有连接置零
我挑了糖刺激下放电最高的 5 个非感觉神经元,逐个沉默,看 MN9 的变化(每组 30 次试验,MN9 试验间标准差约 4~5 Hz):
| 被沉默的神经元 | 细胞类型(FlyWire 注释) | 它自己的放电率 | 沉默后 MN9 |
|---|---|---|---|
| —(不沉默) | 80.2 Hz | ||
| …622695448 | CB0248,中央脑内部神经元 | 132.4 Hz | 80.6 Hz |
| …627383685 | CB0248(另一侧) | 120.3 Hz | 80.4 Hz |
| …629888530 | CB0192,中央脑内部神经元 | 119.0 Hz | 76.2 Hz |
| …618165019 | CB0700,另一个进食运动神经元 | 110.9 Hz | 78.0 Hz |
| …640589171 | DNge031,下行神经元 | 107.6 Hz | 104.2 Hz |
前四个很「活跃」的神经元,关掉任何一个,MN9 几乎不动——这条通路有冗余,不靠某一个细胞。第五个反过来:关掉它,进食输出升了 30%。 它在注释里是一个下行神经元 DNge031,预测递质是 GABA(抑制性);也就是说,模型预测它在糖刺激时一边被激活,一边在给进食踩刹车。
两点要说清楚:DNge031 的递质预测置信度只有 0.50,接近五五开;这是模型的预测,我没有、也没法在真实果蝇上验证。但这正是这个模型的用途——Shiu 等人在论文里做了同样的事,164 条能用实验检验的预测里,91% 和实验结果一致。
5 组沉默实验一共跑了 456 秒,平均每组约 1.5 分钟。
踩坑
- v630 的神经元 ID 不能直接用在 v783 上。 任何从论文、旧教程、旧代码里抄来的 ID,先对一遍
Completeness_783.csv。示例里 21 个糖神经元,有 1 个已经不存在。 - 输出目录要先建好。 目录不存在时,模型会把模拟完整跑完,最后保存时才报错。
- README 的 v783 配置用的
./results/new仓库里没有,照抄就会撞上一条。 - uv / pip 的缓存会让安装时间看起来很短。 我第一次装只用了 2 秒,那是缓存;关掉缓存重装是 21 秒。
- 「有放电」不等于「重要」。 放电最高的几个神经元沉默后几乎没影响,真正起调节作用的反而排在第五。挑沉默对象时,别只看放电率。
常见问题
果蝇大脑数据可以免费下载吗?
可以。FlyWire 的公开版(v783)数据在 Codex(codex.flywire.ai)提供下载,Shiu 的模型仓库里也附带了跑模型所需的两个文件。许可是 CC BY-NC 4.0:可以用于学习和研究,需要署名,不能商用。
需要 GPU 吗?
不需要。这个模型是稀疏矩阵运算,CPU 就够;我之前在同一台机器上对比过,Brian2 跑在 CPU 上比用 PyTorch 跑在 Apple GPU(MPS)上快 7 倍。10 核 Mac mini 跑一次官方示例约 33 秒,核数少的机器会按比例变慢。
下载下来的是「完整的果蝇」吗?
不是。它只有脑,没有腹神经索(相当于脊髓),也没有身体;神经元模型只有膜电位和突触,没有学习、记忆和神经调质。所以它能回答「刺激这群神经元,哪些下游会被激活」,但不会自己动——不给输入时,每个神经元的放电率都是 0。
能让它控制一只果蝇的身体吗?
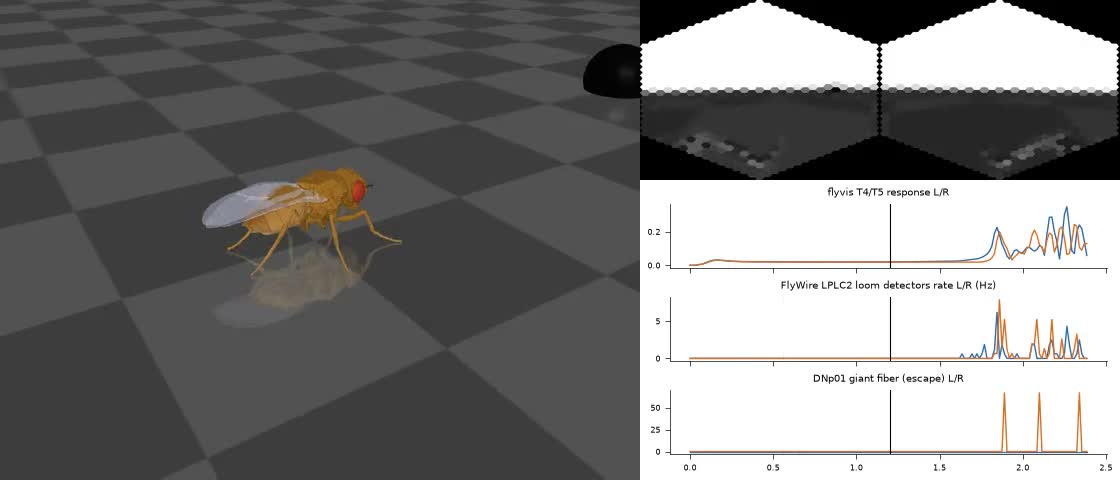
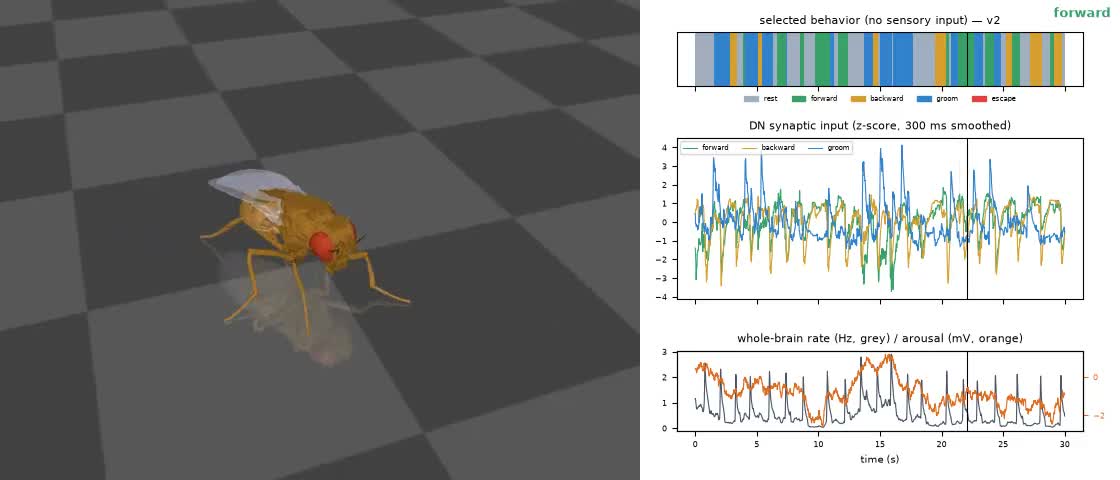
能,但要自己写脑和身体之间的接口。我在另一篇实测里把它接上了 NeuroMechFly 的物理身体,让它尝到糖后转身去吃、看到逼近的黑球后逃跑;不想装环境的话,可以直接在数字果蝇实验室里用浏览器开一只物理仿真的果蝇。
参考
- Dorkenwald et al. 2024, Neuronal wiring diagram of an adult brain, Nature. doi:10.1038/s41586-024-07558-y
- Schlegel et al. 2024, Whole-brain annotation and multi-connectome cell typing of Drosophila, Nature. doi:10.1038/s41586-024-07686-5(细胞类型注释:github.com/flyconnectome/flywire_annotations)
- Shiu et al. 2024, A Drosophila computational brain model reveals sensorimotor processing, Nature. doi:10.1038/s41586-024-07763-9(代码:github.com/philshiu/Drosophila_brain_model)