MiniMax T2A v2 vs Azure Neural TTS 实测:同一段中英文本,延迟差了 6~10 倍
MiniMax T2A v2 vs Azure Neural TTS 实测:同一段中英文本,延迟差了 6~10 倍
我那套 Sun Tzu at Work 视频工厂 里,TTS 是流水线上最不起眼、却最容易卡住整条线的一环。一集视频要合成十几段中英文旁白,如果每段等好几秒,npm run bingfa tts 这一步就能拖成一杯咖啡的时间。
工厂里同时接了两家:MiniMax T2A v2(境内 api.minimaxi.com)和 Azure Neural TTS(微软 eastasia 区)。切换只改一个 TTS_PROVIDER 环境变量,输出都被统一成 24kHz / 单声道 / 16bit 的 WAV,下游的 Remotion 合成完全不区分来源。用了一段时间,主观感受是 MiniMax 明显更快,但"明显"值多少、慢的到底是模型还是网络,一直没测过。这次把它钉死。
先给结论:在我这台大陆直连的机器上,MiniMax 合成中位延迟 1.02.2 秒、快于实时 512 倍;Azure 中位 6~21 秒、勉强追平实时,长尾能抖到 27 秒。 这不是"快一点",是量级差距。但差距里有一半是网络的锅——这点后面用抓包说清楚。
问题背景:TTS 延迟不是玄学,它直接决定流水线节奏
视频工厂是批处理,不是实时对话,所以严格来说"首包延迟"对我不是刚需——我不需要边合成边播。真正卡我的是整段音频返回的墙钟时间:一集十几段旁白串行合成,每段慢 5 秒,累计就是一分多钟的干等。
更麻烦的是方差。如果延迟稳定,我还能预估;可要是这一段 3 秒、下一段 27 秒,重试逻辑和超时阈值就没法设——设短了误杀慢请求,设长了卡死不报错。所以这次实测我不光看中位数,min/max 一起记,专门盯长尾。
两家 API 的调用形态也不同,值得先说清楚:MiniMax T2A v2 我走的是非流式同步接口(/v1/t2a_v2,一次请求返回整段十六进制 PCM);Azure 走的是 REST 一次性合成(SSML 进、riff-24khz-16bit-mono-pcm 出)。两边都是"发一次请求、拿整段音频",度量口径一致,可比。
问题分析:延迟由两段构成,得分开归因
一次 TTS 合成的墙钟延迟,粗看是两段之和:
- 服务端合成耗时——模型把文本变成波形要多久。这是模型和推理架构决定的,跟你在哪儿无关。
- 网络往返 + 传输——请求打过去、音频拉回来的路上花的时间。这跟你的机器到服务端的物理距离强相关。
如果只测总延迟,MiniMax 快就快了,但你说不清是"模型快"还是"网络近"。而这两个归因导向完全相反的结论:如果是模型快,那换到海外服务器 Azure 也快不起来;如果纯是网络,那把服务部署到 Azure 同机房就能抹平差距。所以这次我总延迟和网络 RTT 分开测——总延迟用 5 轮取中位,网络单独用 curl 抓 connect/TLS 握手时间。
技术方案与选型:复现范围怎么划
这类"两家对比"最容易翻车的是量纲不统一——采样率不同、声道不同、量化位深不同,比出来的字节数和音质都没意义。所以我把范围严格收敛:
- 复用生产 TTS 抽象层(
src/lib/bingfa/tts.ts),不为测试单写调用代码。两家在这一层已经被统一成 24kHz / 单声道 / 16bit PCM,输出格式完全一致——这是可比的前提。 - 同一批文本:中英各两段,短句 + 长段,取自《孙子兵法》原文(正好是工厂真实旁白的语料风格)。中文按去空白字符数、英文按词数计。
- 每 case 跑 5 轮,取中位数抗抖动,同时保留 min/max 看长尾。
- 音色固定:MiniMax 用工厂默认的
speech-02-turbo;Azure 中文zh-CN-YunxiNeural、英文en-US-GuyNeural(都是工厂在用的音色)。 - 明确排除音质主观评分(排除项)。音质是主观维度,一个人打分没有统计意义;我只客观记录格式是否对齐(都 24kHz/mono/16bit)和波形形态。字节数我记了但不当质量指标——WAV 是无压缩定长格式,字节数只跟时长成正比,跟"好不好听"无关,谁把它当音质比谁就错了。
- 单价只做定性对照(排除项)。MiniMax 境内计费口径几经调整、且分按 token 与按字符两种,我拿不到当前权威单价就不硬报数字,只给能确认的量级。
落地/实测过程
主体:40 次合成的延迟矩阵
测试脚本直接 import 生产的 synthesize(),靠 TTS_PROVIDER 环境变量切后端,每轮用 performance.now() 掐整段返回耗时,第一轮的 WAV 落盘留证。跑法:
npx tsx --env-file=.env tmp/2026-09-05-tts-bench/bench.ts # 4 case × 5 轮 × 2 家
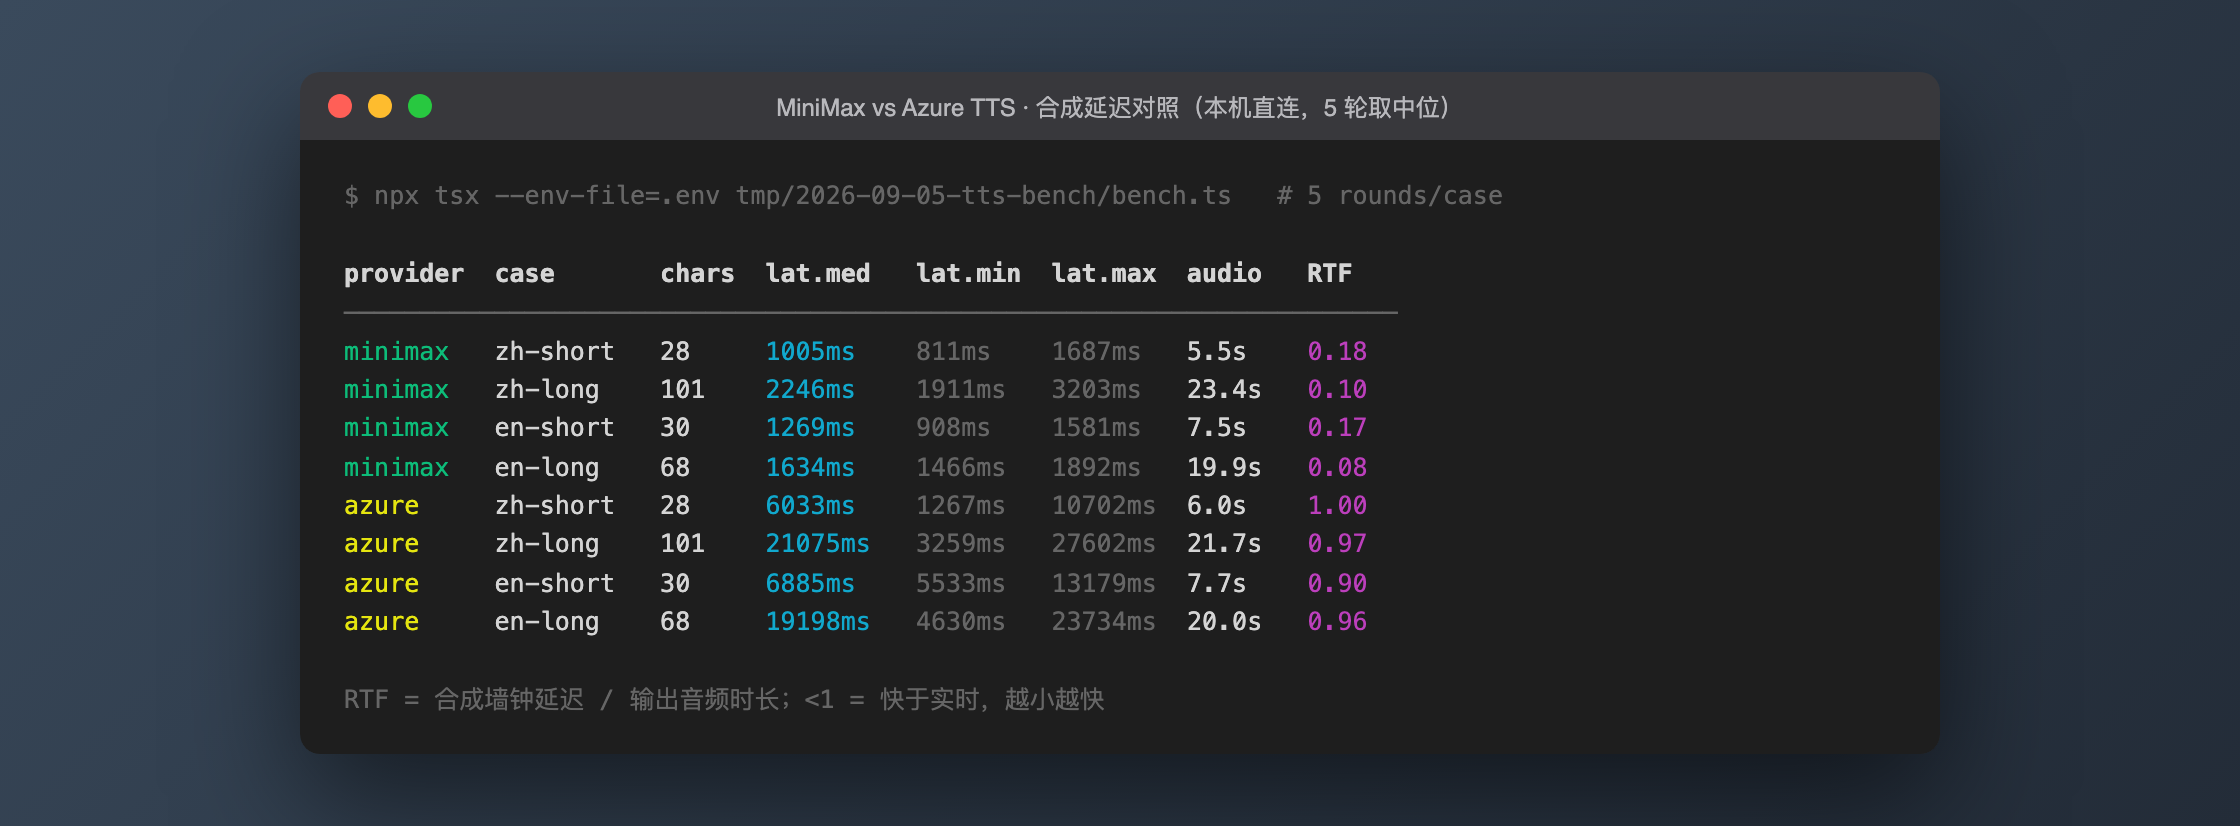
跑完的原始矩阵如下(lat.med/min/max 是 5 轮的中位/最快/最慢,RTF = 合成墙钟延迟 ÷ 音频时长,小于 1 即快于实时):
两个现象一眼可见:
- MiniMax 全面快于实时。 RTF 落在 0.08
0.18,也就是合成一段 20 秒的音频只花 1.6 秒,等于比"边读边等"快 512 倍。而且四个 case 的 min/max 跨度都很窄(如 en-long 1466~1892ms),稳。 - Azure 的 RTF 逼近 1.0——合成 20 秒音频差不多真要花 20 秒,几乎就是"念一遍"的速度。更扎眼的是长尾:
zh-long五轮里最快 3.3 秒、最慢 27.6 秒,en-short也从 5.5 秒抖到 13.2 秒。这种方差对流水线是灾难。
归因:用 curl 把网络那段单独抠出来
Azure 慢,到底是模型慢还是跨太平洋网络慢?我用 curl 对两家端点各打一次,只看 TCP connect 和 TLS 握手时间——这段纯网络,不含任何合成:
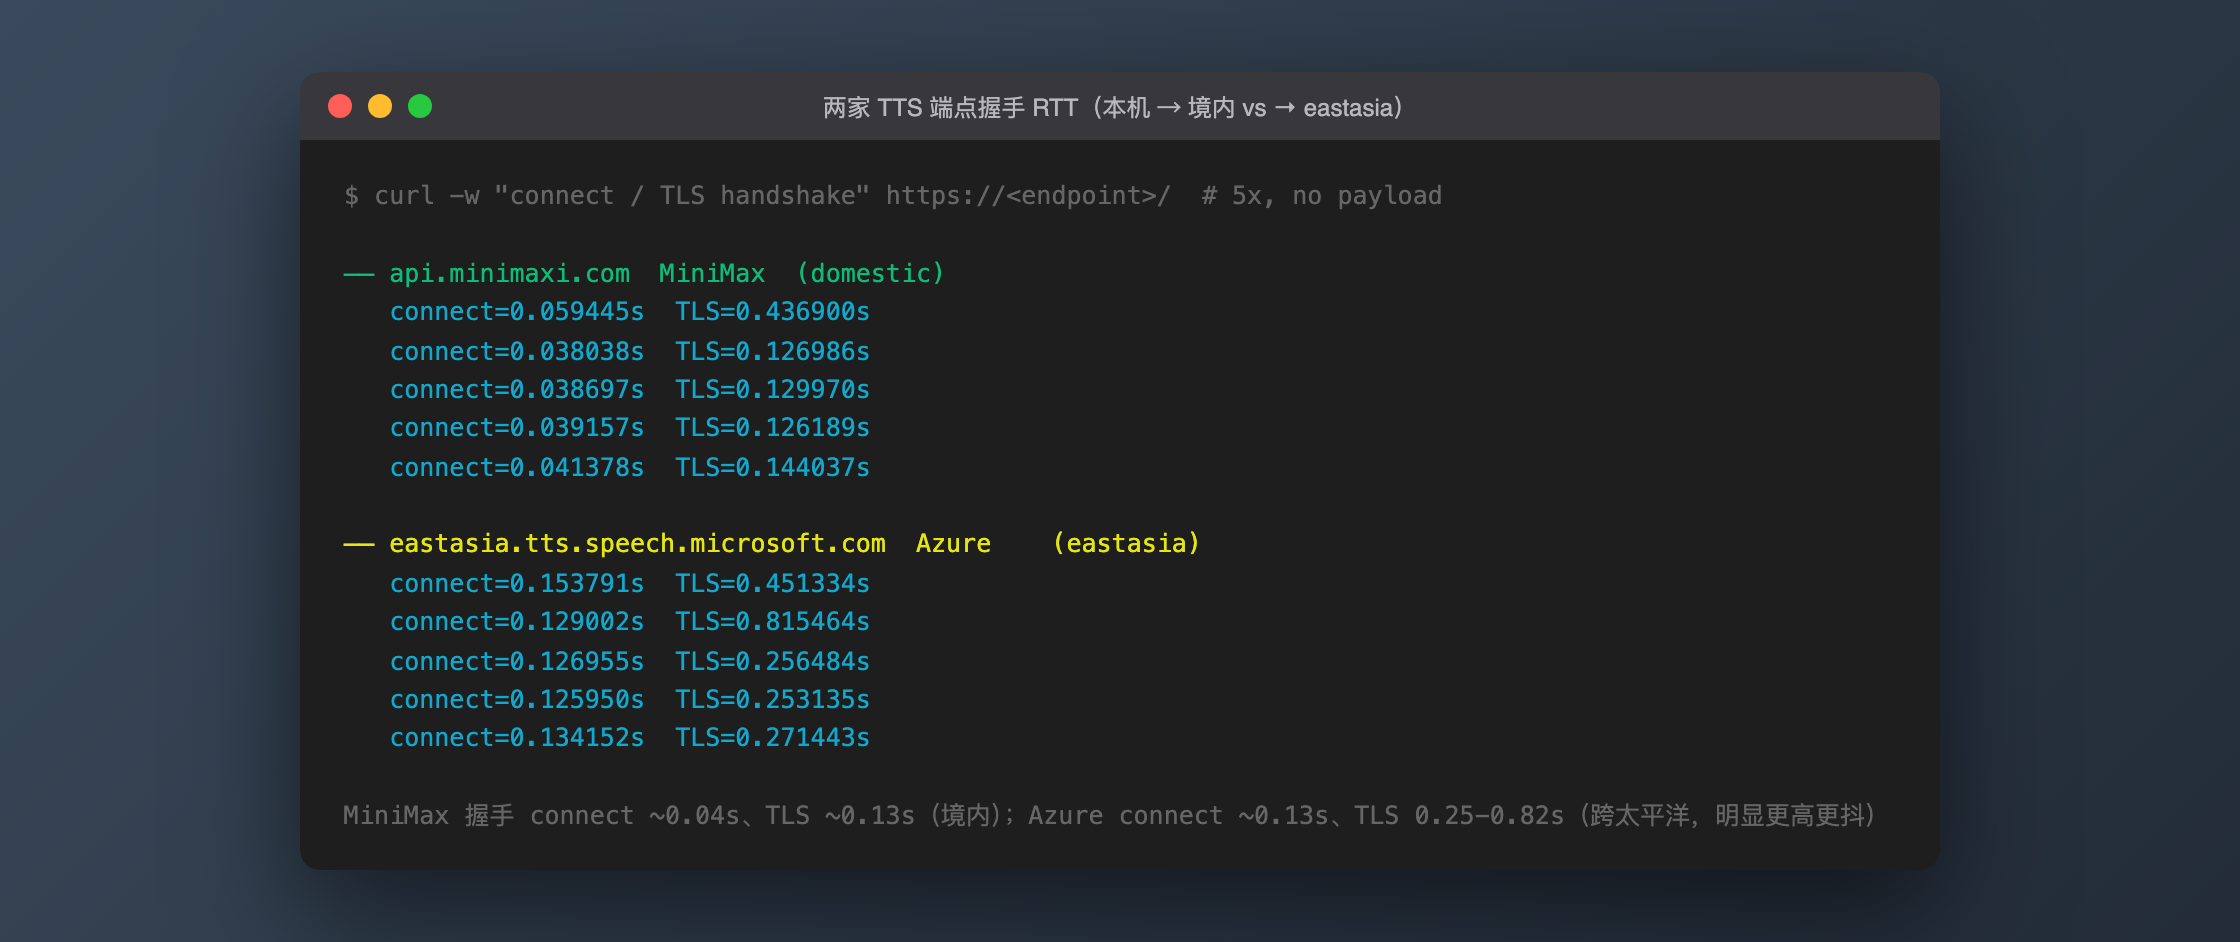
结论清楚:MiniMax 握手 connect ~0.04s、TLS ~0.13s(境内);Azure connect 0.13s、TLS 抖在 0.250.82s(跨太平洋)。 光是建连这一下 Azure 就慢了几百毫秒,而且抖得厉害。这解释了 Azure 长尾的一部分——但注意,网络只是几百毫秒到一秒的量级,撑不起 21 秒的中位数。所以主因还是 Azure Neural 本身的合成节奏接近实时(RTF≈1),网络是叠加在上面的抖动放大器。 两个因素都真实,但模型是主项、网络是尾项。
交叉验证:波形对齐,确认不是"用短音频比长音频"
延迟能比,前提是两家合成的音频真的等长、格式真的一致,否则就是拿苹果比橙子。我把同一句中文在两家的输出波形叠一起看:
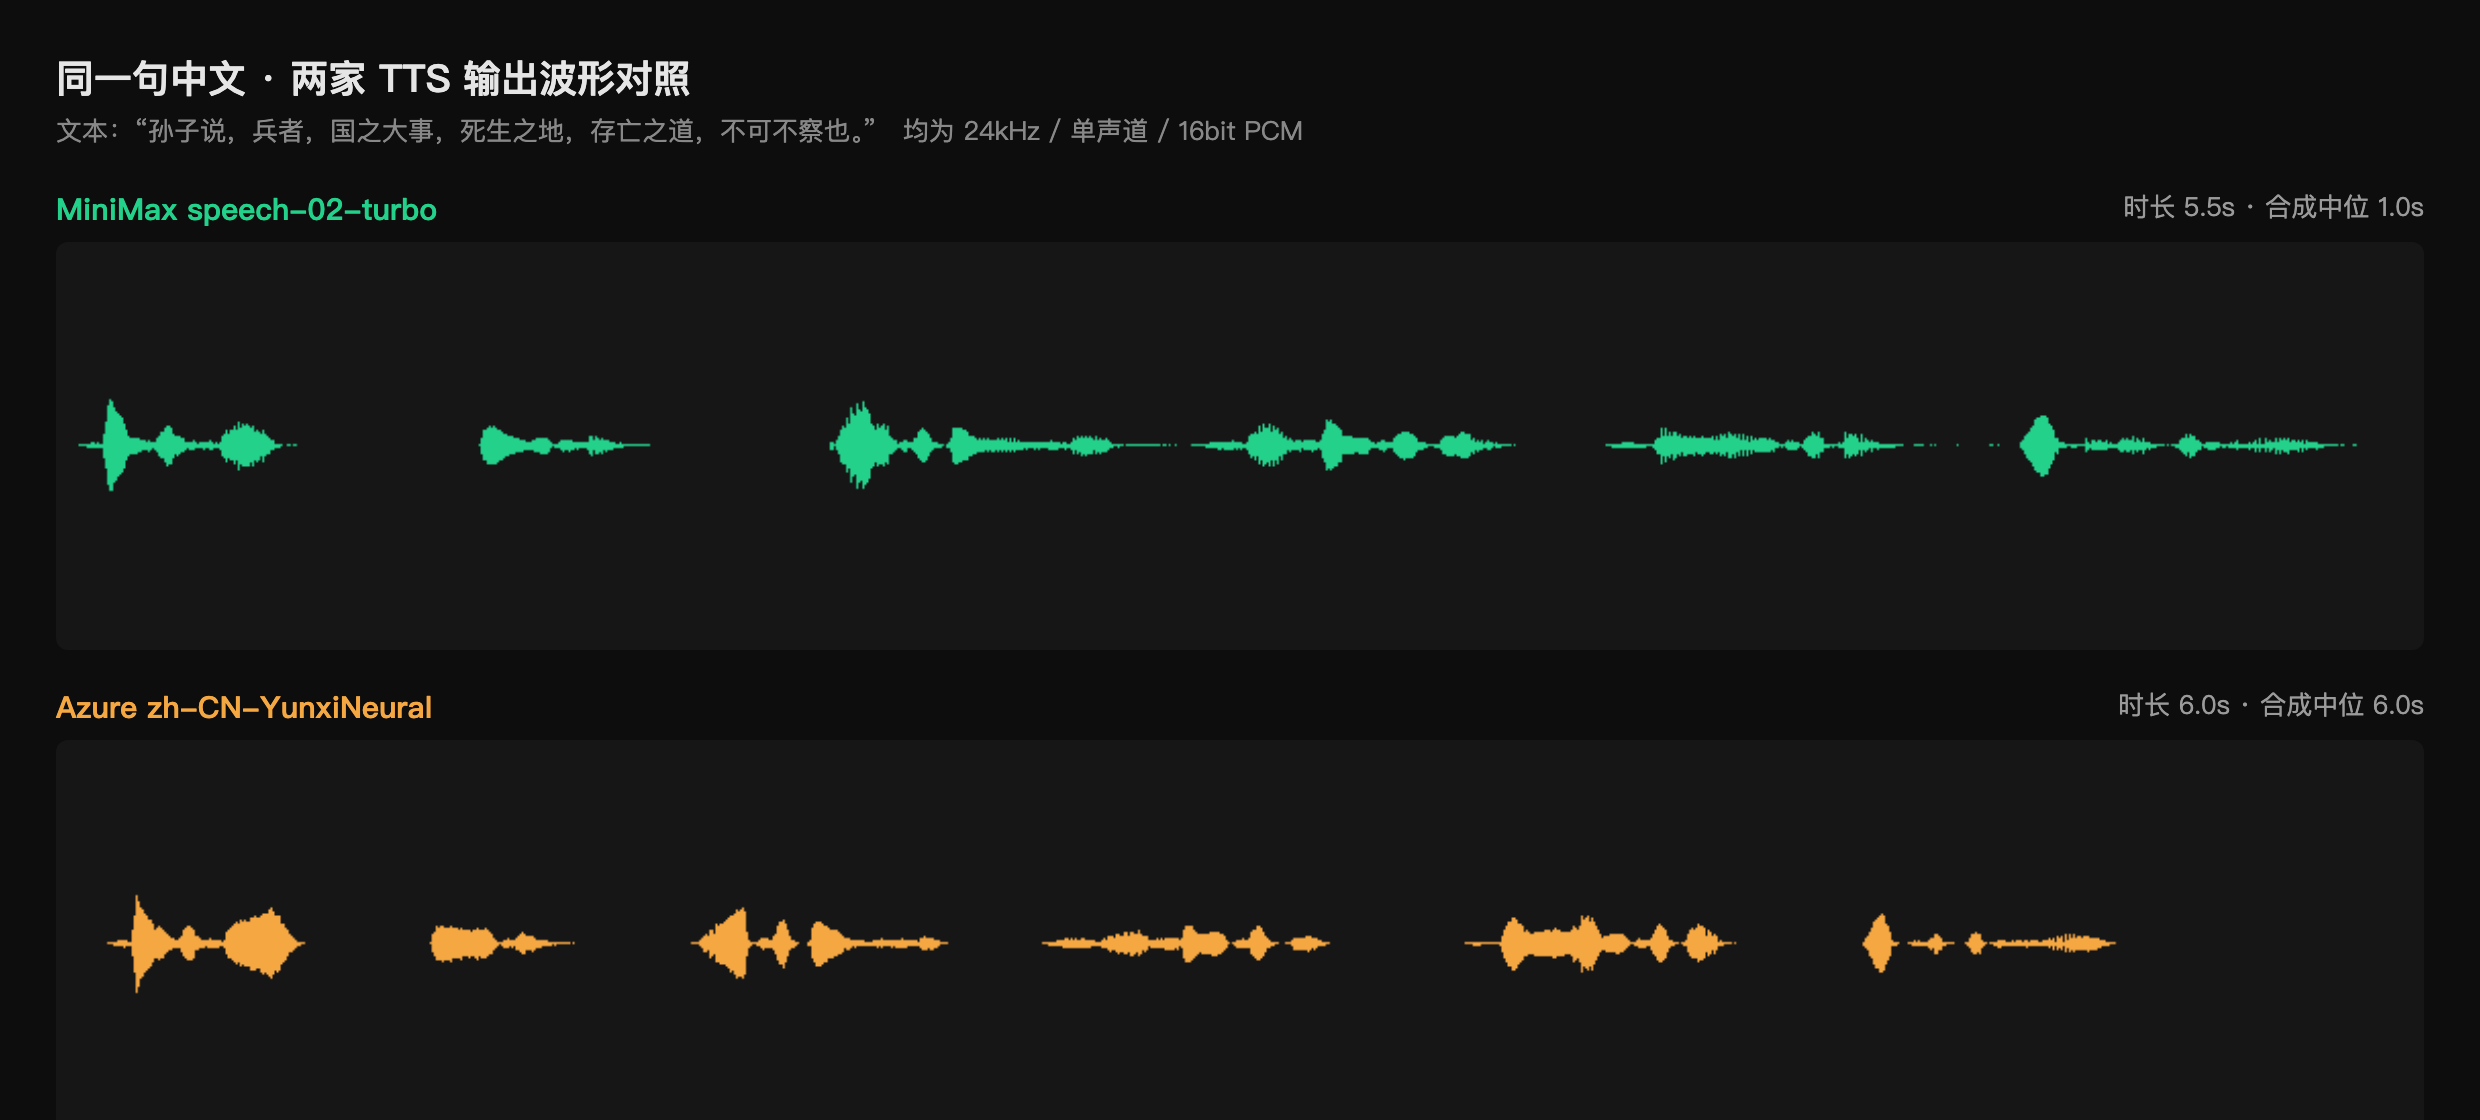
同一句话,MiniMax 输出 5.5 秒、Azure 6.0 秒,时长接近、包络形态相似,采样率声道位深完全一致。这确认了上面的延迟对比是公平的——不是某家偷偷合成了更短的音频来占便宜。
实践效果:对我这条流水线意味着什么
把中位数摊到真实场景:一集视频十几段旁白串行合成,MiniMax 全程约十几秒到二十秒就能出全部音频;同样的量给 Azure,光合成就要 两三分钟起步,赶上长尾能拖到五分钟。对批处理流水线,这是"敲完命令等一下"和"敲完命令去干别的"的区别。
所以工厂的默认 TTS_PROVIDER 一直是 MiniMax,这次实测把这个默认从"感觉对"变成了"有据可依"。
但这不等于 Azure 一无是处,它的价值在两个我这次没测的维度上:
- 音色矩阵。Azure Neural 的多语言、多音色覆盖是工业级的,
YunxiNeural这类音色的稳定度和 SSML 精细控制(停顿、语速、情感)是 MiniMax 目前给不到的。追求特定音色质感时,慢一点也得忍。 - 计费与合规。Azure 标准 Neural TTS 是 每 100 万字符 $16、每月前 50 万字符免费(官方定价,我用的量长期落在免费额度内,成本实质为零)。MiniMax 境内计费口径这半年调过几次、且分按 token 与按字符两种,我拿不到当前权威单价,这里只给能确认的量级——两家在我的用量下成本都不构成决策因素,真正的分水岭是延迟和音色,不是钱。
一句话选型:批量、追速度、语料常规 → MiniMax;要特定音色质感或企业合规 → 忍住延迟上 Azure。 我的流水线属于前者,所以默认没得选。
踩坑
- 别拿 WAV 字节数当音质指标。 我一开始在表里放了 KB 列,看着 MiniMax 和 Azure 字节数差不多就想写"音质相当"——错。WAV 是无压缩定长 PCM,字节数 = 采样率 × 位深 × 声道 × 时长,跟好不好听一点关系没有,两家格式一致时它必然接近。最后把 KB 列从对比表里删了,换成 RTF 才是有意义的维度。
- 单次延迟没有意义,Azure 尤其。 如果只跑一轮,我可能正好抽中 Azure 的 3.3 秒那次,得出"Azure 也不慢"的错误结论。它的方差大到必须多轮取中位——
zh-long最快最慢差了 8 倍。任何"跑一次就下结论"的 TTS 评测都不可信。 - 归因不能只看总延迟。 总延迟里网络和合成是两回事。不把 RTT 单独抠出来,就会把"Azure 模型接近实时"和"跨太平洋网络抖"混成一个模糊的"Azure 慢",进而做出错误的优化决策(比如以为换机房就能救,其实救不了主项)。
- 实测环境要和生产一致才有效。 这些数字是大陆家宽直连测的——而这恰好就是视频工厂的真实部署环境(跑在国内的 Mac mini 上)。如果你的服务本来就在 Azure 同区机房,跨太平洋这段惩罚不存在,Azure 的长尾会收敛,结论要重测。别把我的数字直接搬到你的机房。