AI 视频的字幕越到后面偏得越多:别再修对齐算法了,问题出在「先生成整段音频」这一步
现象
给耳鸣科普项目做自动化视频:文稿 → TTS 配音 → 素材混剪 → 烧字幕,管线基于 MoneyPrinterTurbo(下称 MPT),TTS 用 MiniMax speech-02-turbo。
第一版产出的视频,字幕前 30 秒和语音严丝合缝,一分钟后开始肉眼可见地慢半拍,到结尾已经错位好几秒。打开生成的 .srt 一看,更离谱:尾部一串字幕条目的时间戳全是 00:00:00——不是慢了,是对齐过程在半路直接断链了。
原方案在做什么
MPT 这类工具的默认做法是三段式:
- 把整篇文稿一次性送 TTS,得到一个几分钟长的音频文件;
- 用 whisper 把这个音频转写回文字,拿到带时间戳的词级结果;
- 把转写结果和原稿做相似度匹配(MPT 里的
correct()),给原稿的每一句找到对应的时间区间,生成 srt。
逻辑上说得通:TTS 不返回时间戳,那就用语音识别把时间戳「找回来」。
断链的直接原因
中文文稿里写的是「4000 赫兹」,whisper 转写出来是「四千赫兹」;原稿有书名号、破折号,转写没有;语气词、停顿处的标点也对不上。相似度匹配靠的是两段文字长得像,数字和标点的系统性差异会让相似度骤降——匹配器在某一句上找不到足够像的候选,锚点一丢,后面整段都跟着失锚,最后退化成 00:00:00 的兜底值。
第一反应自然是修匹配:把数字归一化成同一种写法、剥掉标点再比、把相似度阈值调松一点。改完这一版,断链消失了,但慢性漂移还在——因为漂移和断链根本不是同一个问题。
真正的根因:时序信息走了一条会丢失的路
退一步看这个架构:文稿是唯一的事实来源,音频由它生成,字幕也由它生成。但字幕的时间戳却不是从生成过程里拿的,而是靠「音频 → 转写 → 匹配」重建出来的。这条重建链路上每一环都有误差:
- whisper 的词级时间戳本身有几十到几百毫秒的抖动;
- 转写文本和原稿是两种表示,匹配是概率性的;
- 误差没有任何重置机制,只会沿着时间轴单向累积。
所以「越到后面偏得越多」不是 bug,是这个架构的必然行为。修匹配算法是在给一条结构性漏水的管道打补丁。
解法:让时间戳成为生成的副产品
换成逐句 TTS + 采样级拼接:
- 切句:把文稿切成字幕行粒度的句子。中文按
。!?;和破折号切,超过 24 字的长句在 8–24 字窗口内找逗号再切(保证单行字幕不超屏);英文按句号切,超过 14 个词的在逗号处再切。 - 逐句 TTS:每句单独调 TTS,得到一段独立的 wav。
- 采样级拼接:按顺序把每句的 wav 拼成完整音频,句间插固定 200ms 静音。
- 时间戳 = 采样数累加:第 N 句字幕的开始时间,就是前 N-1 句的真实采样数总和(加上静音)除以采样率。
关键性质:字幕行 = TTS 行 = 校准单元。每一句的时长来自它自己那段 wav 的真实采样数,不是估算、不是识别、不是匹配。就算某一句的时长和预期有出入,误差也只影响这一句内部——下一句的起点重新由真实数据决定,句边界天然是校准点,误差在物理上无法跨句累积。整条「转写 + 匹配」链路直接删掉了。
顺手的工程收益:每句 TTS 结果按文本 hash 落盘缓存。断点续跑零成本;改了文稿里的一句话,只有那一句会重新请求 TTS,其余全部命中缓存。
适用边界
- 韵律:逐句合成会损失一点跨句的语气连贯性,句间停顿是固定 200ms 而非自然停顿。对科普解说这类内容完全可接受;对话体、朗诵体要求高的话可以按段落分组调 gap。
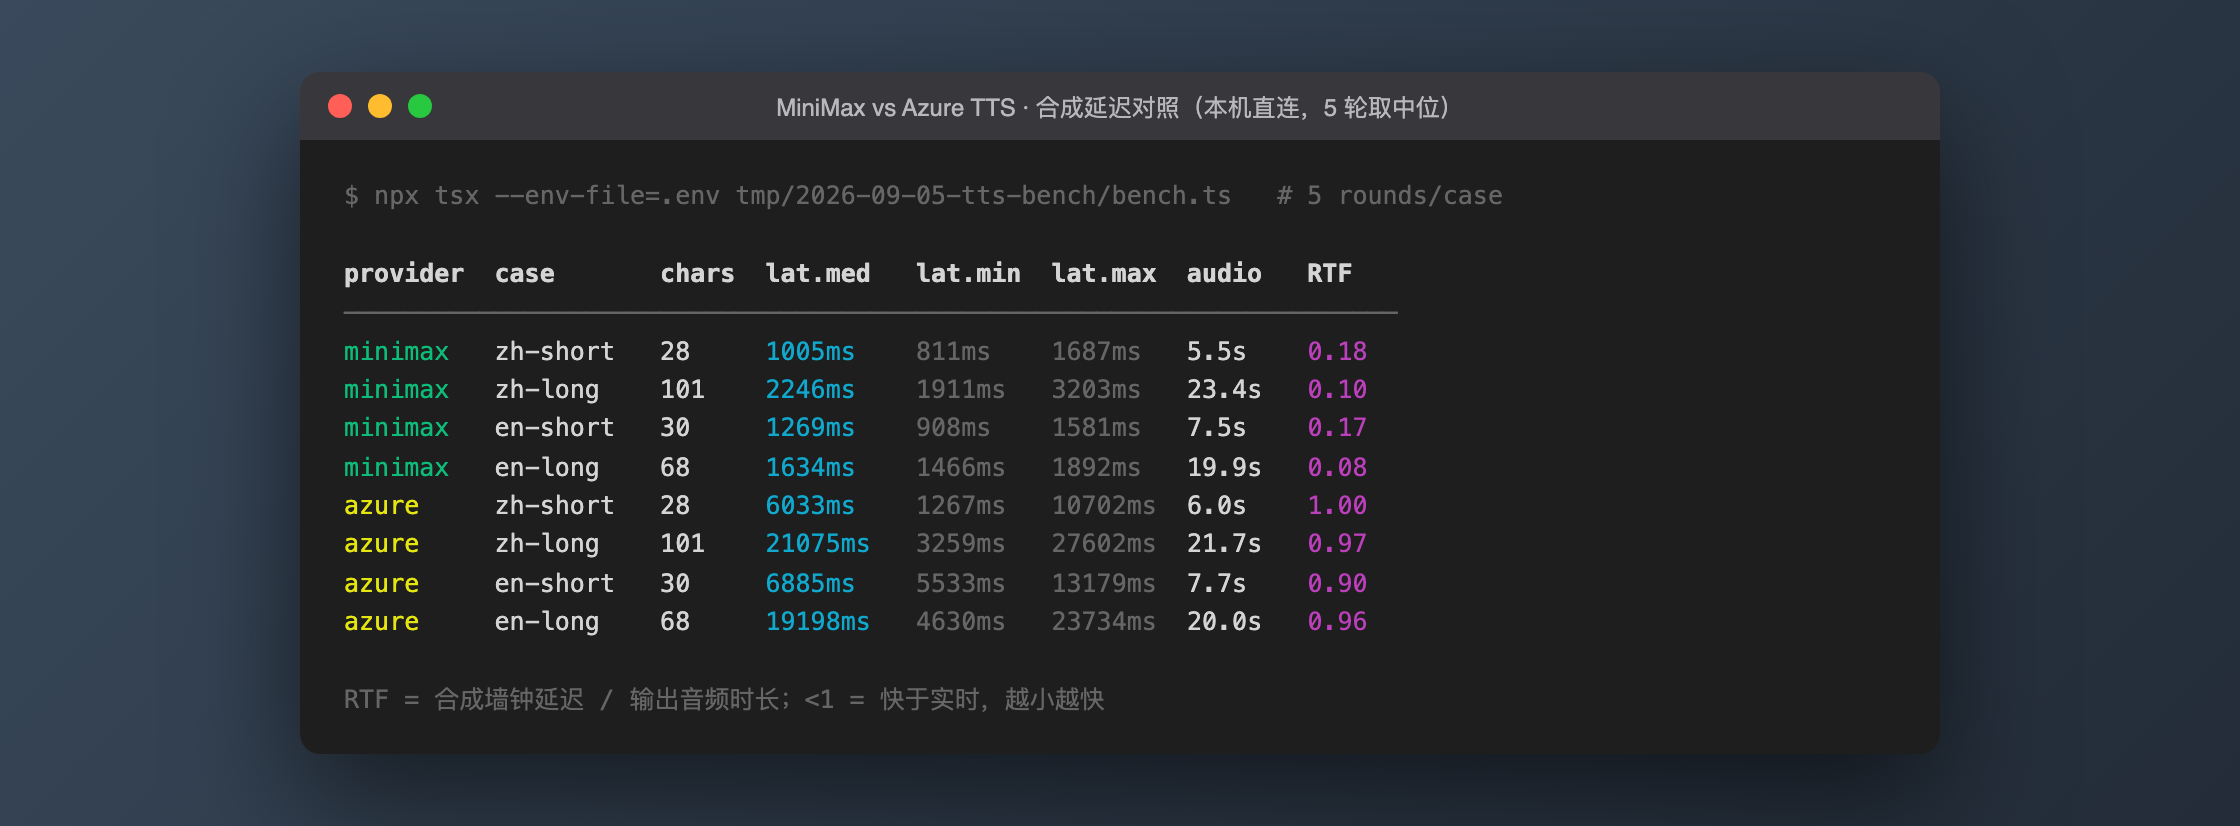
- 请求数:一支视频从 1 次 TTS 调用变成几十次。hash 缓存把重试成本压到接近零,但如果你的 TTS 按调用次数计费且无缓存,要算一下账。
- 不适用的情况:音频不是你生成的(比如给真人录音配字幕),那确实只能走识别对齐的路——本文的前提是音频和字幕同源。
带走的教训
两个产物需要严格同步时,别让它们各自独立生成再事后对齐——让同步信息成为生成过程的副产品。「先做完、再想办法对上」的方案,误差没有重置点,规模一大必然漂移;而「生成时就带着时序」的方案,根本没有对齐这一步可以出错。
这条规律不只适用于字幕:代码和文档、schema 和类型定义、配置和部署清单,凡是「从同一事实来源派生出多个产物」的场景,都优先让派生过程直接携带一致性,而不是产出后靠 diff、匹配、巡检去追赶。