上周教你手写 git worktree,这周发现有人做成了一条命令:worktrunk 实测
上一篇讲用 git worktree 替代 stash,留了个尾巴:node_modules 得重装一遍。worktrunk 是一个 7.4k 星的 Rust 命令行工具,把 worktree 的建、切、列、删、合做成了 wt 一条命令,还顺手把 node_modules 的问题用 APFS 克隆解决了:56,233 个文件 1.7 GiB,3 秒拷完,磁盘一字节不多占。本文在一个真实仓库里跑了一遍,讲清哪几步真被省掉、哪个默认行为会把 .env 一起拷走、哪些功能我不会开。
npm install 会改你的 package-lock.json:CI 必须用 npm ci 的 3 个理由
npm install 和 npm ci 的区别,一半人会答成「后者快一点」。真正的区别是:npm install 有权改写 package-lock.json,npm ci 没有。本文用三个真实场景讲清这个差别为什么在 CI 里是致命的——lock 文件被镜像源来回翻转、macOS 生成的 lock 在 Linux 上缺二进制依赖、package.json 手改后 lock 静默失步——以及 yarn、pnpm 对应的命令是什么。
改到一半要修线上 bug?别 git stash,用 git worktree 再开一个目录
写到一半被叫去修线上 bug,大多数人的肌肉记忆是 git stash → 切分支 → 修完 → 切回来 → stash pop。这条路每一步都有坑:stash 不带未跟踪文件、pop 会冲突、忘掉的 stash 堆成坟场。git worktree 让同一个仓库同时有两个目录、两个分支,修 bug 在另一个目录里做,主目录一个字节都不动。本文讲清 worktree 的原理、四条常用命令、和 stash 的适用边界,以及 node_modules 怎么办。
CLAUDE.md 不是 README:给 Claude Code 写规则的 5 条硬规矩
很多人把 README 或架构文档整个贴进 CLAUDE.md,结果 Claude Code 该守的规矩不守、不该改的文件乱改。原因是 CLAUDE.md 不是文档,是每一轮对话都常驻上下文的指令。本文给 5 条硬规矩:只写代码里推不出来的东西、越短越管用、硬规则交给 hooks 不靠文字、按层级拆文件、被纠正后当场回写。附一份可直接抄的骨架。
GitHub 原生 Stacked PR 上手教程:gh stack 命令怎么用、怎么合并、老分支怎么转
GitHub 于 2026 年 7 月 30 日把 Stacked PR(堆叠式 PR)做成了原生功能并开启公测:把一个大改动拆成一串互相叠放的小 PR,逐层评审、一键合并整串。本文基于官方 changelog 和 gh-stack 官方文档整理:五分钟上手(init/add/push/submit)、评审与合并规则(能不能只合其中一个?)、已有分支怎么转成 stack、rebase/sync 日常维护,以及是否收费、Windows 能不能用等高频问题。
Claude Code 报错 temporarily unavailable, so auto mode cannot determine the safety of bash 怎么解决
Claude Code auto 模式(自动批准权限模式)弹出「temporarily unavailable, so auto mode cannot determine the safety of bash」?先说结论:不是你的命令危险,是安全判定器(一次额外的模型调用)暂时联不上。本文给出四步处理、模型名×工具名×原因的完整变体速查、Shift+Tab 六种权限模式速查(plan / manual / acceptEdits / dontAsk / auto / bypassPermissions,实测自 v2.1.263),以及「auto 是什么模型」「bash denied by auto mode 是不是同一个问题」这些常见困惑的答案。
24GB Mac mini 能跑多大的本地大模型?内存账、实测速度与提速方案汇总
一台 24GB 统一内存的 Mac mini 到底能跑什么模型?答案是:27B 的 4-bit 量化就是天花板,且我们真的把 Qwen3.8-27B 在 M4 丐版上完整跑通了——峰值内存 19.4GB,投机解码后 11.7-12.2 tok/s。本文汇总这台机器上的全部实测:各参数量级的内存账、速度预期、三条提速路线的真实效果(DFlash 2 / 原生 MTP / MLX vs llama.cpp),以及量化档位怎么选。
大模型量化到底损失多少精度?Q8 到 Q2 一张表说清,附 GGUF 怎么选
4-bit 量化会让模型变笨吗?Q3 还能不能用?本文基于 llama.cpp 官方对 Llama-3-8B 全量化档位的 PPL/KLD 实测数据,把 Q8_0 到 IQ1_S 每一档的精度损失讲清楚,给出'内存装得下的前提下选最高档'的具体选择路径,并回答 Q4 与 Q8 差多少、imatrix 有什么用、1.58-bit 是怎么回事等高频问题。
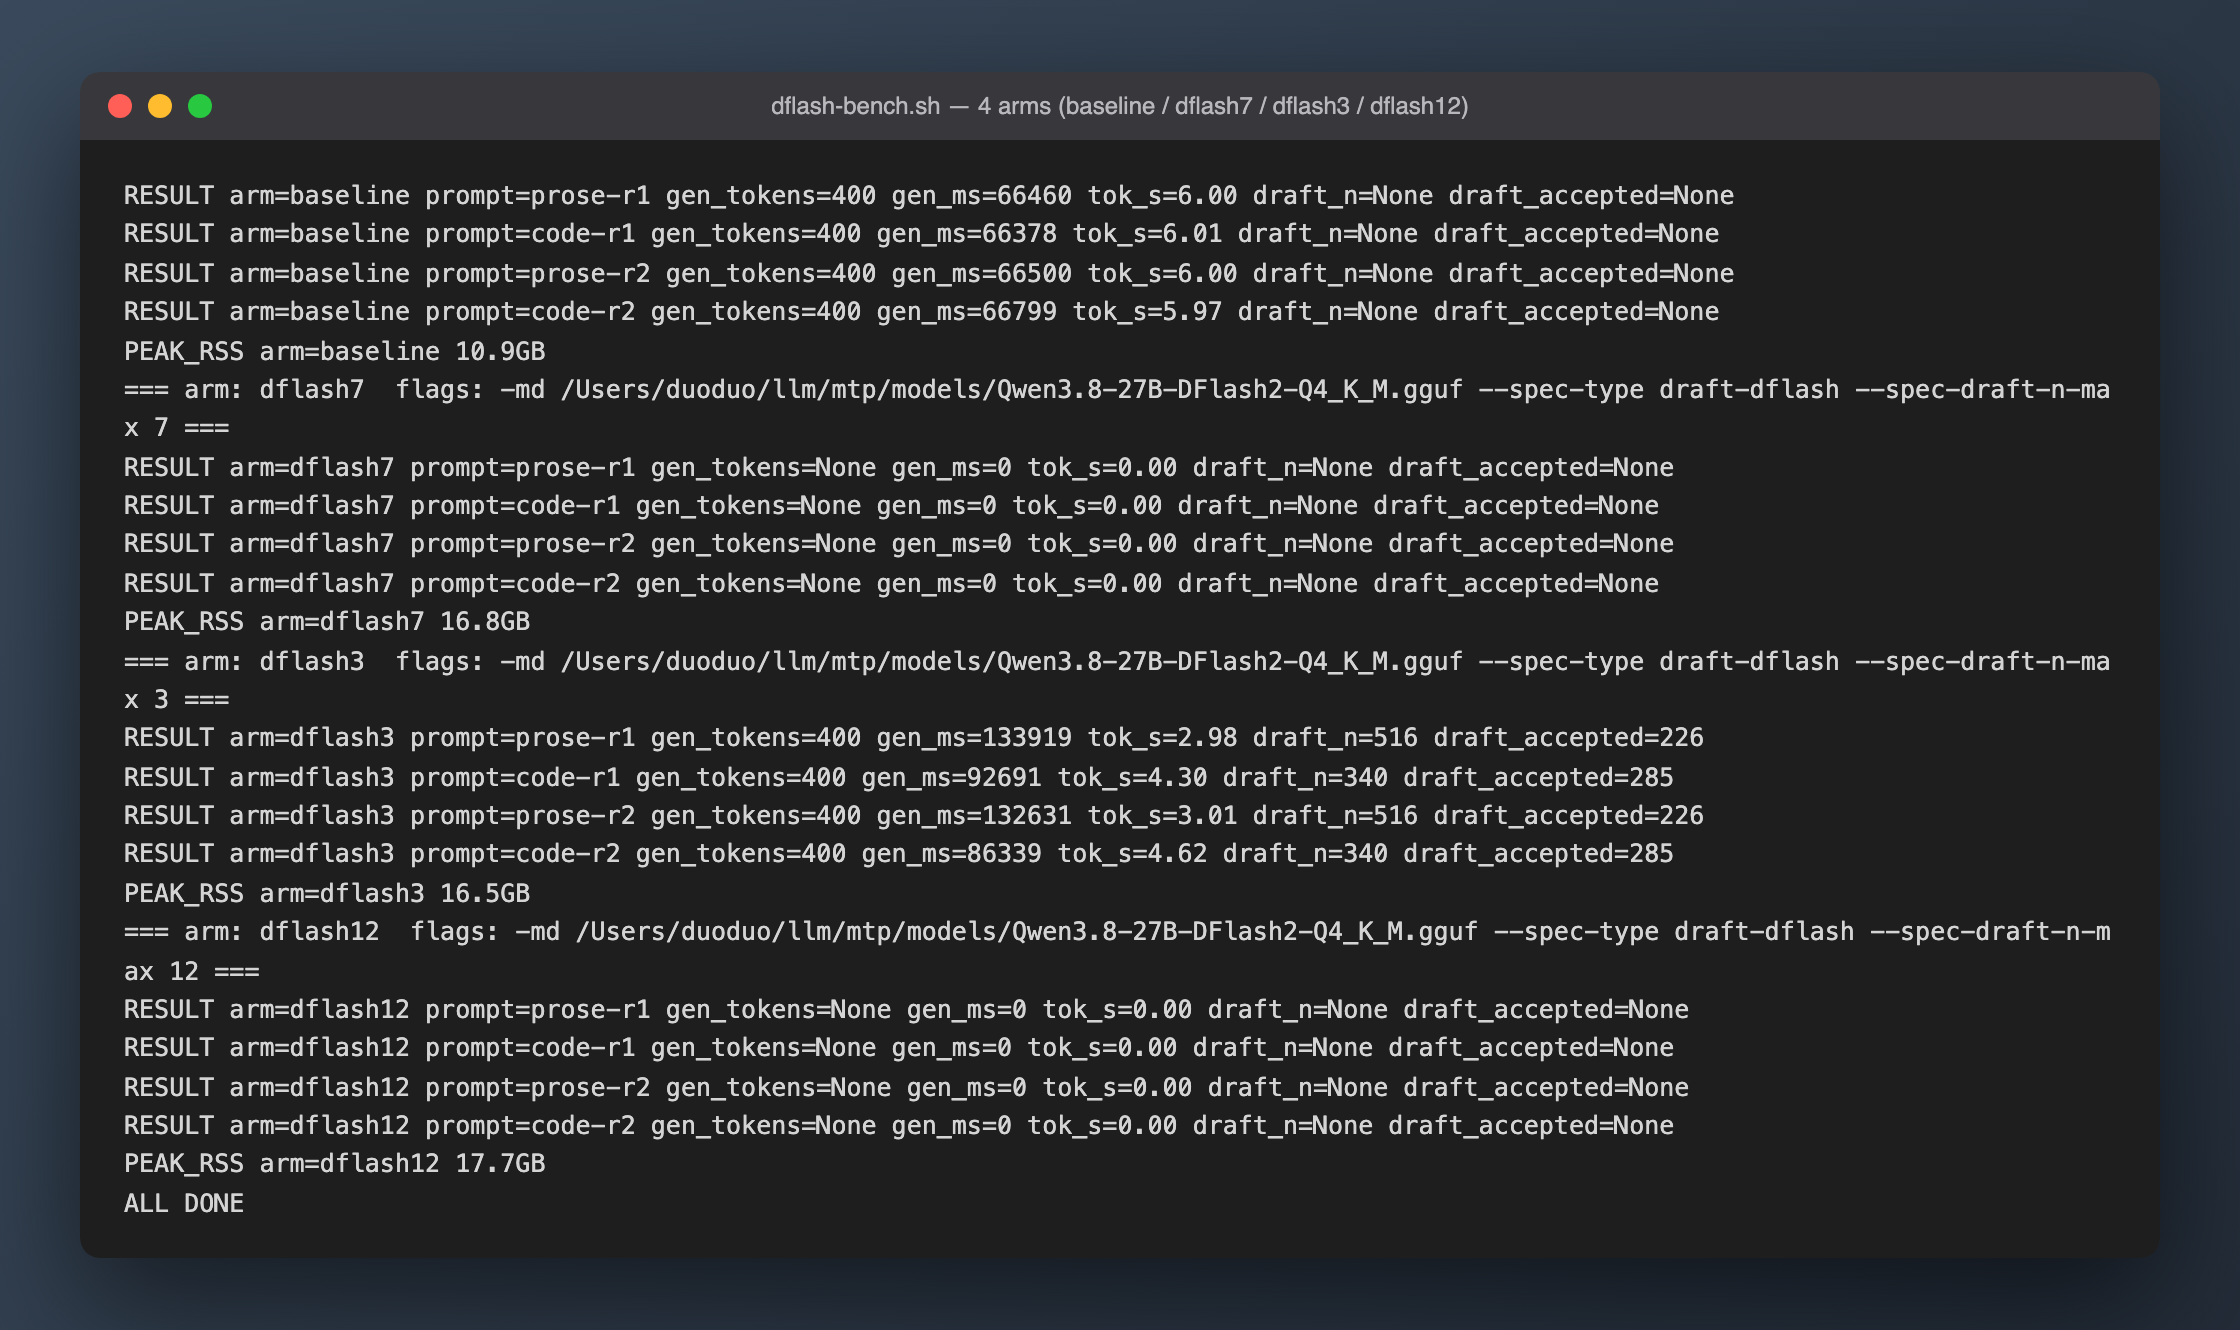
同一台 24G Mac mini、同一个 DFlash 2:MLX 上加速 1.9x,llama.cpp 上减速 50% 还 OOM
投机解码三部曲第三篇。llama.cpp 合并了 DFlash 2 支持、官方还发了配套 GGUF 草稿模型,理论上这是比外挂 MLX 更顺手的路线——实测结果是全配置净减速:官方推荐的 n-max 7 在 24G 机器上可复现 Metal OOM,能跑起来的 n-max 3 散文掉一半(6.0 → 3.0 tok/s),代码接受率高达 83.8% 也还亏 23%。同一个算法、同一台机器,MLX 栈是 1.8–1.9x。用真实数据算清一笔账:这条栈上每个投机步实测均摊 0.77 秒,就算接受率 100% 也追不回本。
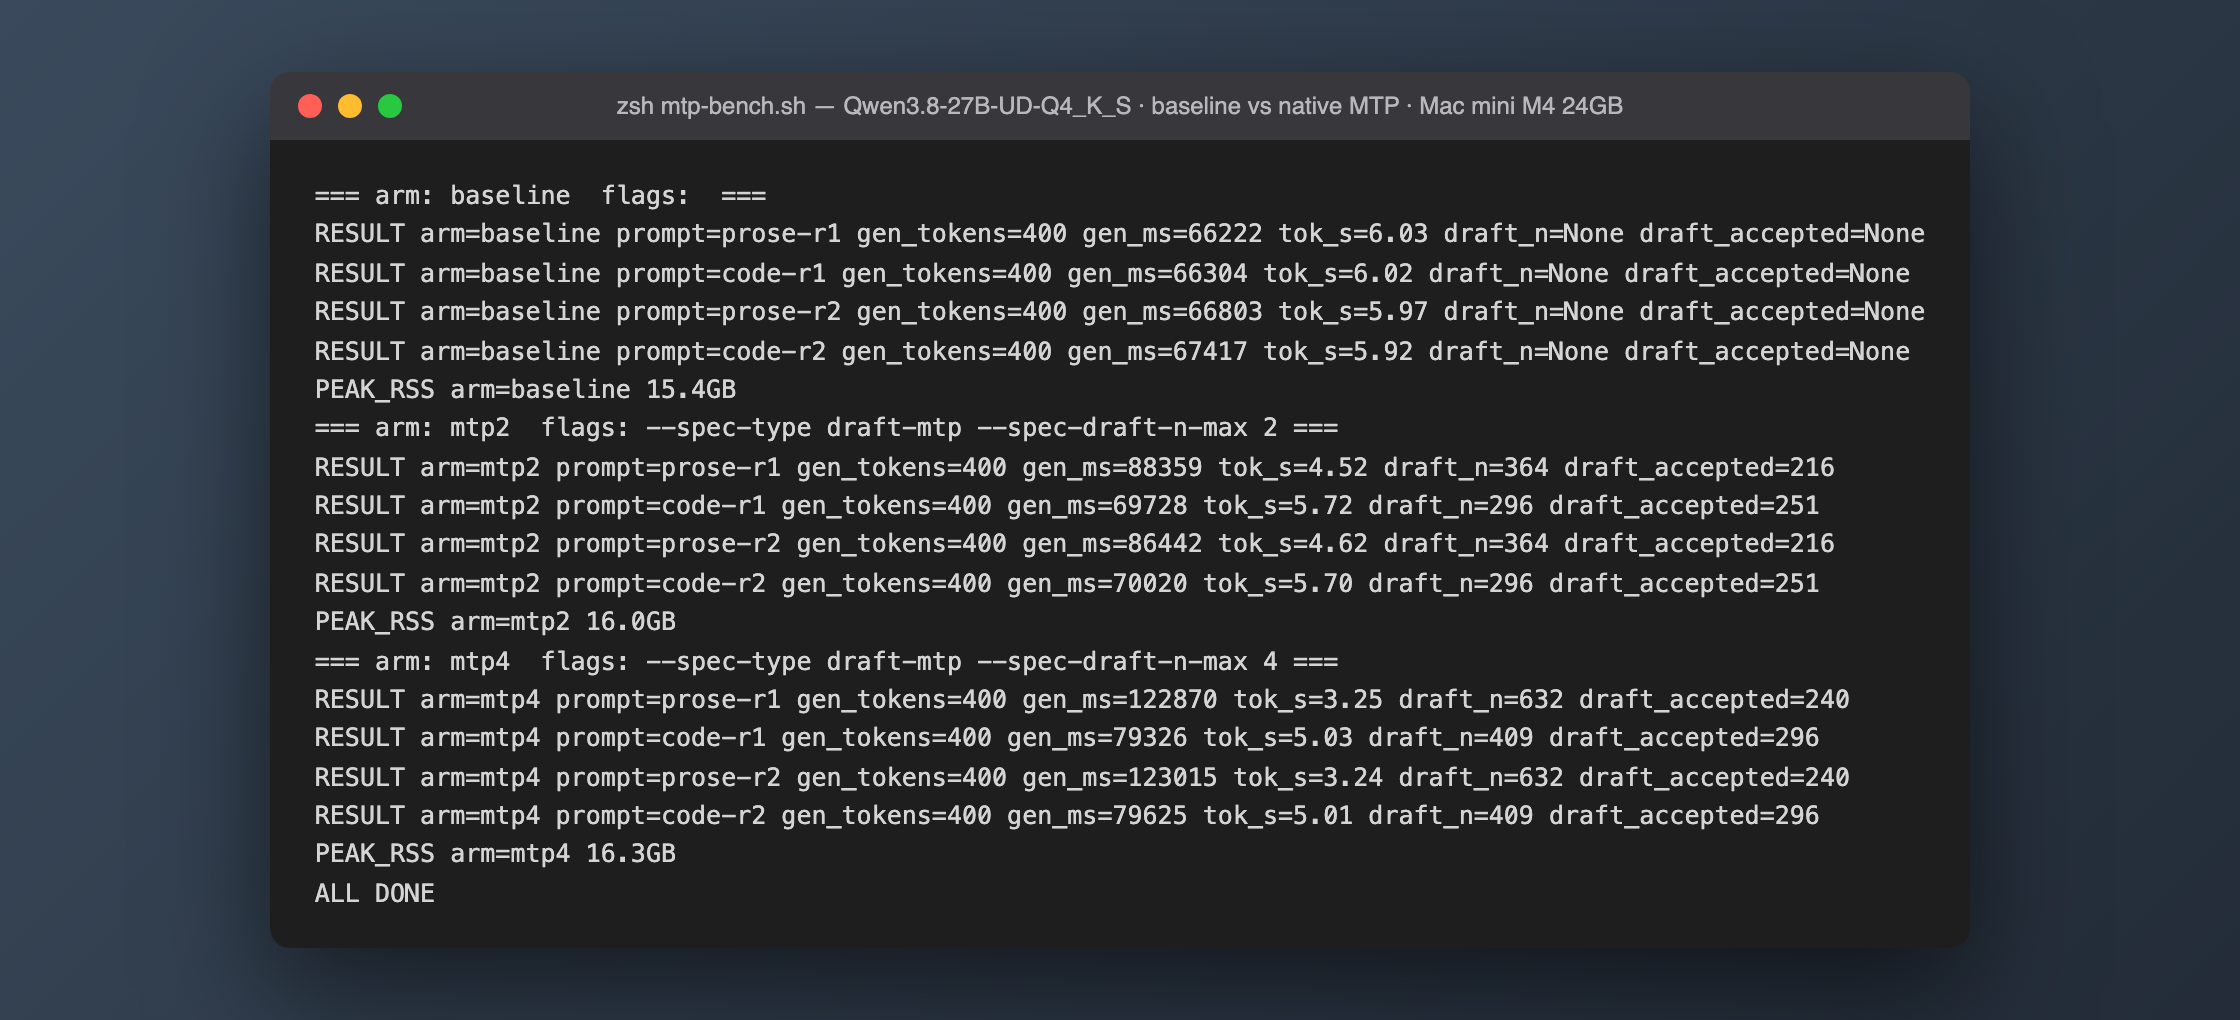
24G Mac mini 实测 Qwen3.8 原生 MTP:内存省了 3GB,速度反而降了 24%——与 DFlash 2 同机对照
上一篇 DFlash 2 实测结尾预告过的路线:Qwen3.8 自带训练好的 MTP 多 token 预测头,llama.cpp 已支持直接挂载,不需要额外 2B 草稿模型。这次在同一台 24G Mac mini M4 上把它跑通并与 DFlash 2 正面对照:内存确实更省(峰值 16.0GB vs 19.4GB),但速度是净减速——散文 6.0 → 4.5 tok/s(-24%),代码也没赚。同机 DFlash 2 是 1.8–1.9x 加速。差距不在草稿质量(接受率 59–85% 很健康),在 Metal 后端:batch 8 解码摊薄实测只有 1.13x,验证 3 行草稿的代价≈3 次完整前向,草稿再准也赚不回来。
PM2 cron_restart 是「先杀再起」:调度进程自杀断更两天的复盘
生产管线连续两天早晨断更:日志停在 07:04,之后所有轮询都打「今天已有记录,跳过」。根因是给每 5 分钟唤醒的调度进程挂了 PM2 cron_restart——它对正在运行的实例是先杀再起,任何一步偶发超过周期就连子进程一起被杀。本文附本机 8 分钟对照复现:cron_restart 组 9 次起跑 0 次跑完,常驻循环组 4 次全部跑完。
GitHub OAuth 登录突然全挂:一次 RFC 9207 灰度撞上 Auth.js 占位 issuer 的排查实录
某天 GitHub 登录突然回调报 error=Configuration,两台服务器同时挂,而当天恰好上线了数据库读写分离——第一反应当然是怀疑部署。本文复盘如何用依赖 lock diff + 数据库最后成功登录时间排除部署嫌疑,定位到真正根因:GitHub 2026 年 4 月起分批灰度 RFC 9207(回调注入 iss 参数),撞上 Auth.js 给无 issuer provider 用的占位符校验。修复只有一行,但排查方法和「探针验证法」值得留档。