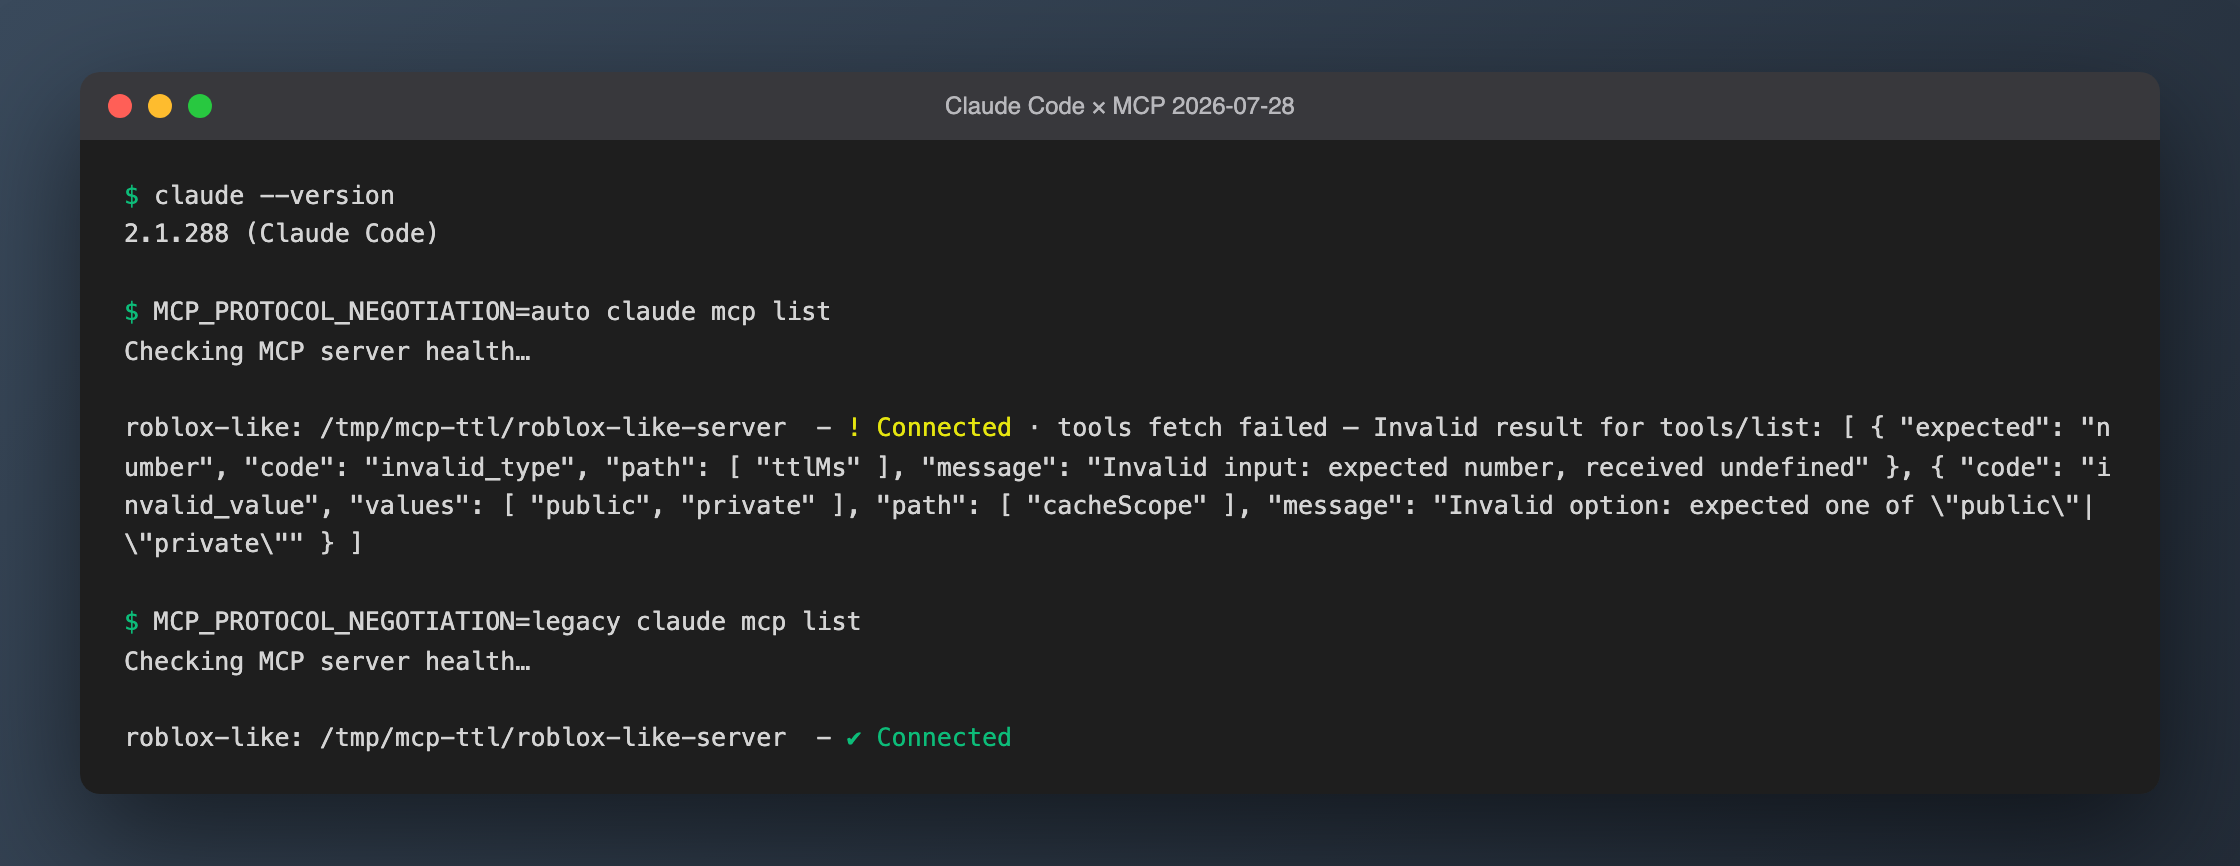
Claude Code 接 DeepSeek / GLM / Kimi 开 auto 模式:temporarily unavailable 括号里的原因怎么看,哪些重试没用(故障注入实测)
先回答你搜的问题
- 报错里的模型名为什么是
glm-5.3/deepseek-v4-pro/k3:auto 模式每执行一个有副作用的动作(Bash、写文件等),都会用你的会话模型额外发一次「安全判定」请求,发到你配置的同一个后端。报错里的名字就是这个判定器,也就是你自己的会话模型。- 先看括号:
(server error)、(rate-limited)、(overloaded)、(connection failed)是后端临时出问题,Claude Code 已经自动试了 5 次;(timed out)是判定请求 60 秒内没返回。- 没有括号最要紧:说明后端直接拒收了判定请求(4xx),Claude Code 只试 1 次,重试多少遍结果都一样,要去查后端配置。
- 报
Auto mode could not evaluate this action:后端返回了,但模型没按格式给出判定。连续 3 次后,auto 模式会退回人工确认。- 想单独给判定器换个模型:实测做不到。
CLAUDE_CODE_AUTO_MODE_MODEL在 2.1.285 不生效,要换只能换会话模型。
问题背景
《temporarily unavailable, so auto mode cannot determine the safety of bash 怎么解决》是本站最近 28 天搜索流量最高的一篇。看 Bing 带来的搜索词会发现,相当一部分报错里的模型名不是 Claude,而是 glm-5.3、glm5.2、glm-5.3-flash、claude-glm-5.3,还有带 cc switch 前缀的。也就是说,很多人是通过 cc-switch、claude-code-router 之类的工具,把 Claude Code 接到智谱、Kimi、DeepSeek 等第三方后端后撞上这个报错的。
那篇文章对这类场景只写了一句「换健康的后端」。这类用户真正想知道的是:
- 第三方模型到底能不能跑 auto 模式?判定请求长什么样,要花多少钱?
- 括号里那几种原因各对应什么故障?哪些等一等就好,哪些怎么重试都没用?
- 能不能只给判定器换一个更快、更便宜的模型?
问题分析
先把机制讲清楚。auto 模式的思路是用一次模型调用代替人工点确认:执行有副作用的动作之前,先让模型判定这个动作安不安全(详见《抓包拆开 Claude Code auto 模式的判定器》)。
这次实测发现,2.1.285 的判定其实分两条路。调试日志里写得很明白,接第三方后端时,第一次判定就会出现这三行:
[server-classifier] the platform gave no classification for this request (server_no_result); treating that as this deployment's answer: auto mode classifies locally for the rest of this session and stops sending the classifier context
[server-classifier] Bash: no server verdict for this call (server_no_result); the local classifier decides it
[server-classifier] auto mode fell back to billed classifier requests; no dialog surface to warn on, continuing in auto mode
意思是:Claude Code 先看平台有没有在服务端给出判定结果,第三方后端当然不会给(server_no_result),于是本会话剩下的时间都改用本地判定,也就是日志里说的「billed classifier requests」:每个需要判定的动作,单独向你的后端发一次计费请求。第三方用户看到的这条报错,全部来自这条本地判定链路。
用 2.1.285 的源码对照,括号里的原因由一个函数根据 HTTP 状态码和错误类型拼出来:
if(e===429)return" (rate-limited)";
if(e===529)return" (overloaded)";
if(e!==void 0&&e>=500&&e<600)return" (server error)";
if(n==="wall_clock_timeout"||n==="connection_timeout"||...)return" (timed out)";
if(n==="connection_error")return" (connection failed)";
源码只能说明「理论上会怎样」。重试几次、等多久、模型收到报错后会怎么做,必须实际跑出来才知道。
技术方案与选型
做法:在 Claude Code 和真实后端之间放一个故障注入代理。 Claude Code 的 ANTHROPIC_BASE_URL 指向本地代理;主循环请求原样转发给真实后端,判定请求(系统提示词以 You are a security monitor for autonomous AI coding agents 开头)按用例改成返回 500、429、挂起、断连等。这样主循环是真模型在跑,故障只落在判定器上。
真实后端选 DeepSeek 和 MiMo。 两家都提供 Anthropic 兼容接口(/anthropic),本机有 key,跑起来成本很低。没有选 GLM,因为手上没有智谱的 key。 不过上面那段源码不区分后端,报错原文的拼法对所有第三方后端都一样,后端之间的差别只在「哪种故障出现得多」。文中提到 GLM 的地方都是基于这一点的推断,没有拿 GLM 实测。
隔离方式: env -i 加每次全新的空 CLAUDE_CONFIG_DIR,Claude Code 手里只有假 key,真 key 由代理注入;HTTPS_PROXY 也指向代理,所有外连(实测是 api.anthropic.com)一律拦截。工作目录放在 /tmp 下。
排除项:
- 只用 stub、不接真实后端:拿不到真实的判定延迟、token 用量和缓存表现,而这正是第三方用户最关心的。
- 在仓库目录里跑:第一轮就踩了这个坑,见文末「踩坑」。
被测动作统一是一条需要判定的 Bash:mkdir -p /tmp/automode-lab-out && python3 -c "print(6*7)" > ...。最初用的 echo hello > out.txt 写的是当前目录,日志显示 Skipping auto mode classifier for Bash: would be allowed in acceptEdits mode,根本不走判定器。
实测过程
1. 第三方模型能跑 auto 模式,判定请求长这样
第三方模型能进 auto 模式。DeepSeek 和 MiMo 的门禁日志都是 modelSupported=true … canEnterAuto=true。正常情况下,命令判定为安全后照常执行,代理抓到的判定请求是这样的:
| 字段 | 2.1.285 实测值 |
|---|---|
model |
会话模型本身(deepseek-v4-pro / mimo-v2.5) |
stream |
不流式 |
max_tokens |
2112 |
stop_sequences |
["</block>"] |
thinking |
不传 |
| system | 3 段共 132,470 字符,中间最大的一段 132,144 字符,带 cache_control: ephemeral |
| 期望输出 | <block>no</block> 或 <block>yes</block> |
DeepSeek 返回的是 <block>no 加 stop_reason: stop_sequence。MiMo 不理会 stop_sequences,返回完整的 <block>no</block> 加 end_turn。两家都会附带一段 thinking(请求里并没有开),但判定都解析成功了。
和 8 月用 2.1.241 抓的包相比,判定格式变了:当时是 max_tokens: 64、停在 </severity>、系统提示词 116,879 字符,现在改成了 <block> 二元判定。
2. 每判定一次要花多少 token、多少时间
在同一个会话里连续执行 3 条 Bash(python3 -c "print(1+1)" 等),把主循环和判定器的输入 token 分开统计:
| DeepSeek v4-pro,3 个动作 | 主循环 | 判定器 |
|---|---|---|
| 输入 token 合计(含缓存命中) | 71,407 | 89,043 |
| 其中未命中缓存 | 18,031 | 38,099 |
| 单次判定耗时 | — | 4.45 s / 1.96 s / 1.75 s |
逐次看缓存:第一次判定 29,664 个 token 全部未命中;第二次未命中 8,305、命中 21,376;第三次未命中 130、命中 29,568。会话内的缓存会逐渐热起来,但每个新会话的第一次判定,在我们跑的 DeepSeek 会话里次次都是全额:6 个能读到 usage 的新会话,第一次判定的 cache_read_input_tokens 全是 0。两次会话之间系统提示词逐字相同(已经 diff 过),原因出在后端的缓存策略,客户端这边看不出来。
MiMo 跨会话能命中缓存(从第 2 个会话起,第一次判定就命中 28,672),但慢得多:6 次判定分别是 11.5 s、9.3 s、4.7 s、11.9 s、4.5 s、11.5 s。DeepSeek 的 11 次正常判定在 1.75~4.45 s 之间。
结论:开着 auto 模式时,判定器的输入 token 和主循环同一个量级,甚至更多。 原因是判定器的系统提示词(约 3 万 token)比主循环的系统提示词加工具定义(约 1.76 万 token)还长。用按 token 计费的第三方 API,账单要按这个量级来估。
3. 故障注入:每种失败对应哪条报错
主循环照常转发,只让判定请求失败。下表是模型在工具结果里收到的原文(统一去掉了相同的结尾「Wait a moment and then try this action again. If it keeps failing, continue with other tasks…」),以及每个动作 Claude Code 实际发了几次判定请求:
| 注入的故障 | 报错原文(关键部分) | 每个动作的判定请求数 |
|---|---|---|
| HTTP 500 | deepseek-v4-pro is temporarily unavailable (server error), so auto mode cannot determine the safety of Bash right now. |
5 次(间隔约 0.5 / 0.9 / 1.7 / 3.6 s) |
| HTTP 429 | … temporarily unavailable (rate-limited), so auto mode … |
5 次 |
| HTTP 529 | … temporarily unavailable (overloaded), so auto mode … |
5 次 |
| 连接被重置 | … temporarily unavailable (connection failed), so auto mode … |
5 次 |
| 挂起不回 | … temporarily unavailable (timed out), so auto mode … |
1 次,60 秒后放弃 |
| HTTP 400 | deepseek-v4-pro is temporarily unavailable, so auto mode …(没有括号) |
1 次,不重试 |
| HTTP 404 | 同上,没有括号 | 1 次,不重试 |
| 返回 200,但内容是「好的,这个命令是安全的,可以执行。」 | Auto mode could not evaluate this action and is blocking it for safety — run with --debug for details. This is not a judgment that the action is unsafe. |
10 次(解析失败也会重试) |
返回 200,stop_reason: max_tokens,没有判定 |
同上 | 10 次 |
能直接用来排查的有三点:
- 没有括号 = 后端拒收(4xx)。 Claude Code 把这类错误当成不可恢复,只试一次。旧文里把「无括号」和其他原因归为一类、说处理方式一样,这次实测证明不对,旧文已经改正。对第三方后端来说,常见原因是判定请求里有它不认的东西:模型名不在映射表里、不支持非流式或
stop_sequences、3 万 token 的输入超出了模型上下文。注意这些都是主循环正常而判定器失败的情形,因为两者用的是同一个模型名,但请求形态完全不同(见上一节的表)。 (overloaded)是旧文变体表里没有的。 它对应 529,这次补上了。could not evaluate不是网络问题。 后端好好地返回了,只是模型没有输出<block>yes/no</block>。thinking 模型把 2112 的max_tokens预算全用在思考上,或者模型不按指令格式回答,都会走到这里。
4. 60 秒超时:判定请求最多等一分钟
判定请求挂起不回时,代理记录到客户端在 60,002 ms 和 60,000 ms 断开(两次),只试 1 次就报 (timed out)。另一组让判定请求延迟 45 秒再返回,判定照常通过,命令也执行了。
所以,后端处理 3 万 token 输入要是超过一分钟(比如高峰期排队),每个需要判定的动作都要先卡满 60 秒再报错。
5. 后端给了 retry-after,每个动作会静默等很久
429 并带 retry-after: 30 时,5 次判定请求的间隔精确地是 30 秒(30,009 / 60,019 / 90,029 / 120,039 ms),每个动作要等 2 分钟才报 (rate-limited),在 -p 模式下这段时间没有任何输出。如果你的套餐有并发或频率限制,要记得 auto 模式会让每个动作多出一次请求。
6. could not evaluate 连续 3 次,auto 模式退回人工确认
「temporarily unavailable」和「could not evaluate」还有一个重要区别:后者算作一次拦截。调试日志:
[WARN] Classifier denial limit exceeded, falling back to prompting: 3 consecutive actions were blocked. Please review the transcript before continuing.
退回后,同一条命令收到的变成了 This Bash command contains multiple operations. The following parts require approval: mkdir -p /tmp/automode-lab-out, python3 -c "print(6*7)"。交互模式下这时会弹出人工确认;在 -p 无头模式下没人能点确认,结果就是拒绝。
7. temporarily unavailable 没有熔断,模型会一直重试
「temporarily unavailable」不计入上面的拦截次数。报错文案又让模型「Wait a moment and then try this action again」,DeepSeek v4-pro 的做法是立刻重试:
- 持续 500:400 秒内主循环跑了 38 轮、判定请求发了 185 次,最后被我们的看门狗杀掉;
- 持续 400(不重试、没有退避):100 秒内主循环跑了 44 轮;
- 持续 404:模型重试 6 次后自己放弃,回复「I've retried the command 6 times…」。
模型什么时候放弃,要看模型自己的判断,换个模型结果可能不一样。但可以确定,Claude Code 这一侧对这种情况没有次数上限。判定器故障持续时,主循环会一直在消耗 token。交互模式下看到同一条报错反复刷屏,最好直接按 Esc 打断。
8. 单独换判定器模型:CLAUDE_CODE_AUTO_MODE_MODEL 实测无效
二进制里有一个环境变量叫 CLAUDE_CODE_AUTO_MODE_MODEL,看名字像是能单独指定判定器模型。实测设成 deepseek-flash、会话模型保持 deepseek-v4-pro,判定请求的 model 仍然是 deepseek-v4-pro,日志里也是 classifier_request_started … model=deepseek-v4-pro。从混淆后的源码看,判定器模型的来源依次是:服务端下发的配置(第三方后端拿不到)→ 内置默认映射 → 会话模型。对第三方用户来说,判定器就等于会话模型,要换只能 /model。
实践效果:按报错对号入座
| 你看到的 | 是什么 | 怎么办 |
|---|---|---|
(server error) / (overloaded) / (connection failed) |
后端临时故障,已自动试过 5 次 | 等一会儿再试;持续出现就换后端或换会话模型 |
(rate-limited) |
后端限流 | auto 模式让请求量翻倍,看套餐的并发或频率上限;高峰期可以先切出 auto |
(timed out) |
判定请求超过 60 秒没回 | 后端太慢(3 万 token 输入加排队),换更快的模型或后端 |
| 没有括号 | 后端拒收判定请求(4xx),重试无效 | 查模型名映射,查后端是否支持非流式和 stop_sequences、上下文是否够 3 万 token 以上;claude --debug-file /tmp/cc.log 看 classifier_request_finished 那几行 |
Auto mode could not evaluate this action |
后端返回了,但模型没给出判定 | 换一个能稳定按格式输出的会话模型;连续 3 次后会退回人工确认 |
| 同一条报错反复刷屏 | 模型在自动重试,Claude Code 不设上限 | Esc 打断,按上面几行处理,或者切到 manual / acceptEdits 模式 |
旧文里给官方用户的四步处理(等待重试、先做只读工作、换会话模型、退出 auto 模式)对第三方用户同样适用。这次多出来的是第一列:先看括号,再决定要不要重试。
踩坑
- 工作目录放在仓库里,项目设置被加载进来了。 第一轮把 Claude Code 的工作目录放在
tmp/…/runs/r1/work,调试日志里出现了Applying permission update: Adding 22 allow rule(s)。它沿目录往上找到了仓库的.claude/settings.local.json,还把其中的Bash(npm run *)当作危险规则剔除了(Ignoring dangerous permission … (bypasses classifier))。文件本身没有被改(mtime 没变),但实验环境已经不干净。后来工作目录统一放到/tmp。 - 被测命令被 acceptEdits 规则直接放行。 写当前目录的
echo hello > out.txt根本不走判定器,要换成写/tmp加执行 python 的命令才会触发判定。 - 代理透传了 accept-encoding,看不到响应内容。 第一次转发时上游返回的是 gzip,代理解析不出 usage。去掉这个请求头后才拿到明文。
source .env会执行 cron 表达式。 项目.env里有X_CRON=*/5 * * * *这样不加引号的值,source时*会被 shell 展开成文件名,再当作命令执行。这次没有造成影响,之后改成用grep只取需要的 key。