拿 DeepSeek 当 Claude Code 后端:功能全通,但成本显示虚高 38 倍
DeepSeek 的 API 支持 Anthropic 格式,端点是 https://api.deepseek.com/anthropic。三个环境变量,Claude Code 就转去调 DeepSeek 了。
教你设这三个变量的文章有的是,讲什么会退化的几乎没有。而这才是唯一值得问的问题——Agent 编程工具不是聊天框,它的命脉在工具调用、多轮状态,以及屏幕上那些数字到底有没有意义。
所以我跑了一遍。Claude Code 2.1.270,macOS,独立配置目录不碰真实环境。下文 Claude Code 的跑测全部打向 deepseek-v4-pro;deepseek-flash 出现在裸端点的映射测试和 Haiku 槽位里。
先给结论:功能没问题,成本显示有问题。 Claude Code 告诉我花了 $1.71,DeepSeek 实际扣了 ¥0.32。
背景:为什么有人要这么接
两个原因,方向还不太一样。
无聊的那个是价格。DeepSeek V4 Pro 的输入价是峰时 $1.32 / 1M token、谷时 $0.66,和 Claude 的百万单价不在一个档。而 Claude Code 每一轮都要重发一大坨系统提示词,这个比例会被放得很大。
有意思的那个是:Claude Code 目前是被广泛使用的 Agent 框架里最能打的一个,而框架恰恰是你没法轻易自己造的部分。保留框架、换掉底下的引擎,如果换得干净,价值很实在。
换得干不干净是个实证问题,所以有了下面的测量。
测了什么,以及故意没测什么
测了:连通性、模型名映射、本地工具矩阵、子代理派生、跨轮 prompt 缓存,以及按真实账户余额算的实际花费。
没测(以及为什么):
- MCP 服务器。DeepSeek 的兼容性表里把 API 的
mcp_servers字段标为 Ignored,但那个字段指的是 Anthropic 的服务端 MCP。Claude Code 的 MCP 走本地 stdio,根本不碰这个字段。测 API 字段证明不了你实际在用的东西,而认真测本地 MCP 够单开一篇。 - 1M 长上下文行为。DeepSeek 标称 1M 上下文,Claude Code 报告该模型
contextWindow: 200000。到底谁说了算需要专门的填充实验,我不打算靠一个元数据字段猜。 - 视觉。价格页写明 v4-pro 不支持 vision、flash 支持。我没测图片输入。
以下全部在同一台机器、2026-09-20 当天跑出,原始日志留存。
配置
起作用的就三个变量:
export ANTHROPIC_BASE_URL="https://api.deepseek.com/anthropic"
export ANTHROPIC_AUTH_TOKEN="$DEEPSEEK_API_KEY"   # 不是 ANTHROPIC_API_KEY
unset ANTHROPIC_API_KEY
export ANTHROPIC_MODEL="deepseek-v4-pro"
要用 ANTHROPIC_AUTH_TOKEN 而不是 ANTHROPIC_API_KEY——两个都设 Claude Code 会弹冲突提示。我还把整个实验塞进一次性的 CLAUDE_CONFIG_DIR 和临时工作目录,保证碰不到真实项目:
export CLAUDE_CONFIG_DIR="$PWD/cc-config"
先建 ground truth:这个端点到底怎么行为
动 Claude Code 之前先打裸端点。映射层要是有意外,上面那层全是猜。
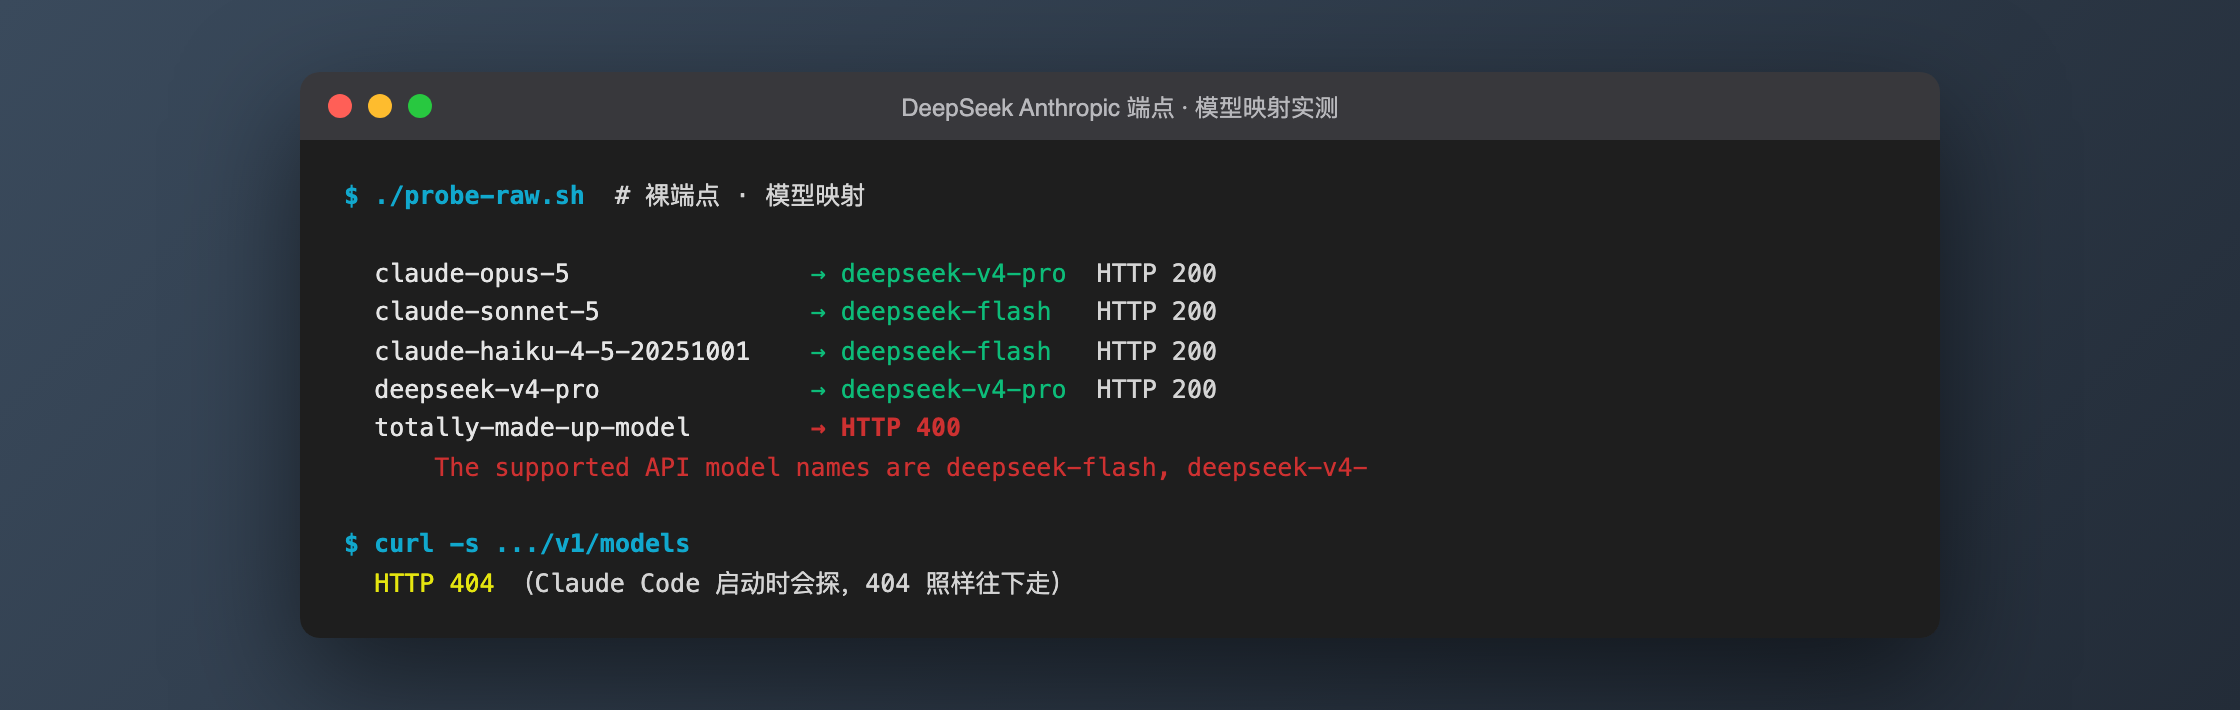
模型映射只认前缀——而且文档关于回落的说法是错的
| 传入的 model | 实际返回的 model | 耗时 |
|---|---|---|
claude-opus-5 |
deepseek-v4-pro |
3.20s |
claude-sonnet-5 |
deepseek-flash |
1.03s |
claude-haiku-4-5-20251001 |
deepseek-flash |
1.32s |
deepseek-v4-pro |
deepseek-v4-pro |
1.97s |
deepseek-flash |
deepseek-flash |
1.44s |
totally-made-up-model |
HTTP 400 | 0.38s |
claude-opus* → v4-pro、claude-sonnet*/claude-haiku* → flash,和文档一致。
最后一行不一致。文档写的是:
When you pass an unsupported model name to DeepSeek's Anthropic API, the API backend will automatically map it to the
deepseek-flashmodel.
实际不会,直接 400:
{"error":{"message":"The supported API model names are deepseek-flash, deepseek-v4-pro, but you passed totally-made-up-model.","type":"invalid_request_error"}}
所以真实规则是:claude-* 前缀会映射,其余必须是 DeepSeek 的精确模型名,否则 400。 如果你在脚本里动态选模型,别依赖文档说的那个回落。
v4-pro 默认就返回 thinking 块
max_tokens: 64 时回复看着是空的。其实不是,预算被推理吃了:
"content": [
  { "type": "thinking", "thinking": "We need answer user asks \"Say OK.\" ...", "signature": "4b525c96-..." },
  { "type": "text", "text": "OK" }
]
按 DeepSeek 价格页,两个模型的思考模式都默认开启。如果你在这个端点上自己写轻客户端,max_tokens 要把推理算进去,否则会做出一个「短回答返回空」的 bug。(Claude Code 处理得正确,这条坑的是自建集成。)
/v1/models 404,但无害
GET /v1/models?limit=1000  -> HTTP 404
GET /v1/models             -> HTTP 404
Claude Code 启动时会探一次,404 照样往下走。纯噪声。
工具矩阵:全部正常
这部分本来最可能出事,结果没出。每一行是一次在临时目录里的 claude -p,而且我核验的是磁盘上的副作用,不是模型自称成功。
| 用例 | 轮数 | 输入 | 缓存读 | 输出 | 耗时 | 返回 | 副作用核验 |
|---|---|---|---|---|---|---|---|
| 读文件 | 2 | 34,186 | 34,176 | 107 | 8.7s | hello from lab |
— |
| 写文件 | 2 | 34,265 | 34,176 | 131 | 9.0s | DONE |
written.txt = WRITTEN_OK ✅ |
| 跑 Bash | 2 | 34,171 | 34,176 | 93 | 6.8s | BASH_OK |
— |
| Glob | 2 | 34,284 | 34,432 | 454 | 10.3s | 两个文件名 | — |
| 原地 Edit | 3 | 34,474 | 68,480 | 272 | 8.7s | EDITED |
probe.txt hello→goodbye ✅ |
子代理也能用。要求用 Agent 工具后确实派生了,抓 stream 能看到真实调用链:
t9b 实际调用的工具: ['Agent', 'Bash']
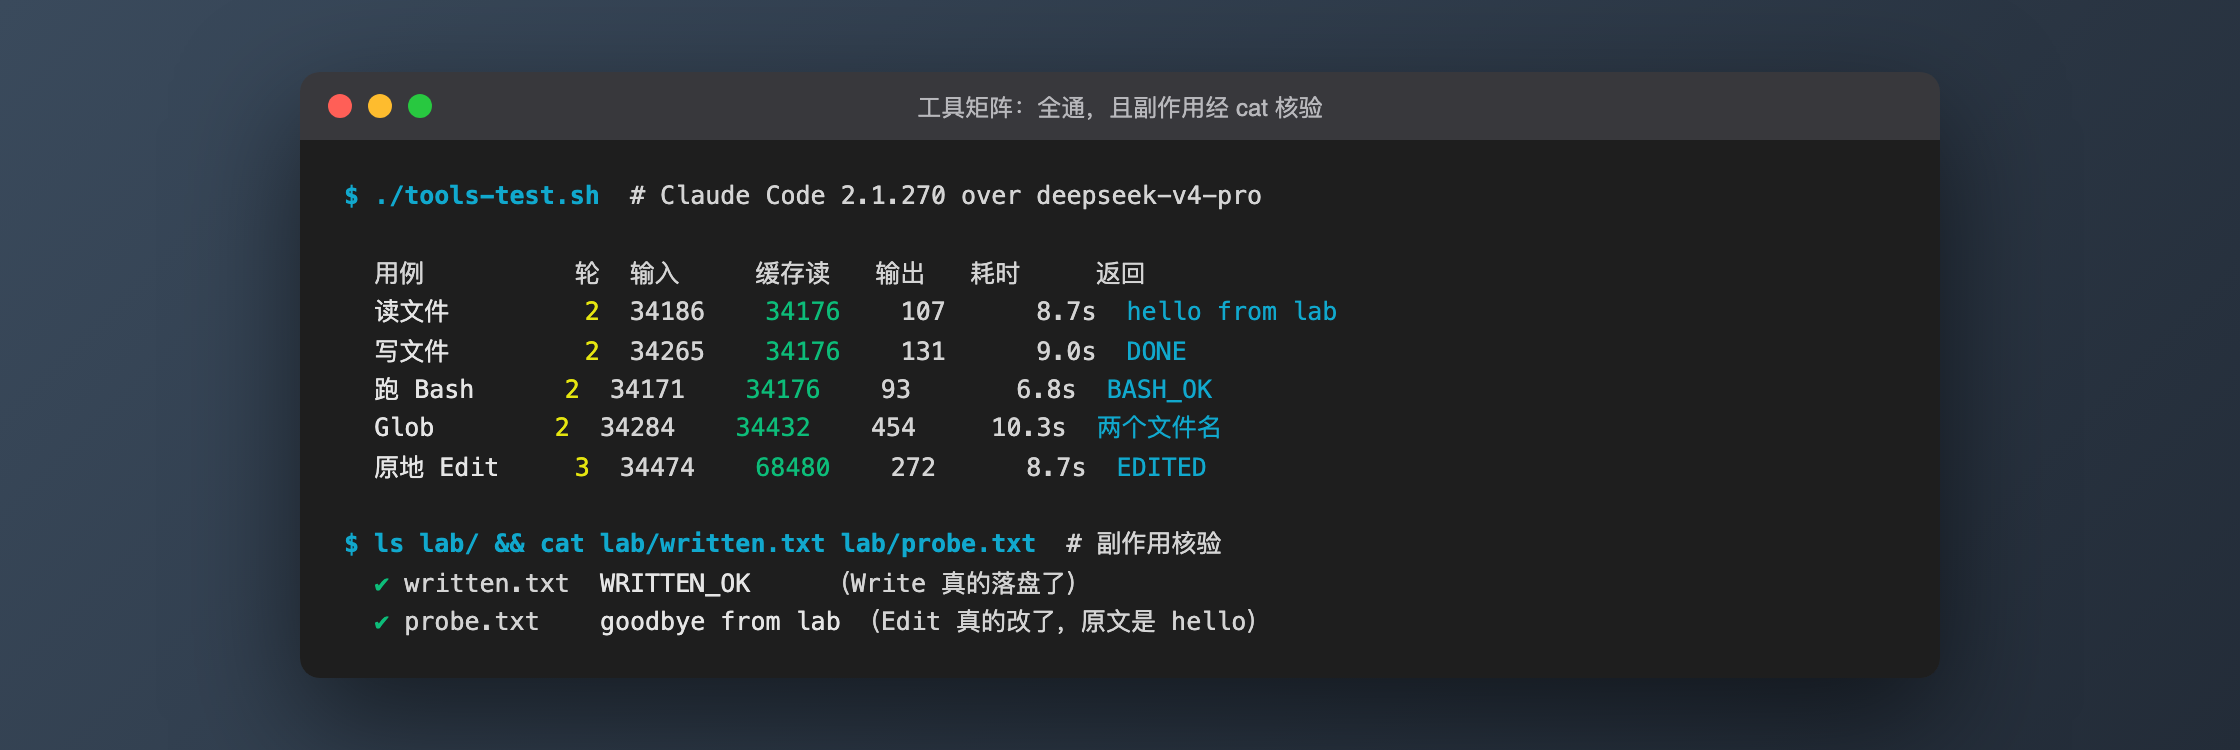
prompt 缓存是生效的。 首次(冷)调用 cache_read_input_tokens: 0,之后每次都从缓存读约 34K。我一开始把这个冷启动的 0 误读成「缓存没用上」——并不是。如果你只看第一个请求,会得出和我一样的错误结论。
注意那张表里的常数:每一轮还没等你打字就有约 34,000 个输入 token。那是 Claude Code 的系统提示词加工具定义。这也是为什么缓存命中价比输入标价更重要。
重点:成本显示虚高 38 倍
Claude Code 会打印花费。接 DeepSeek 时,这个数是假的。
我跑了十次相同调用,前后测真实账户余额,不从价目表推算:
| 数值 | |
|---|---|
| Claude Code 报告(10 次合计) | $1.7097 |
| DeepSeek 余额(前) | ¥37.58 |
| DeepSeek 余额(后) | ¥37.26 |
| 实际花费 | ¥0.32 ≈ $0.045 |
| 虚高 | 38 倍 |
这个假数从哪来?有一次冷调用报告 $0.171215,对应 34,098 输入 + 29 输出。反推单价:
34,098 × $5/1M + 29 × $25/1M = $0.171215 ← 完全吻合
Claude Code 在按每百万 $5 / $25 给 DeepSeek 的 token 计费,那是 Claude Sonnet 的价目。 它甚至在 JSON 里标了自己不确定("costBasis": "unknown"),然后照样打印一个信心十足的金额。
两个实际后果:
/cost和 JSON 里的total_cost_usd在这里不能用。 任何建立在它们之上的东西——预算告警、按任务记账、「这活划不划算」的判断——都会错一个数量级以上。- 要真实数字就用 DeepSeek 自己的
GET /user/balance。注意:它按人民币只给到两位小数,单次调用低于它的分辨率,得攒到差值可测再读。我按 ¥7.1/$ 换算;38 倍这个比例对汇率取值不敏感。
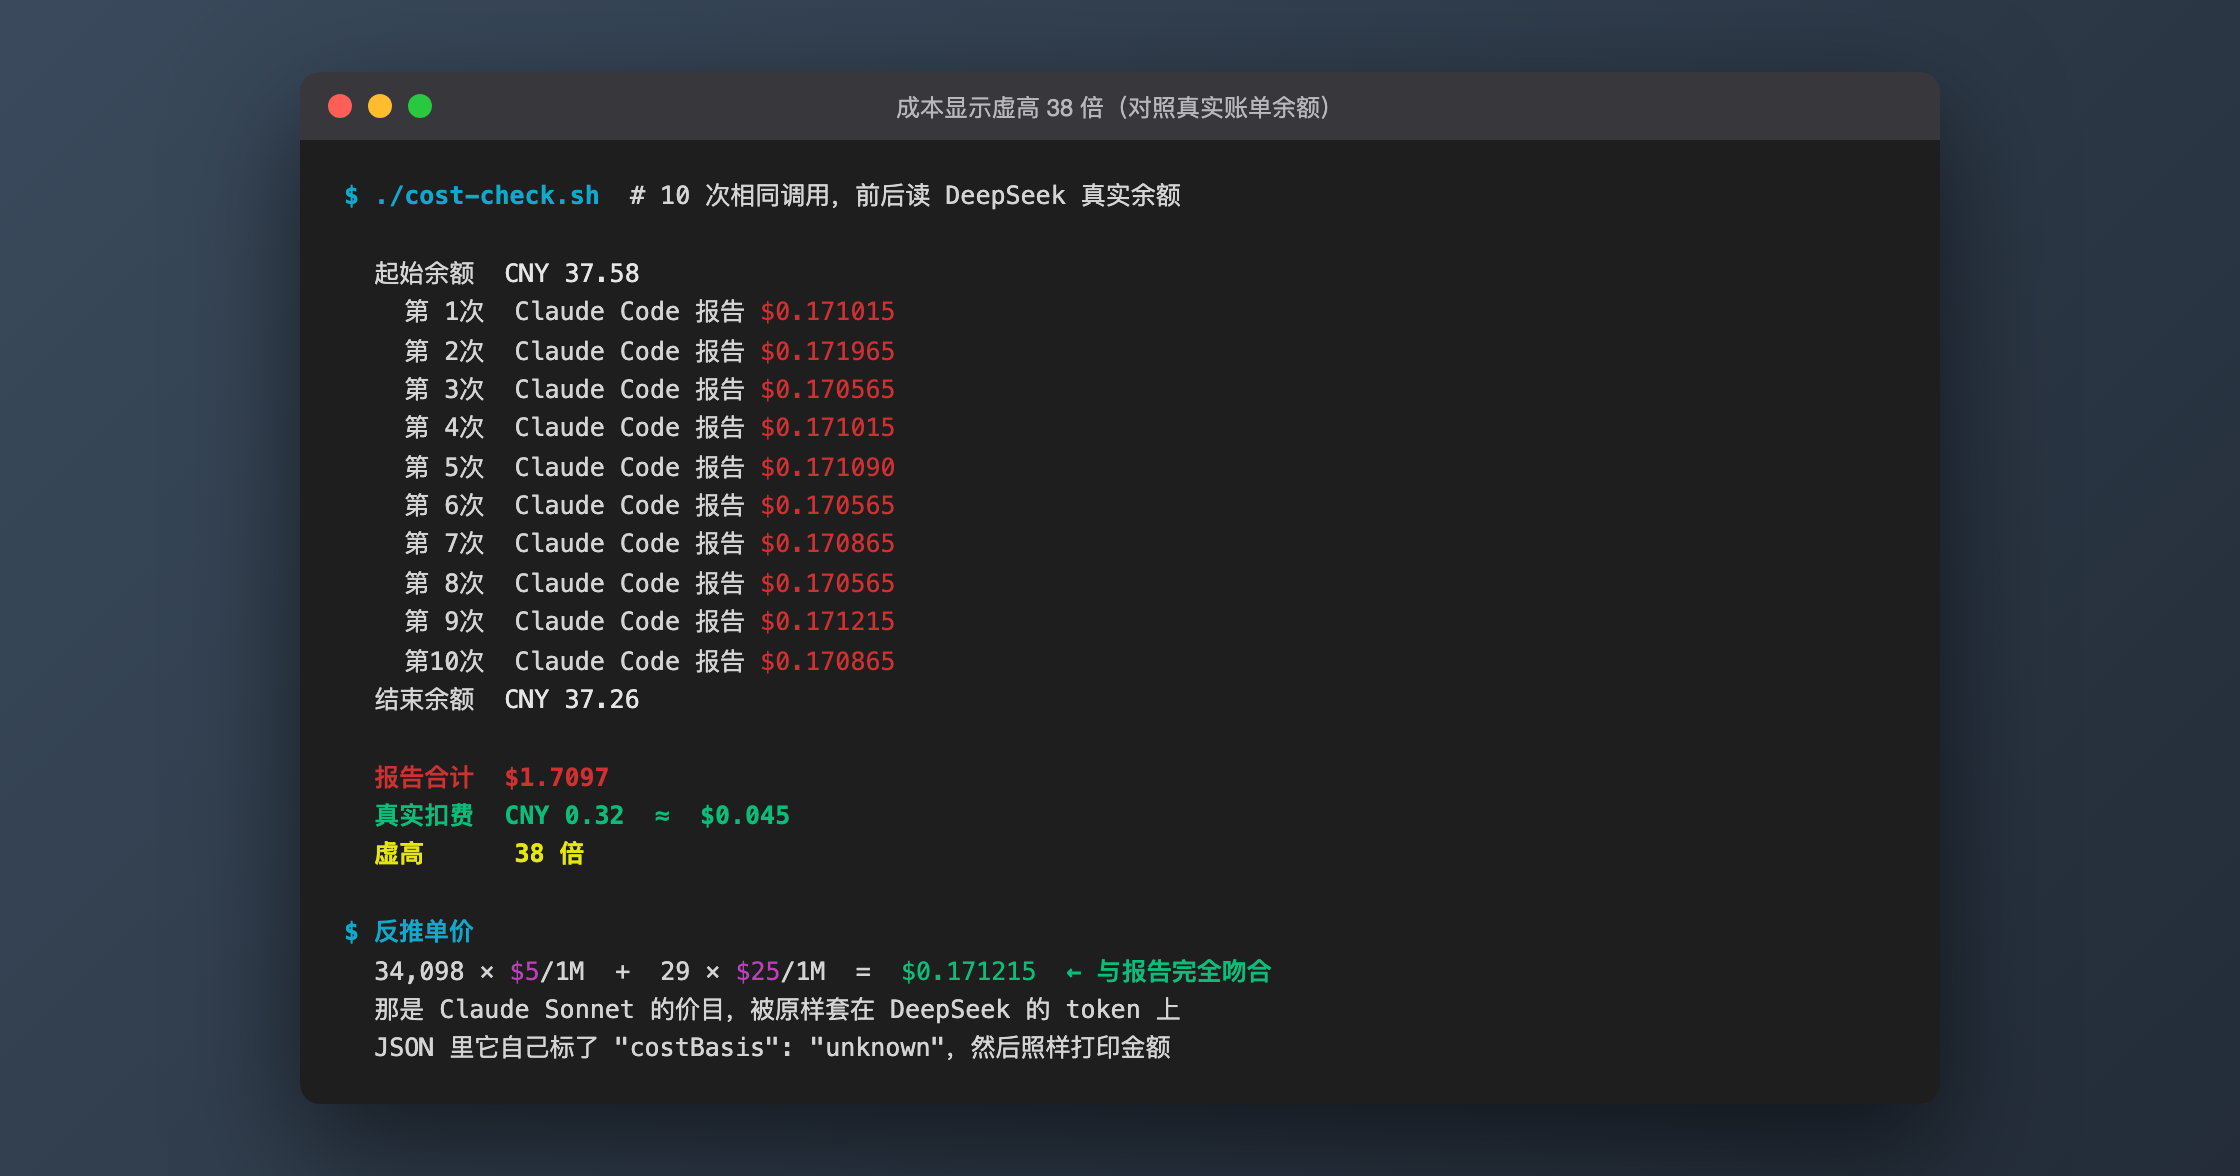
一个诚实的边界:¥0.01 精度的余额差、十次样本,是个粗糙仪器。方向和数量级是可靠的,「38 倍」请当约 40 倍看,别当四位有效数字。
那个不该赖 DeepSeek 的失败
WebFetch 每次都失败:
is_error=True  Unable to verify if domain example.com is safe to fetch.
This may be due to network restrictions or enterprise security policies blocking claude.ai.
模型随后悄悄退回 Bash + curl,照样拿到了正确答案——这种静默降级恰恰是最该抓出来的。
我的第一个假设是 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1(DeepSeek 自家接入指南推荐设的那个)挡住了域名安全校验。这个假设是错的。 对照实验:
| 组 | DISABLE_NONESSENTIAL_TRAFFIC |
代理 | WebFetch |
|---|---|---|---|
| A | 1 |
无 | ❌ 失败 |
| B | 不设 | 无 | ❌ 失败 |
| C | 1 |
有 | ✅ The page title is "Example Domain" |
跟这个变量无关。域名安全校验要回连 Anthropic 的基础设施,而中国大陆不挂代理访问不到 claude.ai。同一天早些时候,我在一个用真实 Anthropic 凭据的会话里遇到过一模一样的报错。
所以:如果你在国内,换到 DeepSeek 后 WebFetch 坏了,别赖 DeepSeek,换之前它就是坏的。挂代理即可。
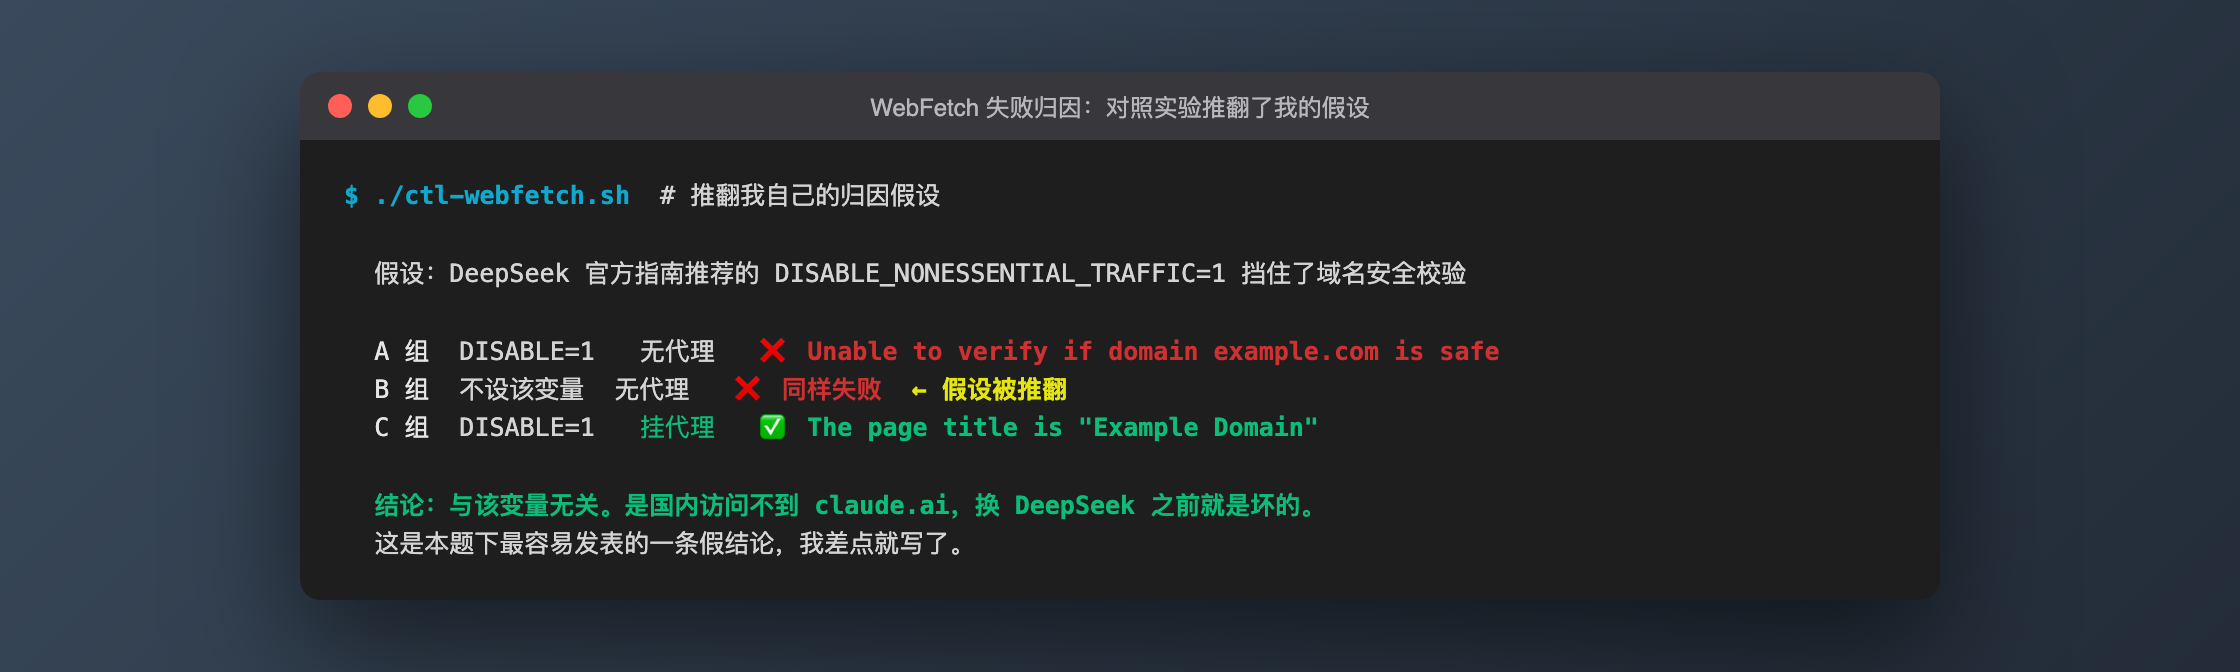
专门写这一段,是因为这是这个题目下最容易发表出来的一条假结论,我差点就写了。
可以无视的噪声
每次调用 stderr 都会有这么一行:
[claude-code:unrecognized_model] {"model":"deepseek-v4-pro","query_source":"sdk"}
Claude Code 不认识这个模型名,但它照样正常工作。脚本里解析 stderr 的话把它过滤掉。
结论
适合拿来干:工具调用占大头、单 token 成本敏感的机械活——重构、铺测试、翻日志,那些你用 Opus 会心疼的事。工具层是真的扎实,我的矩阵里没有一条静默产生了错误副作用。
不适合:任何需要成本显示是真的场景,或者你要依赖 Claude Code 报告的上下文窗口与模型真实值一致的场景。这两个现在都是错的。
接上之后立刻要改的一件事:别看 /cost 了。写两行脚本读 DeepSeek 的余额端点。
踩坑速查
- 文档说的未知模型回落不存在——非
claude-*且不是精确 DeepSeek 模型名的,返回 HTTP 400,不会静默换成 flash。 - thinking 块会吃掉
max_tokens——预算给小了会得到看似空的回复。影响自建客户端,不影响 Claude Code。 - 冷启动的缓存读是 0——别因为第一个请求就断定缓存没生效。
total_cost_usd是拿 Sonnet 价目套 DeepSeek token——虚高约 38 倍,对照真实账单测得。- 国内的 WebFetch 失败是代理问题不是 DeepSeek 问题——写成兼容性缺陷之前先做对照组。
/v1/models的 404 和 stderr 的unrecognized_model都无害——别去追。
2026-09-20 实测,Claude Code 2.1.270,macOS/Apple Silicon,对象为 deepseek-v4-pro(DeepSeek-V4-Pro-0813)与 deepseek-flash(DeepSeek-V4.1-Flash)。价格数字同日读自 DeepSeek 官方价格页;花费经 GET /user/balance 前后对照测得。