同一台 24G Mac mini、同一个 DFlash 2:MLX 上加速 1.9x,llama.cpp 上减速 50% 还 OOM
同一台 24G Mac mini、同一个 DFlash 2:MLX 上加速 1.9x,llama.cpp 上减速 50% 还 OOM
问题背景
这是这台 24G Mac mini M4 上投机解码对照的第三篇。前情两篇:
- DFlash 2 实测:MLX 栈外挂 2B 草稿模型,6.5 → 11.7–12.2 tok/s,稳定 1.8–1.9x;
- Qwen3.8 原生 MTP 实测:llama.cpp 栈挂模型自带的 MTP 头,结果净减速(散文 -24%),根因是 llama-batched-bench 实测出的 Metal 批量解码摊薄只有 1.13x。
MTP 那篇留了个自然的问题:llama.cpp 在 PR #27342 里也合并了 DFlash 2 支持(--spec-type draft-dflash),z-lab 官方还发布了配套的 GGUF 草稿模型。同一个 DFlash 2 算法,换到 llama.cpp 栈上跑,是复刻 MLX 的 1.9x,还是重蹈 MTP 的净减速?
这个问题值得测,因为两个假设只能活一个:如果 MTP 输在"草稿质量",那 DFlash 2 这个更强的草稿器(官方 CUDA 评测接受长度 5.1–5.4)应该能赢;如果输在"Metal 验证批量不摊薄"这个后端税,那换什么草稿器都没用。
先说结论:后端税赢了,而且比预想的更狠。官方 README 推荐的 --spec-draft-n-max 7 在这台机器上直接 Metal OOM(可复现);能稳定跑完的 n-max 3 散文从 6.0 掉到 3.0 tok/s(-50%);代码提示词接受率高达 83.8%、平均一步接住 3.5 个 token——依然亏 23%。同一台机器上 MLX 栈是 1.8–1.9x。
问题分析
三篇对照下来,这台机器上的投机解码格局是一张 2×2 的表:
| MLX 栈 | llama.cpp 栈(Metal) | |
|---|---|---|
| DFlash 2 外挂草稿 | 1.8–1.9x(上上篇) | 本篇:0.5x,官方推荐配置 OOM |
| 原生 MTP 头 | 无现成挂载路径 | 0.76x(上篇) |
上篇已经量化了 llama.cpp Metal 的病根:批量验证不摊薄。llama-batched-bench 实测 batch 8 聚合吞吐 6.90 tok/s,对比单流 6.10,摊薄比只有 1.13x(CUDA 同场景是 3.34x)。投机解码的收益公式里,"验证 n 个草稿 ≈ 验证 1 个 token"这个近似在这个后端上不成立。
所以动手前的预判是:DFlash 2 的草稿质量再好,也要过验证这道税关。但实测出来的账比"验证税"还多一层——草稿本身在这条栈上也贵得离谱,后面用数字算。
技术方案与选型
目标模型:继续用 unsloth UD-Q4_K_S(15.36GB),和上篇 MTP 实测完全同一个文件、同一套 server 参数(-c 8192 -ngl 999 -fa on -b 512 -ub 512)。这样昨天的 baseline 直接可比,今天实测 baseline 也确实精确复现了(6.00 vs 6.00 tok/s)。
草稿模型:z-lab 官方 GGUF 三个量化里选 Q4_K_M(1.14GB)——一是对齐 MLX 实测用的 --draft-bits 4,二是官方自己的评测里 Q4_K_M 接受长度(5.39)反而比 BF16(5.28)还高,三是上上篇复测已经证明 8-bit 草稿在这台机器上不如 4-bit。排除 Q8_0(2.06GB)和 BF16(3.86GB):24G 机器上主模型加草稿已经贴着 Metal 工作集上限(后面 OOM 一节就是证据),没有理由用更大的。
对照臂:baseline / n-max 7(官方 README 推荐值)/ n-max 3(llama.cpp 默认值)/ n-max 12(探上限)。方法继续用净速度法:greedy(temperature 0)、固定 400 token、读 timings.predicted_per_second,散文和代码两种提示词各两轮。
挂载方式:本地文件用 -md 显式指定;如果用 -hf 从 HuggingFace 拉主模型,llama.cpp 新版能按 dflash- 前缀自动发现并下载 sidecar(common/download.cpp 里的 find_best_dflash),和 mtp-、eagle3- 是同一套机制。
# 草稿模型 1.14GB
curl -L -o ~/llm/mtp/models/Qwen3.8-27B-DFlash2-Q4_K_M.gguf \
  "https://huggingface.co/z-lab/Qwen3.8-27B-DFlash2-GGUF/resolve/main/Qwen3.8-27B-DFlash2-Q4_K_M.gguf"

# 官方 README 的推荐姿势(剧透:24G 机器上会 OOM)
./build/bin/llama-server -m Qwen3.8-27B-UD-Q4_K_S.gguf \
  -md Qwen3.8-27B-DFlash2-Q4_K_M.gguf \
  --spec-type draft-dflash --spec-draft-n-max 7
实测过程
benchmark 脚本沿用上篇的脚手架(含全部踩坑修正:curl -o 直写响应文件、pkill -INT 匹配进程名、/health 检查 body),四臂顺序执行,每臂独立起停 server、/usr/bin/time -l 记录峰值内存:
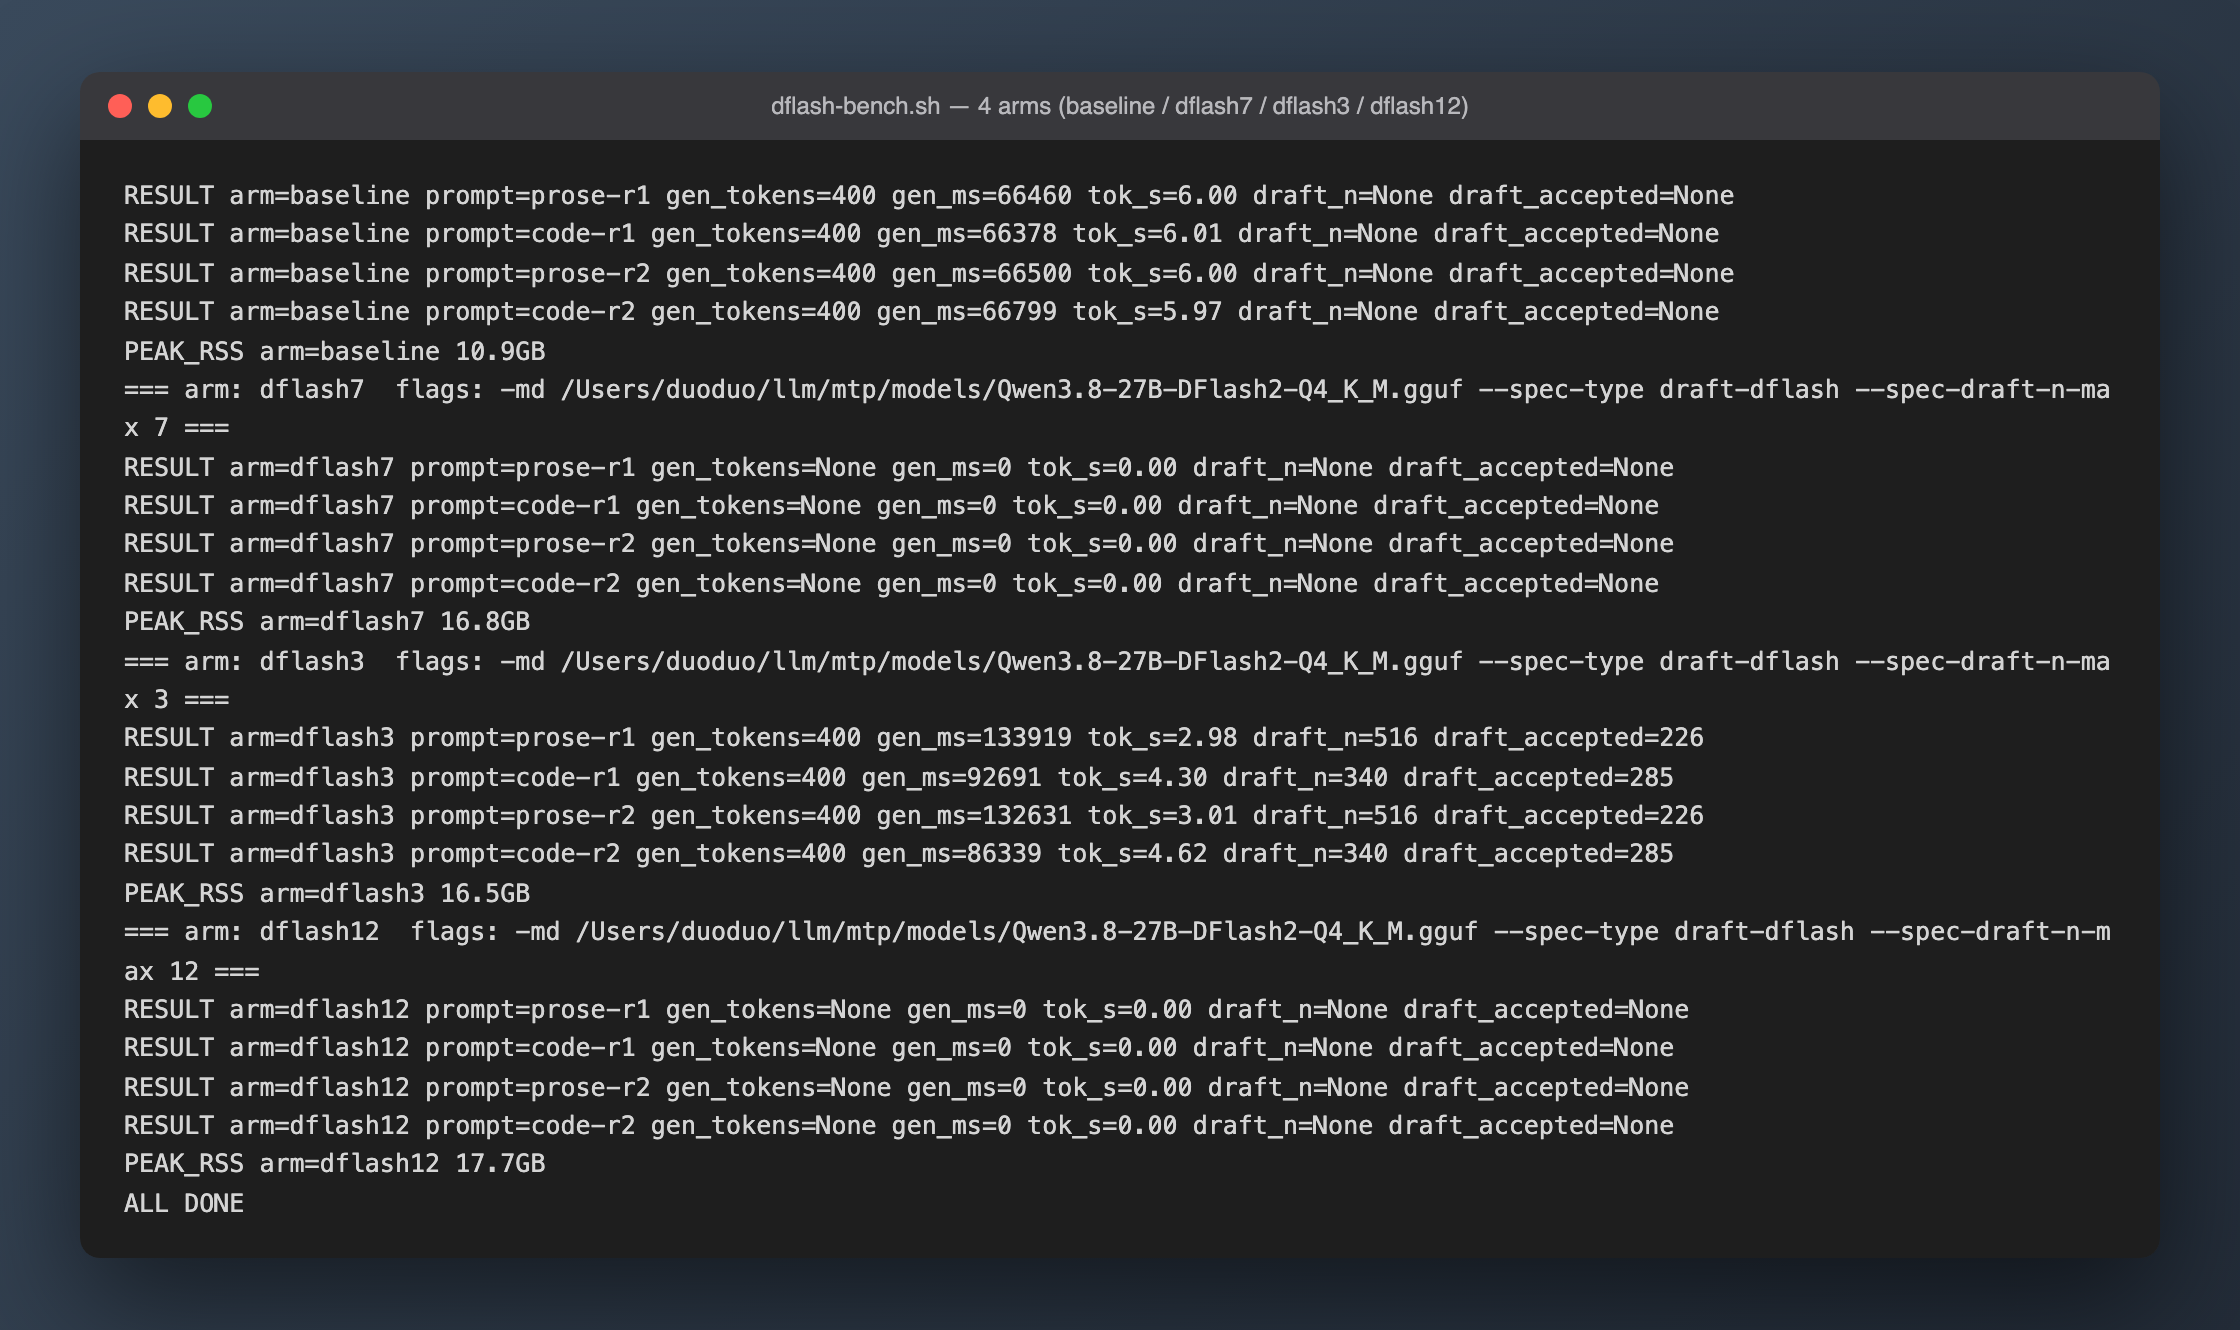
n-max 7 和 12 两臂的所有请求返回 {"error":{"code":500,"message":"Compute error."}}。翻 server stderr,是 Metal 显存分配失败:
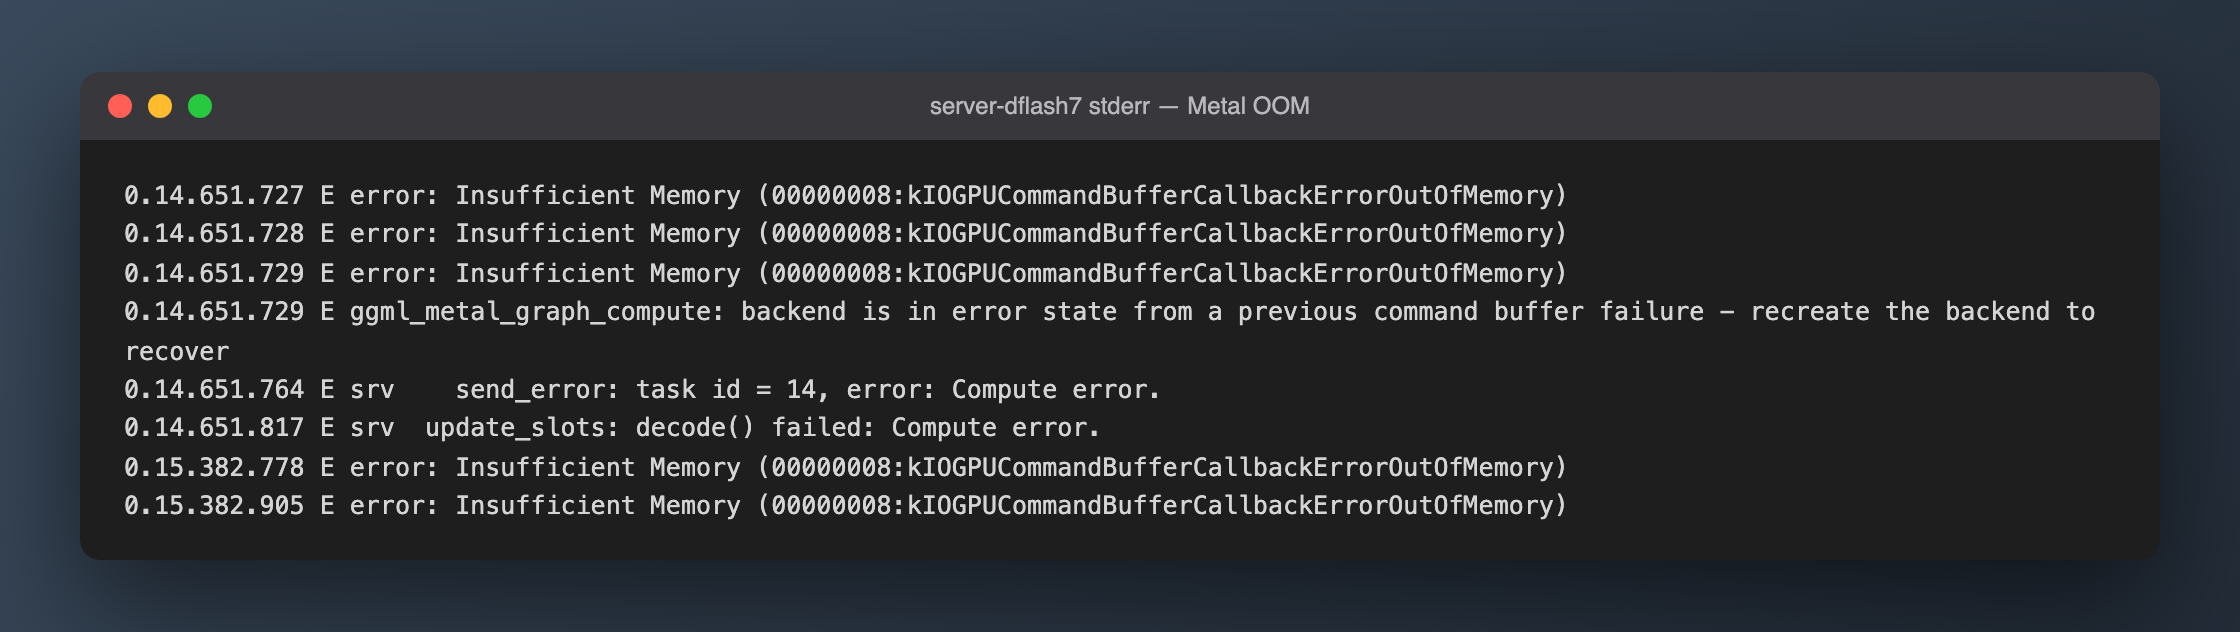
加载阶段日志里其实已有预警:ggml_metal_log_allocated_size: warning: current allocated size is greater than the recommended max working set size——15.36GB 主模型 + 1.14GB 草稿 = 16.5GB 权重,已经越过 24GB 机器的 Metal 推荐工作集上限,n-max 越大验证批越宽、计算缓冲越多,7 和 12 直接压垮。
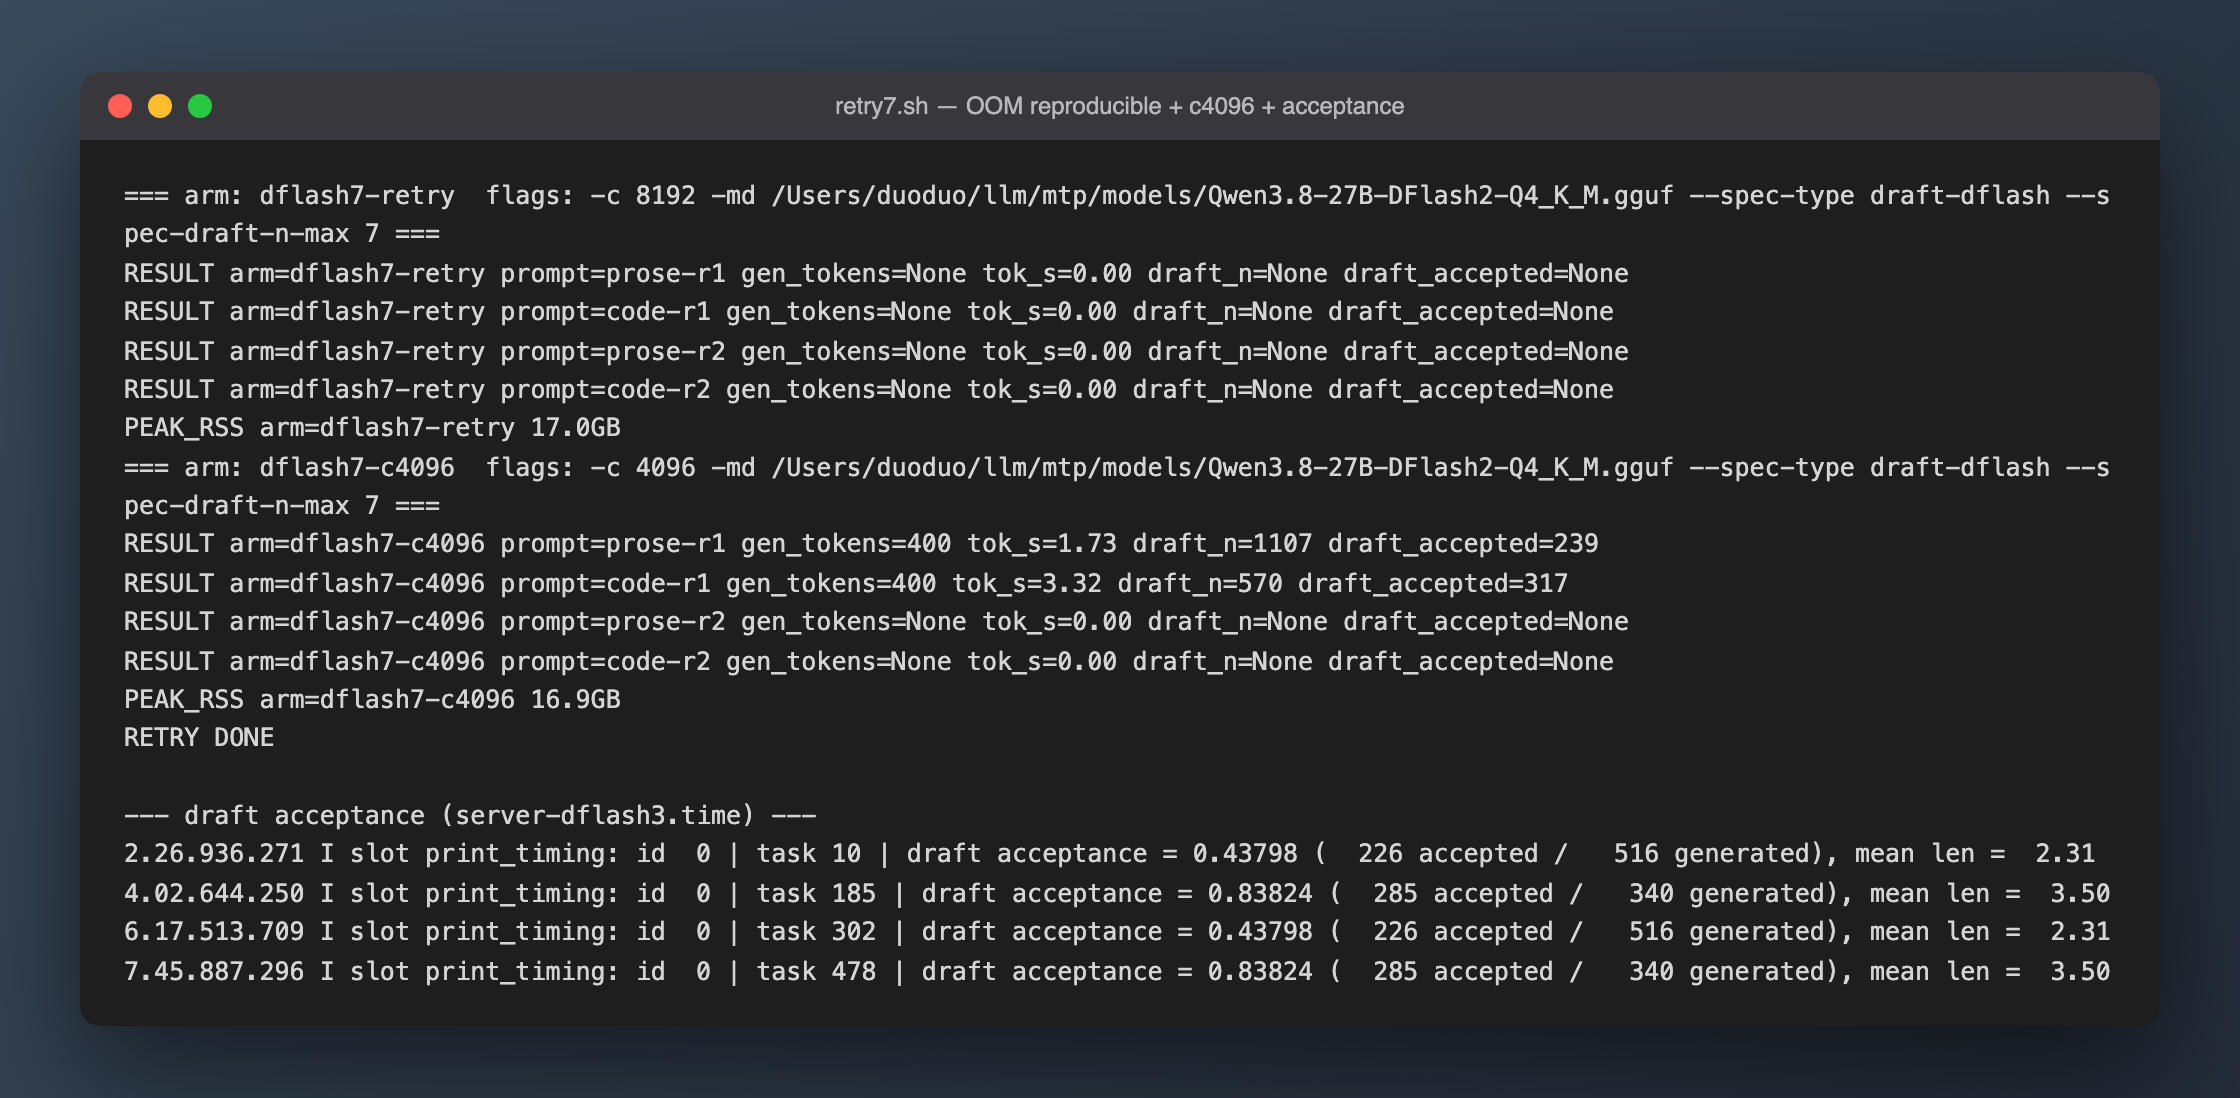
OOM 是不是环境问题? 首轮跑的时候系统只剩 314MB 空闲内存,有理由怀疑是环境压力。于是在空闲内存回升到 4.5GB 后做了受控重试:
- n-max 7 +
-c 8192:依然全部 OOM——这是配置固有的,不是环境背锅; - n-max 7 +
-c 4096(砍半上下文换空间):第一轮跑通了(散文 1.73、代码 3.32 tok/s),第二轮又 OOM——贴着上限跑,Metal 堆撑不过连续请求。
实践效果
汇总所有跑通的配置(400 token greedy,净生成速度):
| 配置 | 散文 | 代码 | 接受率(散文/代码) | 结果 |
|---|---|---|---|---|
| baseline(无投机) | 6.00 / 6.00 | 6.01 / 5.97 | — | 基准 |
| dflash n-max 3 | 2.98 / 3.01(-50%) | 4.30 / 4.62(-23~28%) | 43.8% / 83.8% | 净减速 |
| dflash n-max 7(c=4096,仅存活 1 轮) | 1.73(-71%) | 3.32(-45%) | 21.6% / 55.6% | 净减速 + 随后 OOM |
| dflash n-max 7 / 12(c=8192) | — | — | — | Metal OOM,可复现 |
对照 MLX 栈同机数字:基线 6.43–6.51,DFlash 2 block-size 5 是 10.8–12.2 tok/s(1.66–1.88x),block-size 3 是 11.6(1.79x)。同一个算法、同一台机器、同一天气候,两条栈一个 1.8x、一个 0.5x。
一笔算死这条栈的账
代码提示词的接受率是 83.8%、平均一步接住 3.5 个 token(server 日志 mean len = 3.50)——按 MLX 的经验这足够 1.5x 以上了,为什么还亏 23%?把总时间除以验证步数:
- 散文:133.9 秒 / 174 个投机步(400 − 226 个接受)= 每步 0.77 秒
- 代码:86.3 秒 / 115 个投机步(400 − 285 个接受)= 每步 0.75 秒
每个投机步(草稿块生成 + 批量验证一次)稳定花 0.75–0.77 秒,而 baseline 单 token 只要 0.167 秒——一步的成本等于约 4.6 个普通 token,而 n-max 3 一步的收益上限是 4 个 token(3 个草稿全中 + 1 个验证 token)。也就是说:接受率就算 100%,这条栈也是亏的(0.77 ÷ 4 = 0.19 秒/token > 0.167)。n-max 7 同理:每步实测 1.44 秒,成本 8.6 个 token,收益上限 8 个,照样死。
这 0.77 秒里有两笔:验证批不摊薄(上篇量化过的 1.13x)+ 草稿块生成本身的开销(一个 1.1GB 的 block-diffusion 模型每步全量前向加候选路径选择,在 Metal 上没有做过任何优化)。两笔的精确拆分需要 profiler,但结论不需要:成本 ≥ 收益上限,是结构性死局,调参救不了。
顺带两个复现细节:
- greedy 一致性:代码输出与 baseline 字节级一致;散文在第 1294 字符处分叉——和上篇 mtp4 分叉的位置一模一样。这坐实了它是"不同 Metal kernel 路径在 logits 近平局处的浮点分歧"这个系统性现象,与投机算法无关。
- 官方数字没有说谎:z-lab README 的接受长度 5.1–5.4 是 CUDA 上 GSM8K + 高推理档的评测,README 通篇没有对 Metal 做任何速度承诺。是"合并了支持"和"在你的后端上跑得快"之间的差距,需要自己实测来填。
结论怎么用
- 24G Mac 上跑 Qwen3.8 要投机加速:用 MLX 栈的 DFlash 2(block-size 3–5),这是三篇实测下来唯一正收益的路线;
- llama.cpp 栈在 Metal 上目前不要开任何投机解码(draft-dflash 和 draft-mtp 都实测净亏),裸跑 6.0 tok/s 就是它的最优解;
- 这个结论是 Metal 后端专属的:CUDA/ROCm 用户两条路线都有社区实测的正收益,别拿本文劝退;
- 若未来 llama.cpp 的 Metal 批量解码摊薄改善(batched-bench 的 batch-8 比值明显超过 1.13x),本文结论需要重测——这是个可以量化跟踪的信号。
踩坑
- 官方 README 的推荐配置在 24G 机器上直接 OOM。
--spec-draft-n-max 7+ 默认上下文在 16.5GB 权重的组合下越过 Metal 工作集上限,全部请求 500。加载日志里的allocated size is greater than the recommended max working set size警告不是废话,看到它就该预期高 n-max 会炸。 - **
-c 4096只能续命一轮。**砍上下文换来的空间撑过了第一对请求,第二轮又 OOM——贴着显存上限的配置在连续服务下不可用,别拿"跑通过一次"当"能用"。 - **内存受压时
/usr/bin/time -l的峰值 RSS 不可比。**本次 baseline 显示峰值 10.9GB,而昨天同配置清爽环境下是 15.4GB——差的 4.5GB 是被系统驱逐的 mmap 权重页。要对比内存足迹,先清场再测,或者直接看 Metal 分配日志。 - **
script -a(追加模式)在无 TTY 的后台环境下报tcgetattr/ioctl: Operation not supported on socket。**新建会话文件的script -q file cmd可以在后台跑,追加模式不行;后台补测的输出改用tee收集。
三部曲到此闭环:这台机器上投机解码的胜负从来不在草稿质量(43.8% 和 83.8% 的接受率结局相同),在后端每个投机步的固定成本。下一个值得跟的信号有两个:llama.cpp Metal 批量解码的摊薄改善,和 MLX 侧原生 MTP 挂载路径的出现——任何一个落地,这张 2×2 表就要重画。