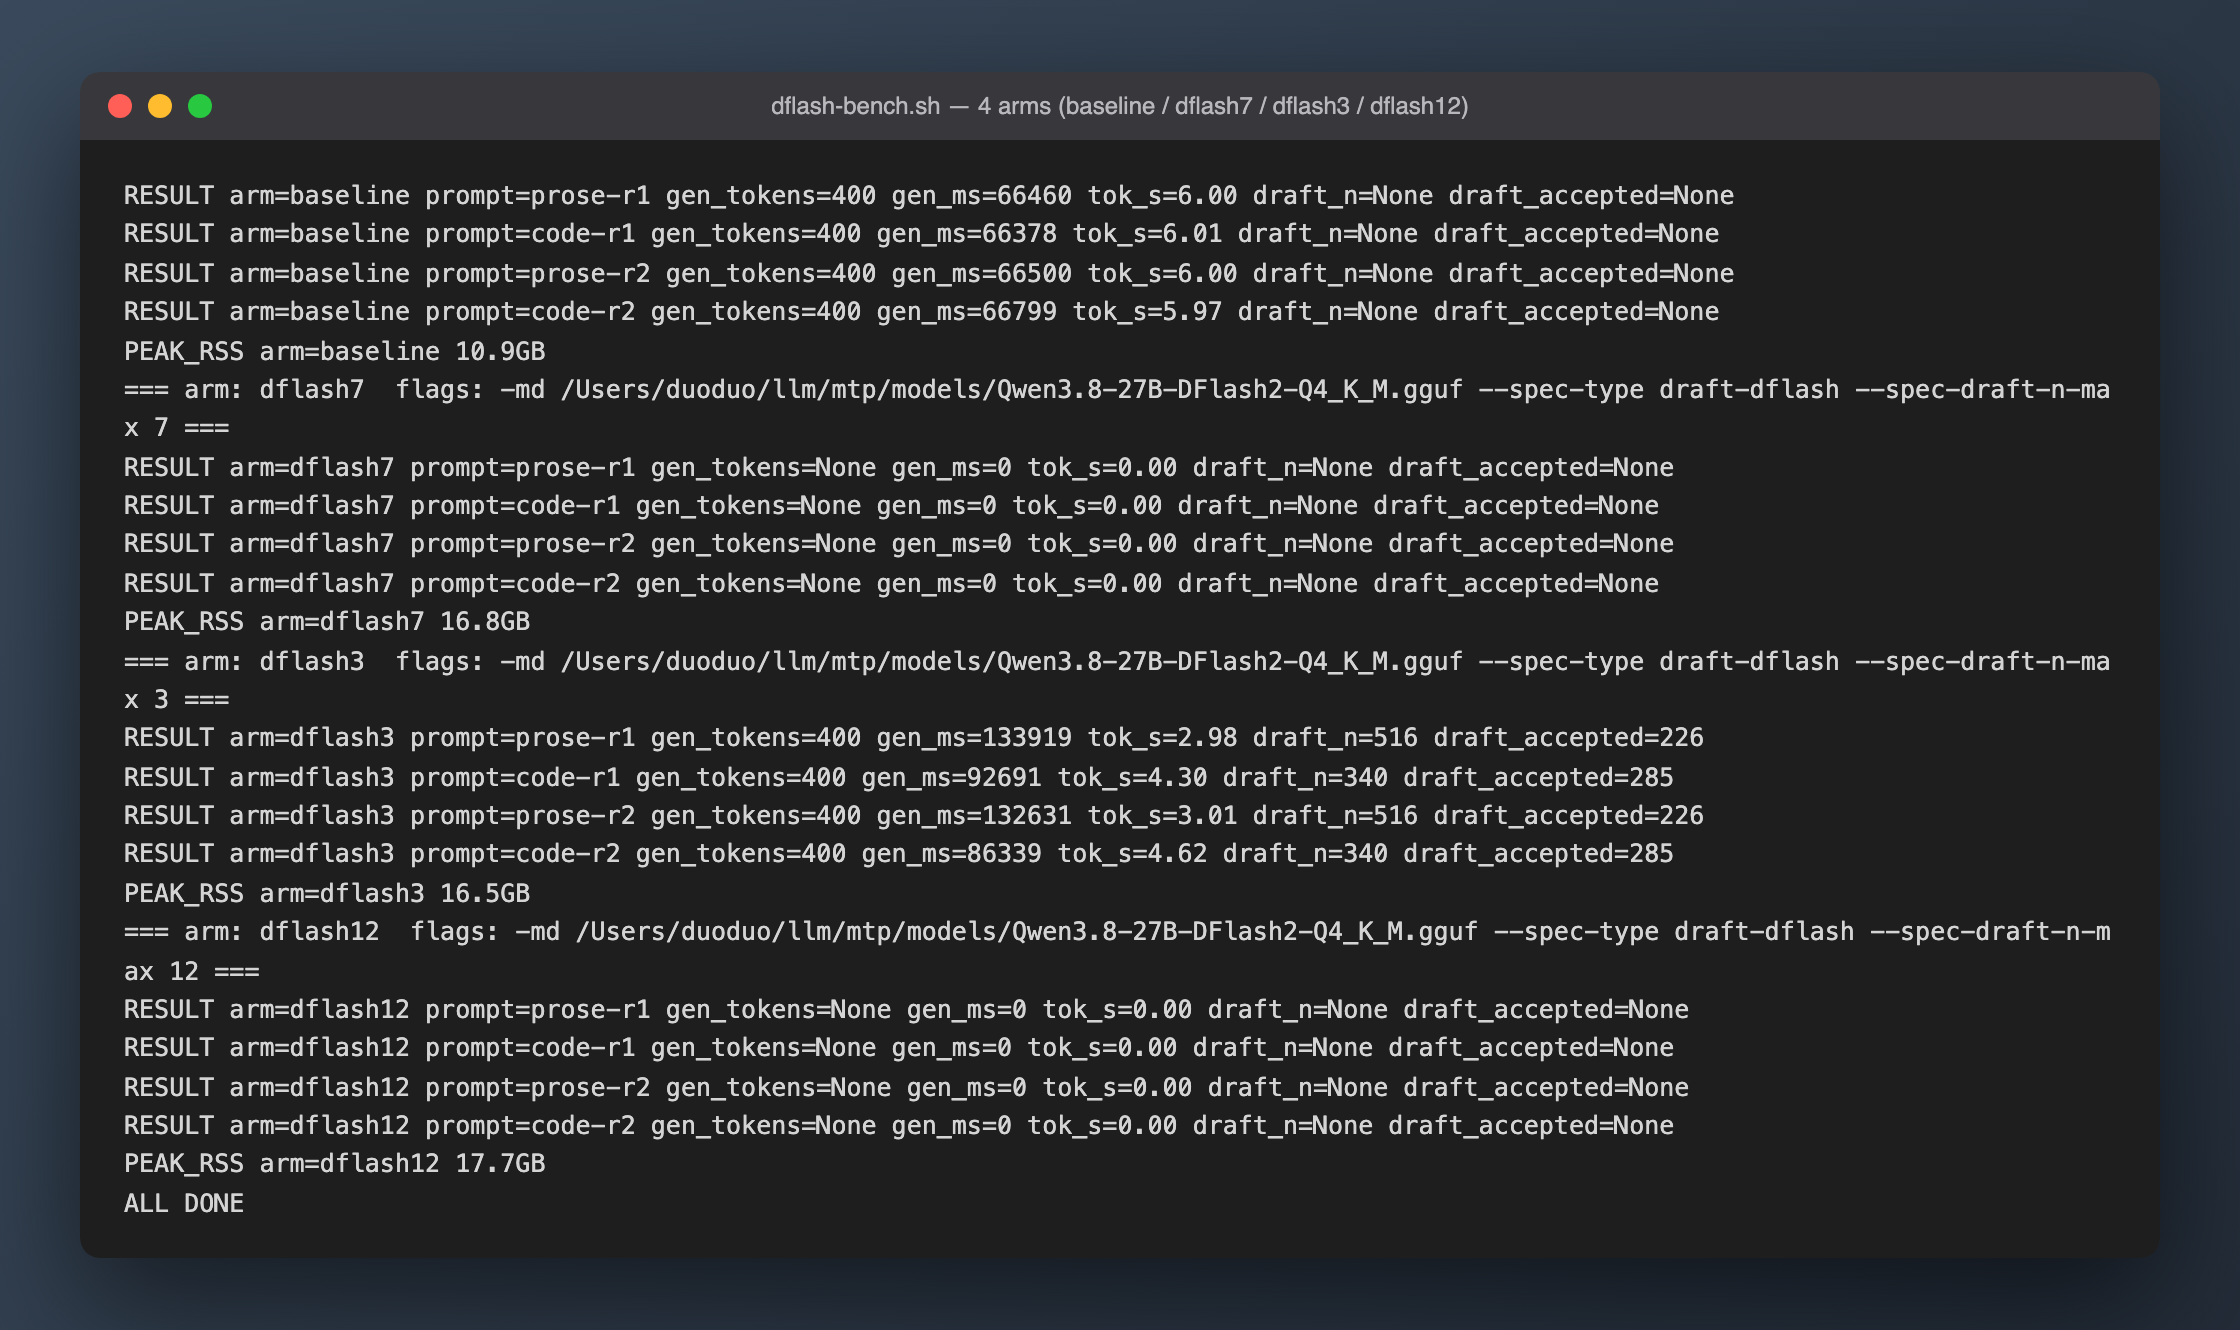
同一台 24G Mac mini、同一个 DFlash 2:MLX 上加速 1.9x,llama.cpp 上减速 50% 还 OOM
投机解码三部曲第三篇。llama.cpp 合并了 DFlash 2 支持、官方还发了配套 GGUF 草稿模型,理论上这是比外挂 MLX 更顺手的路线——实测结果是全配置净减速:官方推荐的 n-max 7 在 24G 机器上可复现 Metal OOM,能跑起来的 n-max 3 散文掉一半(6.0 → 3.0 tok/s),代码接受率高达 83.8% 也还亏 23%。同一个算法、同一台机器,MLX 栈是 1.8–1.9x。用真实数据算清一笔账:这条栈上每个投机步实测均摊 0.77 秒,就算接受率 100% 也追不回本。
qwendflash+6
ai-tutorials2026年9月3日7 min
611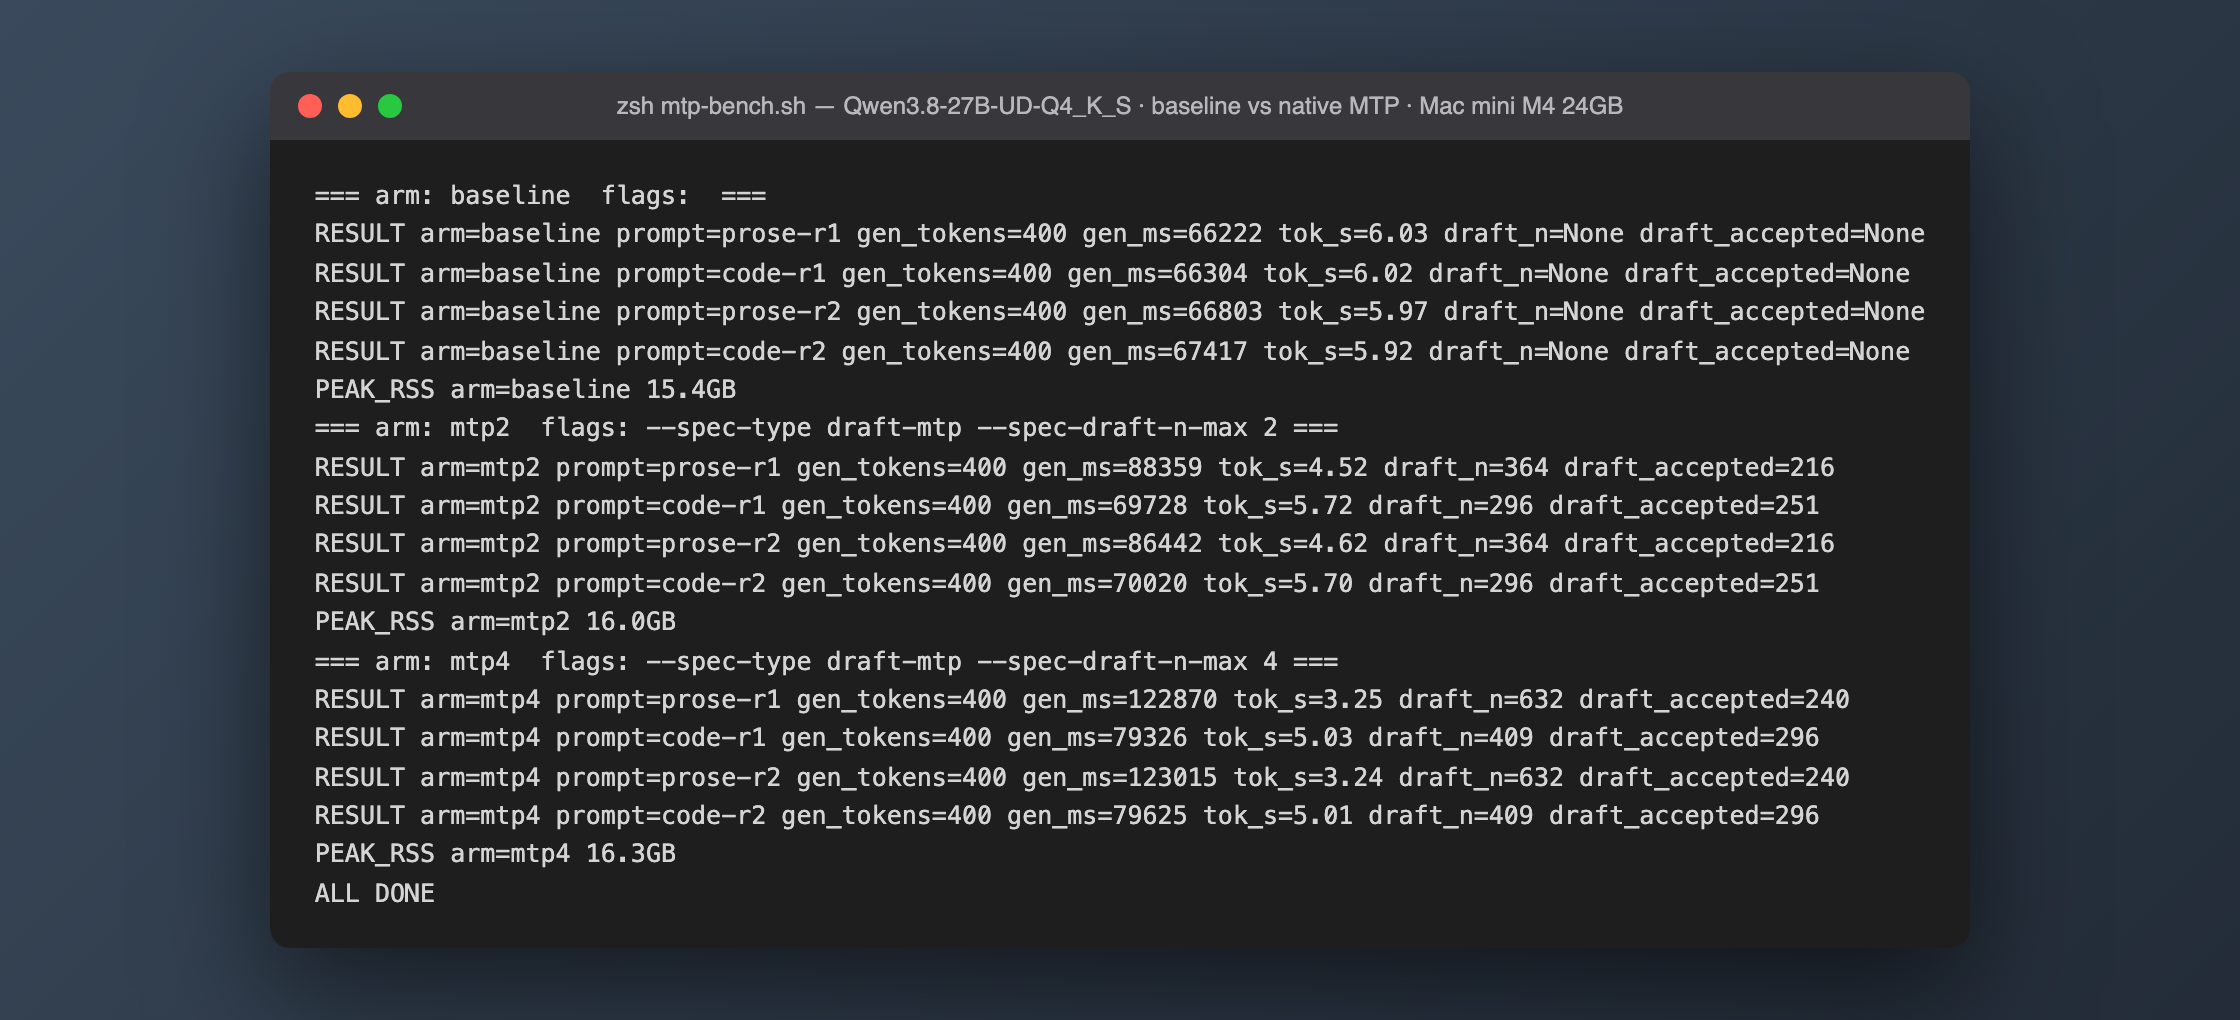
24G Mac mini 实测 Qwen3.8 原生 MTP:内存省了 3GB,速度反而降了 24%——与 DFlash 2 同机对照
上一篇 DFlash 2 实测结尾预告过的路线:Qwen3.8 自带训练好的 MTP 多 token 预测头,llama.cpp 已支持直接挂载,不需要额外 2B 草稿模型。这次在同一台 24G Mac mini M4 上把它跑通并与 DFlash 2 正面对照:内存确实更省(峰值 16.0GB vs 19.4GB),但速度是净减速——散文 6.0 → 4.5 tok/s(-24%),代码也没赚。同机 DFlash 2 是 1.8–1.9x 加速。差距不在草稿质量(接受率 59–85% 很健康),在 Metal 后端:batch 8 解码摊薄实测只有 1.13x,验证 3 行草稿的代价≈3 次完整前向,草稿再准也赚不回来。
qwenapple-silicon+6
ai-tutorials2026年9月2日8 min
687