24G Mac mini 实测 Qwen3.8 原生 MTP:内存省了 3GB,速度反而降了 24%——与 DFlash 2 同机对照
24G Mac mini 实测 Qwen3.8 原生 MTP:内存省了 3GB,速度反而降了 24%——与 DFlash 2 同机对照
问题背景
上一篇 DFlash 2 实测在这台 24G Mac mini M4 上跑出了 1.8–1.9x 的投机解码加速(6.5 → 11.7–12.2 tok/s),文章结尾留了一条待跟路线:
Qwen3.8 原生 MTP 头:模型自带训练好的多 token 预测头,llama.cpp 已支持挂载,不需要额外 2B 草稿模型,是 24GB 机器上更抠内存的方案——代价是加速比路线不同,值得单独对照实测一次。
这篇就是那次对照。先把结论放前面,因为它和预期相反:在这台机器上,原生 MTP 不是"加速比低一点的省内存方案",而是净减速——散文生成从 6.0 掉到 4.5 tok/s(-24%),代码生成也没赚(-4%)。省内存倒是真的:峰值 16.0GB,比 DFlash 路线的 19.4GB 少 3.4GB。
同一台机器、同一个提示词、同样的 greedy 400 token 方法,两条投机解码路线一个 1.9x、一个 0.76x。差距在哪,正文拆开讲。
问题分析
两条路线的原理同源:都是"便宜地猜几个 token,让大模型一次前向批量验证"。区别在猜的人是谁:
- DFlash 2:外挂一个约 2B 参数的独立草稿模型(下载 3.85GB BF16,载入后现场压成 4-bit 约占 1GB 内存),跑在 MLX 后端。
- 原生 MTP:Qwen3.8 训练时就带了多 token 预测层(
blk.*.nextn.*张量),量化 GGUF 里原样保留。llama.cpp 在 PR #22673(2026 年 7 月)加入了draft-mtp投机解码:不加参数时这些张量加载后被忽略,加一个 flag 就用它当草稿头。
投机解码赚钱的前提是一个近似:验证 n+1 个 token 的耗时 ≈ 验证 1 个——权重只读一遍,摊给每一行。这个近似在不同后端上成立的程度天差地别,而它恰恰是本次实测的胜负手。
动手前先查了社区数据。sudoingX/qwen38-mtp 收集了 53 份配置的 A/B 实测:CUDA/ROCm 卡上这个 flag 普遍 +33% 到 +145%;但表里唯一一行 Apple M4 24GB(Metal)写着 5.8 → 5.8,持平,附带的 Apple Silicon 深测给出了更细的分裂:代码 +910%、散文 -2224%,两头相抵。该仓库把"MLX 与 llama.cpp 同机对照"列为头号未解课题——我这台跑过 DFlash 的机器正好能补上这块。
技术方案与选型
为什么走 llama.cpp 而不是 MLX:原生 MTP 头的第一方支持在 llama.cpp(PR #22673 已合并进 master),mlx_lm 和 dflash CLI 目前都没有挂载 Qwen3.8 nextn 头的现成路径。也就是说这次对照实际是"llama.cpp + 原生 MTP"对"MLX + DFlash 草稿模型"的整条技术栈对照,不是单变量实验——所以两条路线各自的纯自回归基线都要单独测,加速比各自算各自的。
GGUF 选择:两个来源都能用——ggml-org/Qwen3.8-27B-GGUF 提供独立的 mtp-*.gguf 草稿文件(Q4_0 1.68GB,配 --spec-draft-model 挂载);unsloth/Qwen3.8-27B-GGUF 的主模型 GGUF 直接内嵌 nextn 张量,一个文件全搞定。我选了 unsloth 的 UD-Q4_K_S(15.36GB):一是内嵌省事,二是体积与上一篇 MLX 4-bit(约 15GB)最接近,内存账好对齐。ggml-org 自家最小量化是 Q4_K_M 18.97GB,24G 机器上偏紧,放弃。
排除项:Q8_0(29GB)和 BF16(54GB)装不下,不试;社区已在同款 M4 上实测过 --spec-draft-n-max 更深的档位更糟,我只对照 2 和 4 两档验证方向。
实测过程
环境:Mac mini M4 基础版 24GB,macOS 26.3.1。llama.cpp 当天 master(b96806d)源码构建:
brew install cmake
cd ~/llm && git clone --depth 1 https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON -DLLAMA_CURL=OFF
cmake --build build --config Release -j 8 -t llama-server llama-batched-bench
模型下载(走代理,15.36GB):
curl -L -C - -o Qwen3.8-27B-UD-Q4_K_S.gguf \
  "https://huggingface.co/unsloth/Qwen3.8-27B-GGUF/resolve/main/Qwen3.8-27B-UD-Q4_K_S.gguf"
服务端两种起法只差两个 flag:
# baseline (autoregressive decoding)
llama-server -m Qwen3.8-27B-UD-Q4_K_S.gguf -c 8192 -ngl 999 -fa on \
  -b 512 -ub 512 --parallel 1

# native MTP speculative decoding
llama-server -m Qwen3.8-27B-UD-Q4_K_S.gguf -c 8192 -ngl 999 -fa on \
  -b 512 -ub 512 --parallel 1 --spec-type draft-mtp --spec-draft-n-max 2
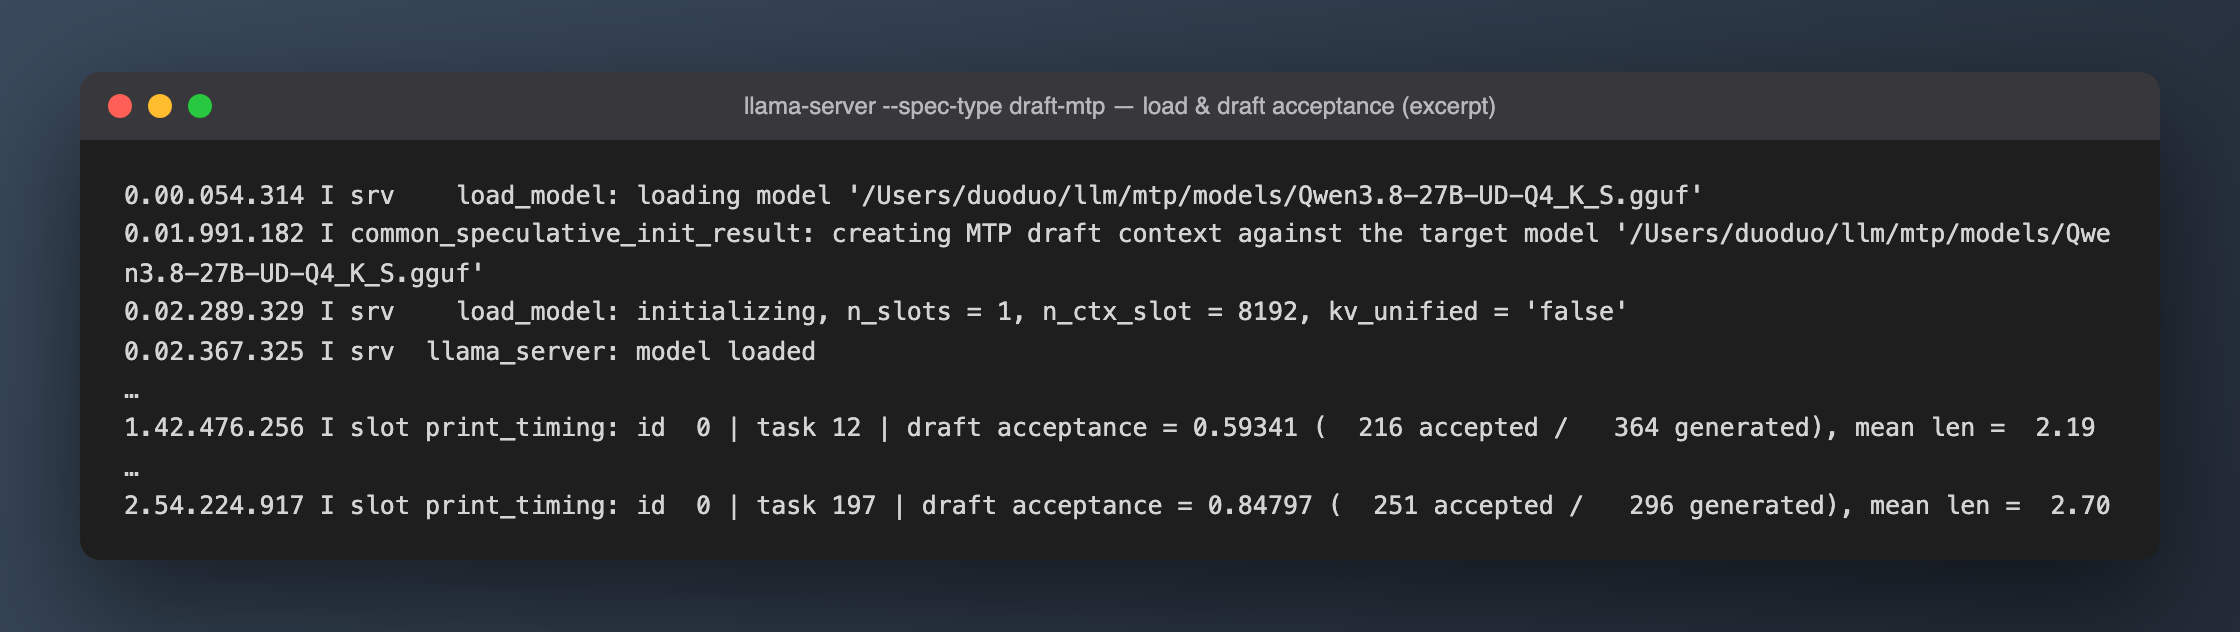
三个 flag 有讲究:-b 512 -ub 512 是社区在同款机器上用 OOM 换来的教训(默认 -b 2048 会在生成中途打爆 Metal command buffer,服务端直接挂);--parallel 1 是测量纪律(投机解码是单流优化,并发基线会虚低)。启动日志里能看到 MTP 头被挂上:
测量方法照搬上一篇的"净速度法"口径:同样的散文提示词(约 300 词英文短文写作)+ 新增一个代码提示词(Python LRU cache 实现)、greedy(temperature 0)、固定生成 400 token、每档两轮。速度取 llama-server 返回的 timings.predicted_per_second——只统计生成阶段,与"总耗时减加载标定"的净速度法等价。思考模式经 chat_template_kwargs: {"enable_thinking": false} 关闭。峰值内存用 /usr/bin/time -l 记录。
实践效果
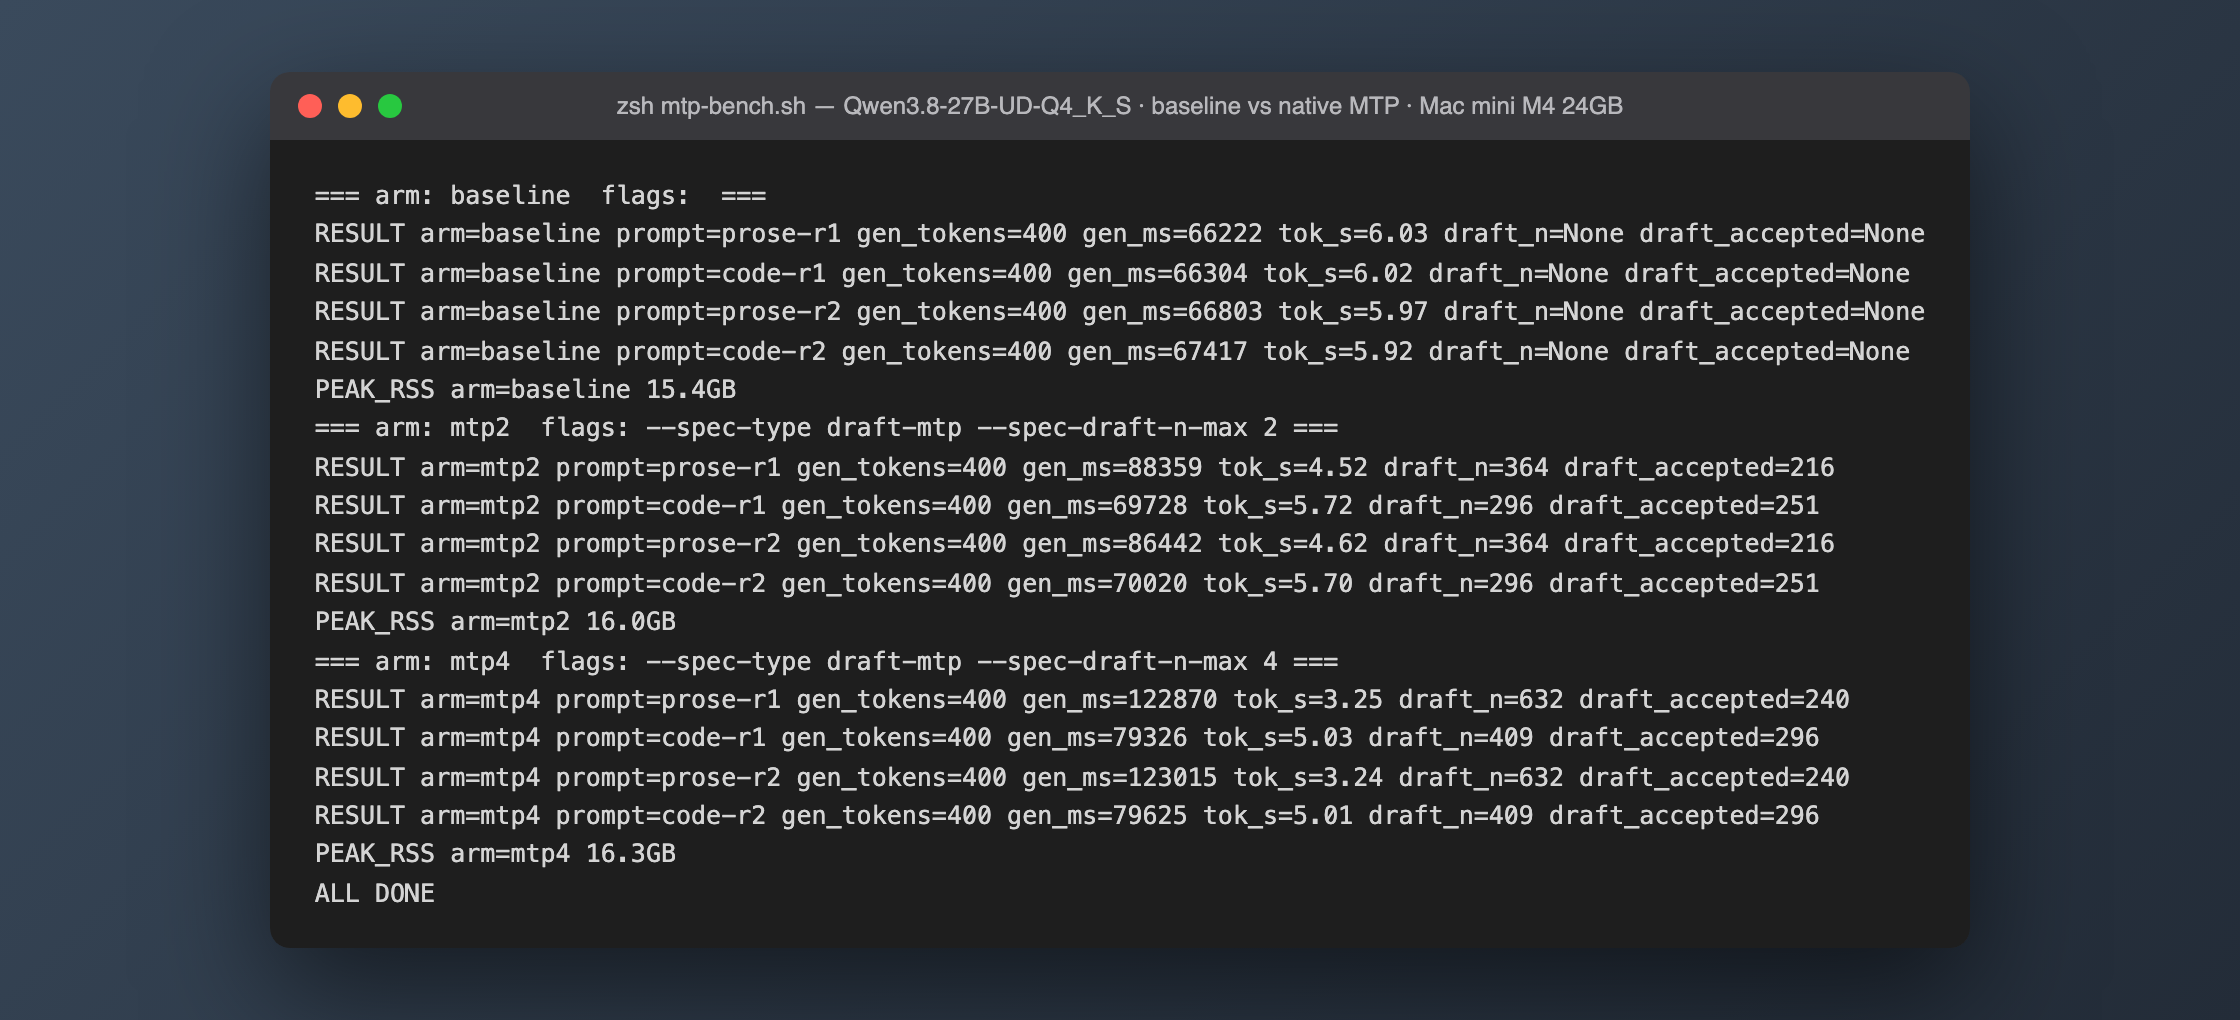
一张图看完三档对照(真实终端输出):
| 配置 | 散文 tok/s | 代码 tok/s | 草稿接受率(散文/代码) | 峰值内存 |
|---|---|---|---|---|
| baseline(纯自回归) | 6.03 / 5.97 | 6.02 / 5.92 | — | 15.4GB |
MTP n-max 2 |
4.52 / 4.62(-24%) | 5.72 / 5.70(-4%) | 59.3% / 84.8% | 16.0GB |
MTP n-max 4 |
3.25 / 3.24(-46%) | 5.03 / 5.01(-16%) | 38.0% / 72.4% | 16.3GB |
对照同机已发布的 DFlash 2 数据,两条路线放一张表里:
| 路线 | 各自基线 | 开投机解码 | 加速比 | 峰值内存 |
|---|---|---|---|---|
| MLX + DFlash 2(2B 草稿) | 6.43–6.51 tok/s | 11.7–12.2 tok/s | 1.8–1.9x | 19.4GB |
| llama.cpp + 原生 MTP | 5.92–6.03 tok/s | 4.52–5.72 tok/s | 0.76–0.96x | 16.0GB |
几个值得展开的点:
1. 草稿质量没问题,验证环节亏光了。 接受率 59–85%、平均接受长度 2.2–3.9,和社区同款对照实验里 CUDA 侧的 0.46–0.93 在同一水平——同样质量的草稿在 RTX 3090 上换来 +69~82%。钱亏在哪,用 llama-batched-bench 直接量出来了:
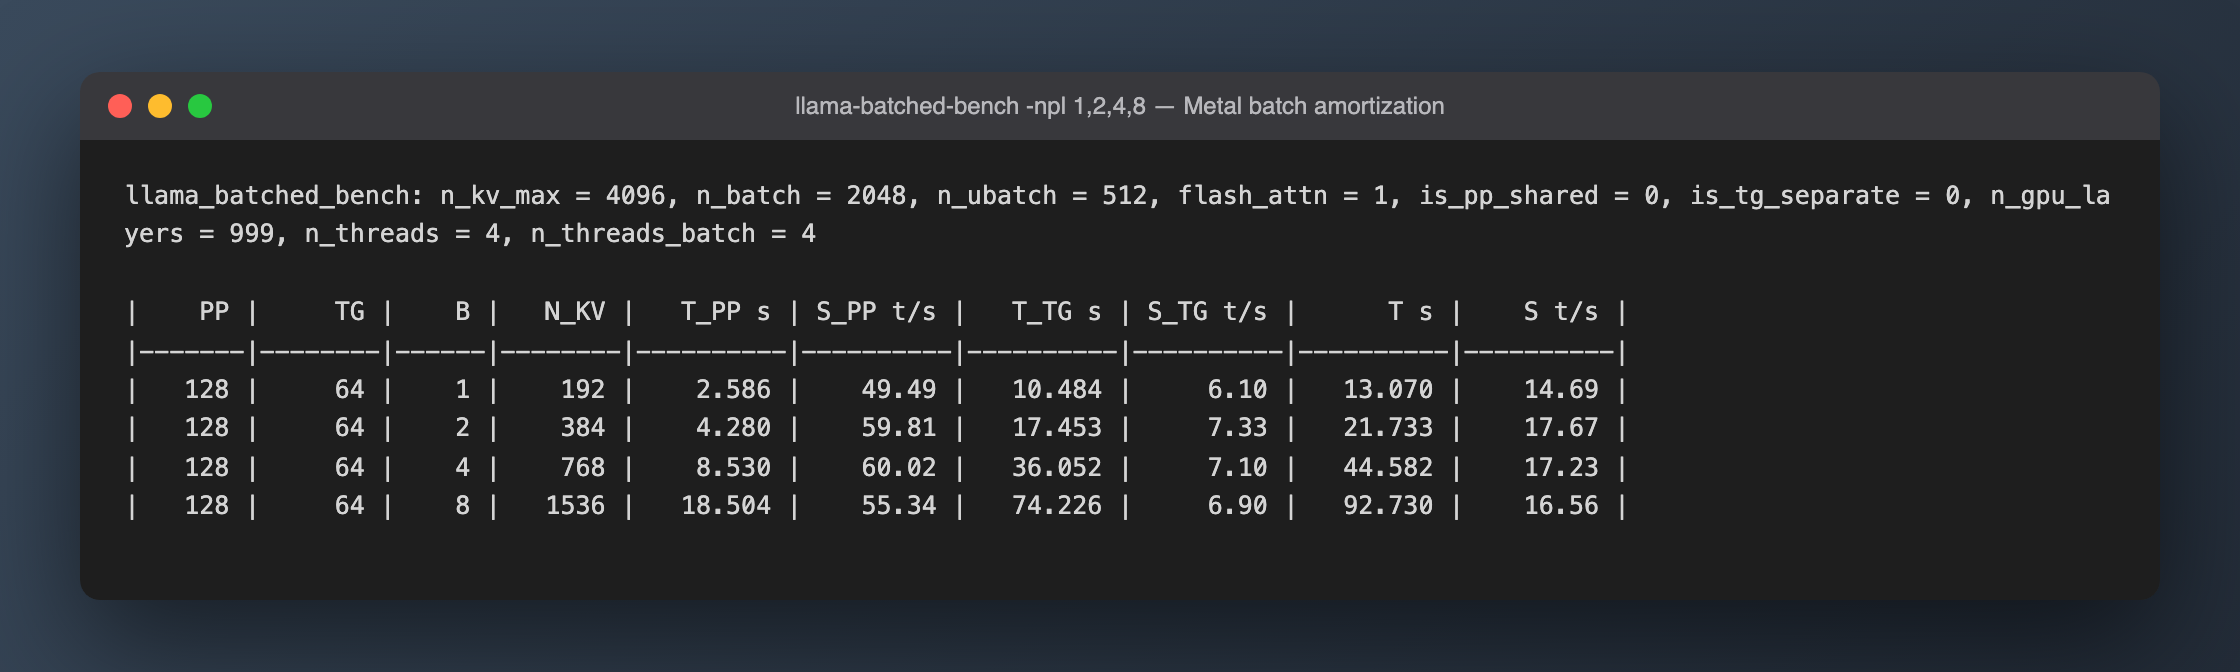
batch 1 解码 6.10 tok/s,batch 8 聚合吞吐也只有 6.90 tok/s——摊薄 1.13x,理想值是 8x。也就是说在 Metal 上验证 8 行的代价约等于 7 次完整前向。投机解码"验证一整块近似免费"的前提在这个后端上根本不成立:验证 3 行草稿(n-max 2 时是 2+1 行)就付了近 3 倍的钱,接受率再高也赚不回草稿成本。社区深测把线索指向 Metal 内核的一个门槛值(ne11_mm_min = 8:不足 8 行的 batch 进不了矩阵-矩阵内核,K-quant 走小 batch 路径还有额外限制)——这解释了为什么同样的量化模型在 CUDA 上 batch 8 摊薄有 3.34x。
2. 散文比代码亏得多,方向与社区一致,幅度不同。 散文接受率低(59%)、验证轮次多,-24% 与社区深测的 -2224% 完全吻合;但代码提示词我测出来是 -4%,社区是 +910%。方向都是"代码远好于散文",正负号差异大概率来自提示词不同(我的 LRU cache 平均接受长度 2.70,社区代码题更长)——这也说明在 Metal 上就算是最优场景也只在盈亏线附近晃。
3. greedy 无损性有个反直觉的注脚。 n-max 2 的 400 token 输出与 baseline 逐字一致(散文代码都是);但 n-max 4 的散文在第 1294 字符处分叉("More critically," 变成 "Furthermore,"),且该分叉自身两轮完全可复现。投机解码数学上无损指的是分布无损;不同验证宽度走不同的 Metal 内核路径,浮点数值有微小差异,greedy 采样在两个 token 概率几乎打平处就可能翻转。对质量无影响,但"逐字节可复现"这个性质只在固定配置内成立。
4. 内存账如预期。 省下的正是那个 2B 草稿模型:16.0GB vs 19.4GB。llama.cpp 基线本身也比 MLX 低约 7%(5.97 vs 6.45 tok/s),这是两个推理栈对这套混合注意力架构的优化程度差异,社区注明该架构的 Metal 内核"还年轻,地板会随上游工作抬高"。
结论一句话:24G Mac 上想要投机解码加速,今天该用的是 DFlash 2 + MLX;原生 MTP 头在 Metal 上属于"接受率健康、验证亏钱",省 3GB 内存的代价是散文慢四分之一。 除非你的负载是纯代码生成且自己实测过盈亏,否则别开这个 flag。
踩坑清单
按遇到的顺序,前三个是脚本工程坑,后两个是实验设计坑:
- zsh 的
echo会吃掉 JSON 里的\n。 把 curl 响应存进变量再echo "$resp" > file,zsh 内建 echo 默认解释反斜杠转义,JSON 字符串里的\n变成真实换行,json.load报 "Invalid control character"。改成curl -o file直接落盘(或printf '%s')。 /usr/bin/time -l包装下,kill -INT $!杀的是 time 不是 llama-server。 time 进程收到 SIGINT 不转发,llama-server 还活着,脚本wait永久卡死。解法:pkill -INT -f "llama-server.*--port $PORT"直接按进程名打,峰值 RSS 依然能拿到。- llama-server 加载期
/health返回 503,但 curl 退出码是 0。 用curl -s -o /dev/null && break探活会在模型还没加载完时放行,后续请求全部拿到 503 错误 JSON、速度读数全是 0。必须判响应体:curl -s .../health | grep -q '"ok"'。 script命令的输出文件所在目录必须先存在,否则整个捕获会话直接失败——mkdir -p写在被捕获的脚本里没用,捕获还没开始。- 默认 batch size 会炸,且加载时看不出来。 社区在同款 M4 上踩过:
-b 2048时加载期分配只有 13.9GB 一切正常,生成中途 prompt batch 的瞬时分配才打爆 Metal(kIOGPUCommandBufferCallbackErrorOutOfMemory),服务端直接断言退出。我直接采用-b 512 -ub 512避开,全程无 OOM。
还值得盯的路线
- MLX 侧的原生 MTP:社区挑战赛里有人在 Apple 硬件上用 MTP 跑到 77 tok/s(机型未注明,大概率是 Ultra 级),暗示 MLX 的验证路径能摊薄——如果属实,"原生 MTP 在 Mac 上不行"就要改写成"llama.cpp 的 Metal 内核暂时不行",这正是社区深测留的头号悬念。
- llama.cpp 的
draft-dflash:这次翻--spec-type参数表时发现 DFlash 支持已经合并进 llama.cpp(上一篇写作时还在 PR 阶段)。GGUF 生态跑 DFlash 草稿模型 vs MLX 跑 DFlash,又是一组可以同机对照的实验。
本文全部性能数字为 2026-09-02 于 Mac mini M4 基础版 24GB(macOS 26.3.1、llama.cpp b96806d 当日 master 源码构建)一手实测,方法与 8 月 DFlash 2 实测同口径(greedy、400 token、生成阶段净速度);社区对照数据均已标注原始出处。Metal 后端对该架构的优化仍在快速迭代,结论有时效性。