24GB Mac mini 能跑多大的本地大模型?内存账、实测速度与提速方案汇总
一台 24GB 统一内存的 Mac mini 到底能跑什么模型?答案是:27B 的 4-bit 量化就是天花板,且我们真的把 Qwen3.8-27B 在 M4 丐版上完整跑通了——峰值内存 19.4GB,投机解码后 11.7-12.2 tok/s。本文汇总这台机器上的全部实测:各参数量级的内存账、速度预期、三条提速路线的真实效果(DFlash 2 / 原生 MTP / MLX vs llama.cpp),以及量化档位怎么选。
大模型量化到底损失多少精度?Q8 到 Q2 一张表说清,附 GGUF 怎么选
4-bit 量化会让模型变笨吗?Q3 还能不能用?本文基于 llama.cpp 官方对 Llama-3-8B 全量化档位的 PPL/KLD 实测数据,把 Q8_0 到 IQ1_S 每一档的精度损失讲清楚,给出'内存装得下的前提下选最高档'的具体选择路径,并回答 Q4 与 Q8 差多少、imatrix 有什么用、1.58-bit 是怎么回事等高频问题。
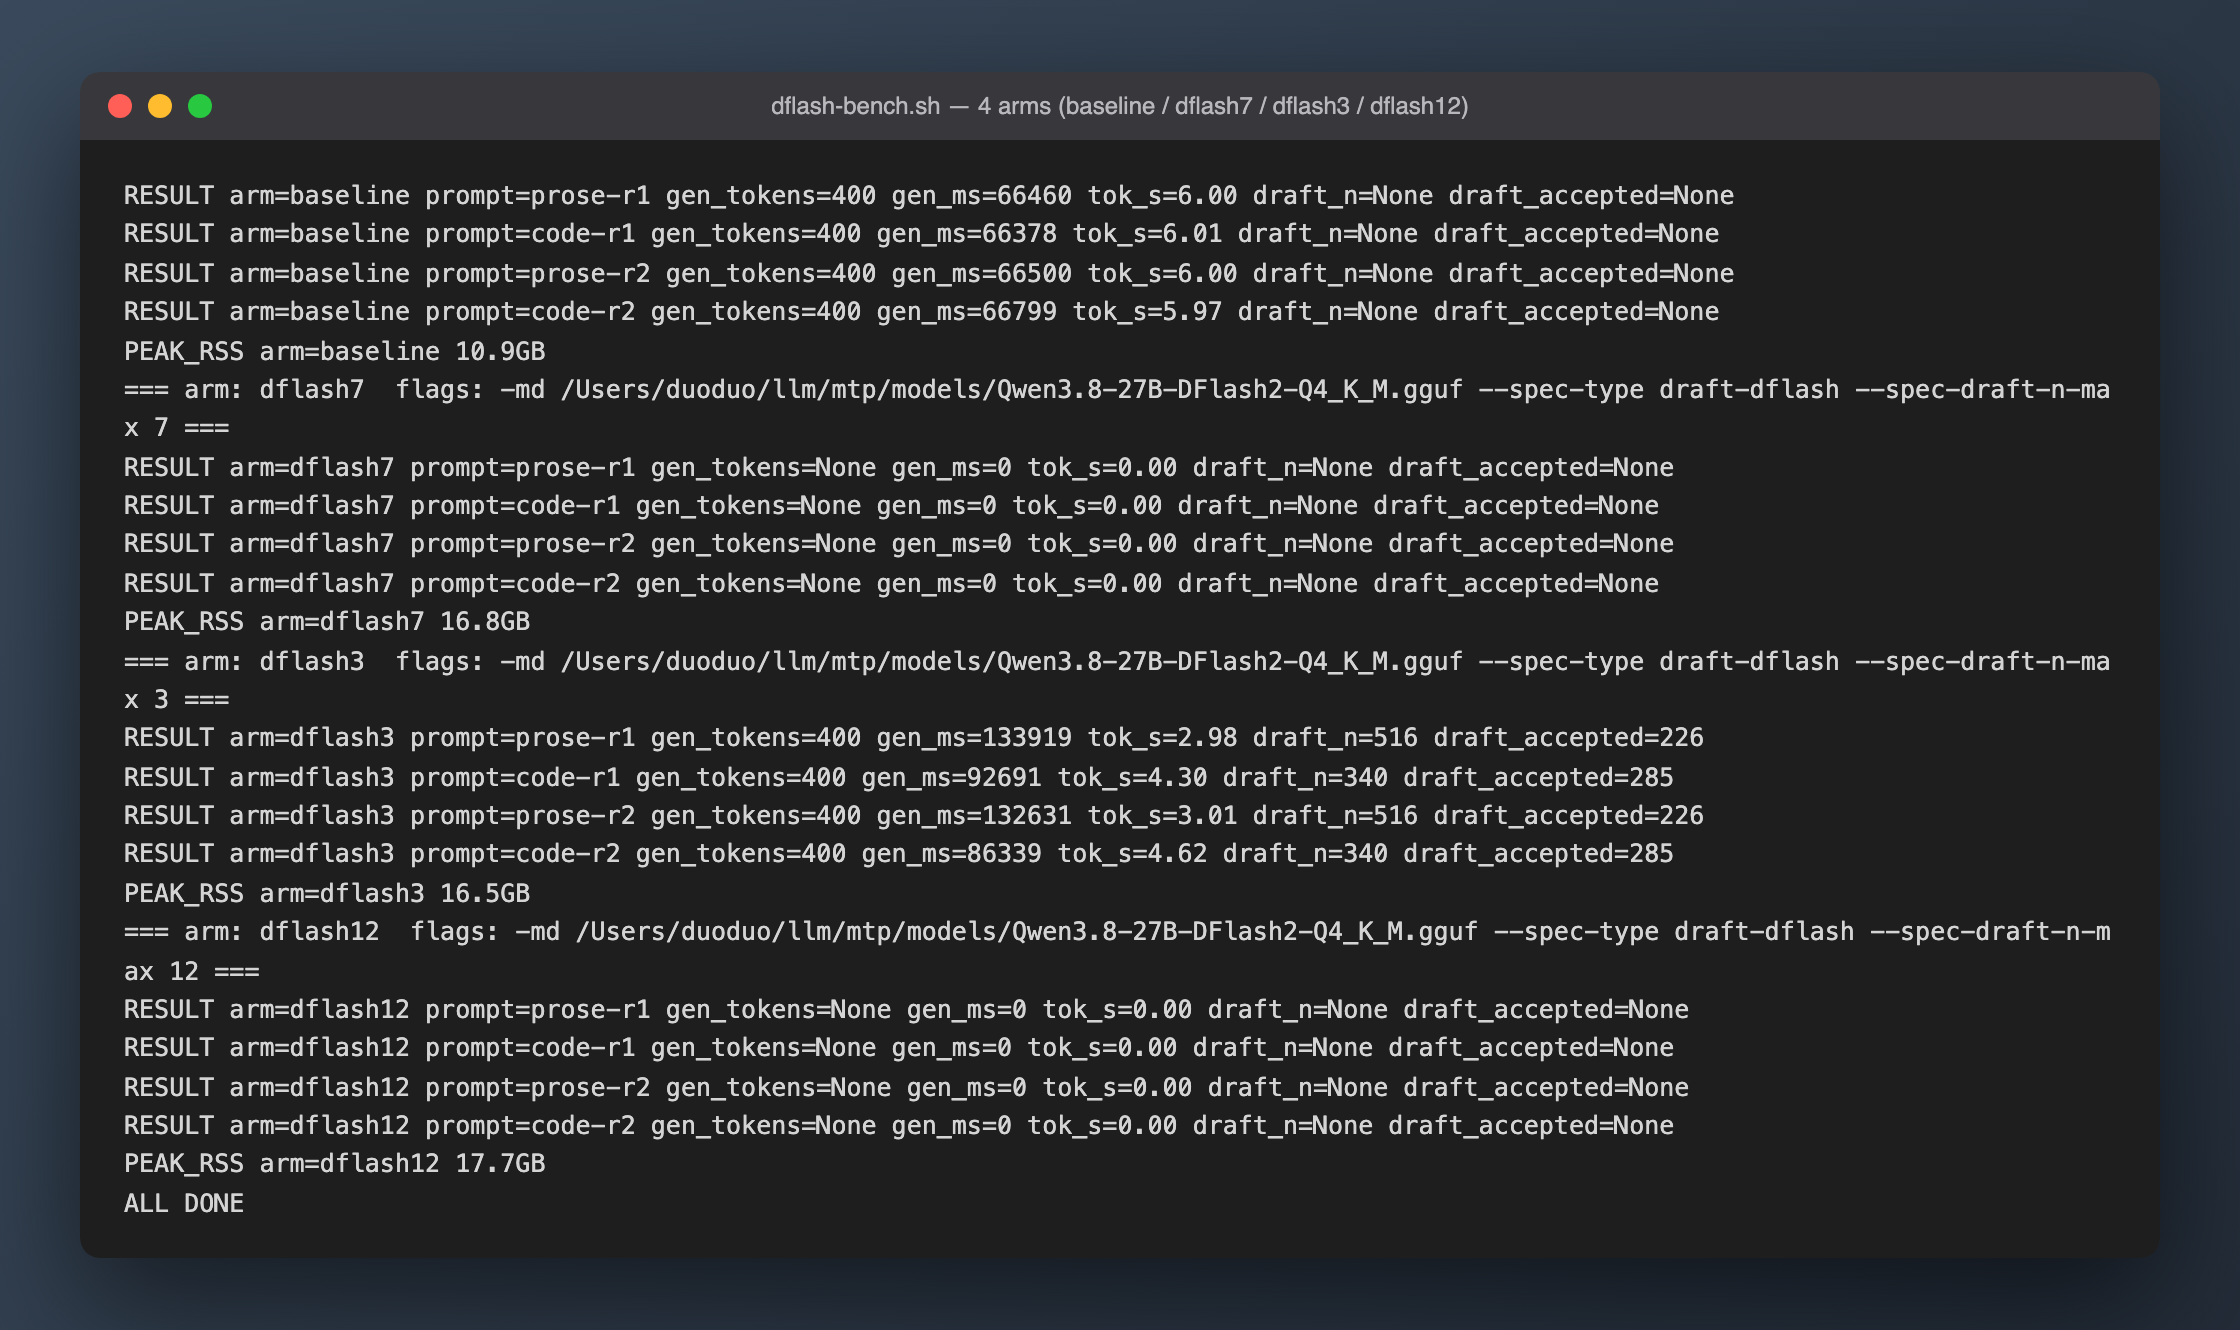
同一台 24G Mac mini、同一个 DFlash 2:MLX 上加速 1.9x,llama.cpp 上减速 50% 还 OOM
投机解码三部曲第三篇。llama.cpp 合并了 DFlash 2 支持、官方还发了配套 GGUF 草稿模型,理论上这是比外挂 MLX 更顺手的路线——实测结果是全配置净减速:官方推荐的 n-max 7 在 24G 机器上可复现 Metal OOM,能跑起来的 n-max 3 散文掉一半(6.0 → 3.0 tok/s),代码接受率高达 83.8% 也还亏 23%。同一个算法、同一台机器,MLX 栈是 1.8–1.9x。用真实数据算清一笔账:这条栈上每个投机步实测均摊 0.77 秒,就算接受率 100% 也追不回本。
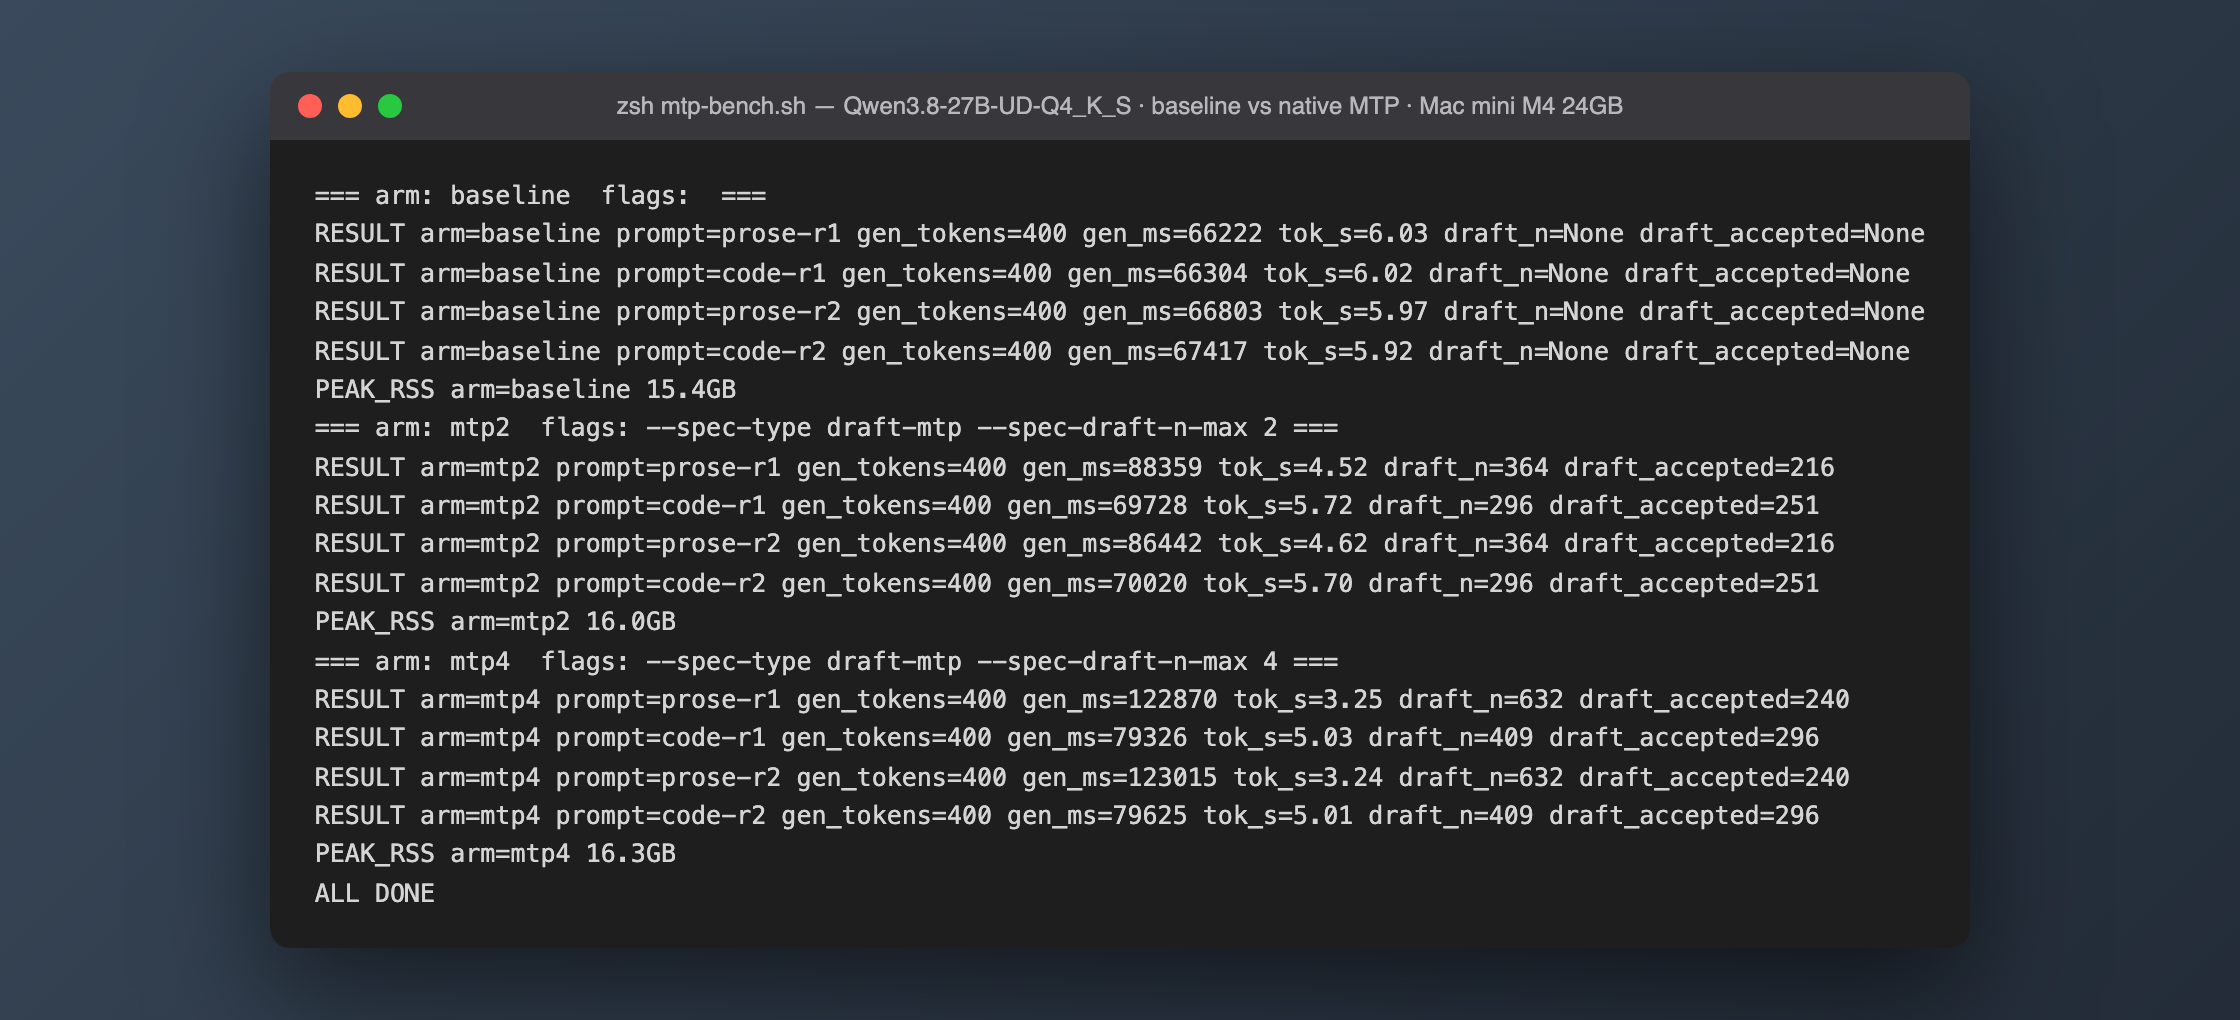
24G Mac mini 实测 Qwen3.8 原生 MTP:内存省了 3GB,速度反而降了 24%——与 DFlash 2 同机对照
上一篇 DFlash 2 实测结尾预告过的路线:Qwen3.8 自带训练好的 MTP 多 token 预测头,llama.cpp 已支持直接挂载,不需要额外 2B 草稿模型。这次在同一台 24G Mac mini M4 上把它跑通并与 DFlash 2 正面对照:内存确实更省(峰值 16.0GB vs 19.4GB),但速度是净减速——散文 6.0 → 4.5 tok/s(-24%),代码也没赚。同机 DFlash 2 是 1.8–1.9x 加速。差距不在草稿质量(接受率 59–85% 很健康),在 Metal 后端:batch 8 解码摊薄实测只有 1.13x,验证 3 行草稿的代价≈3 次完整前向,草稿再准也赚不回来。
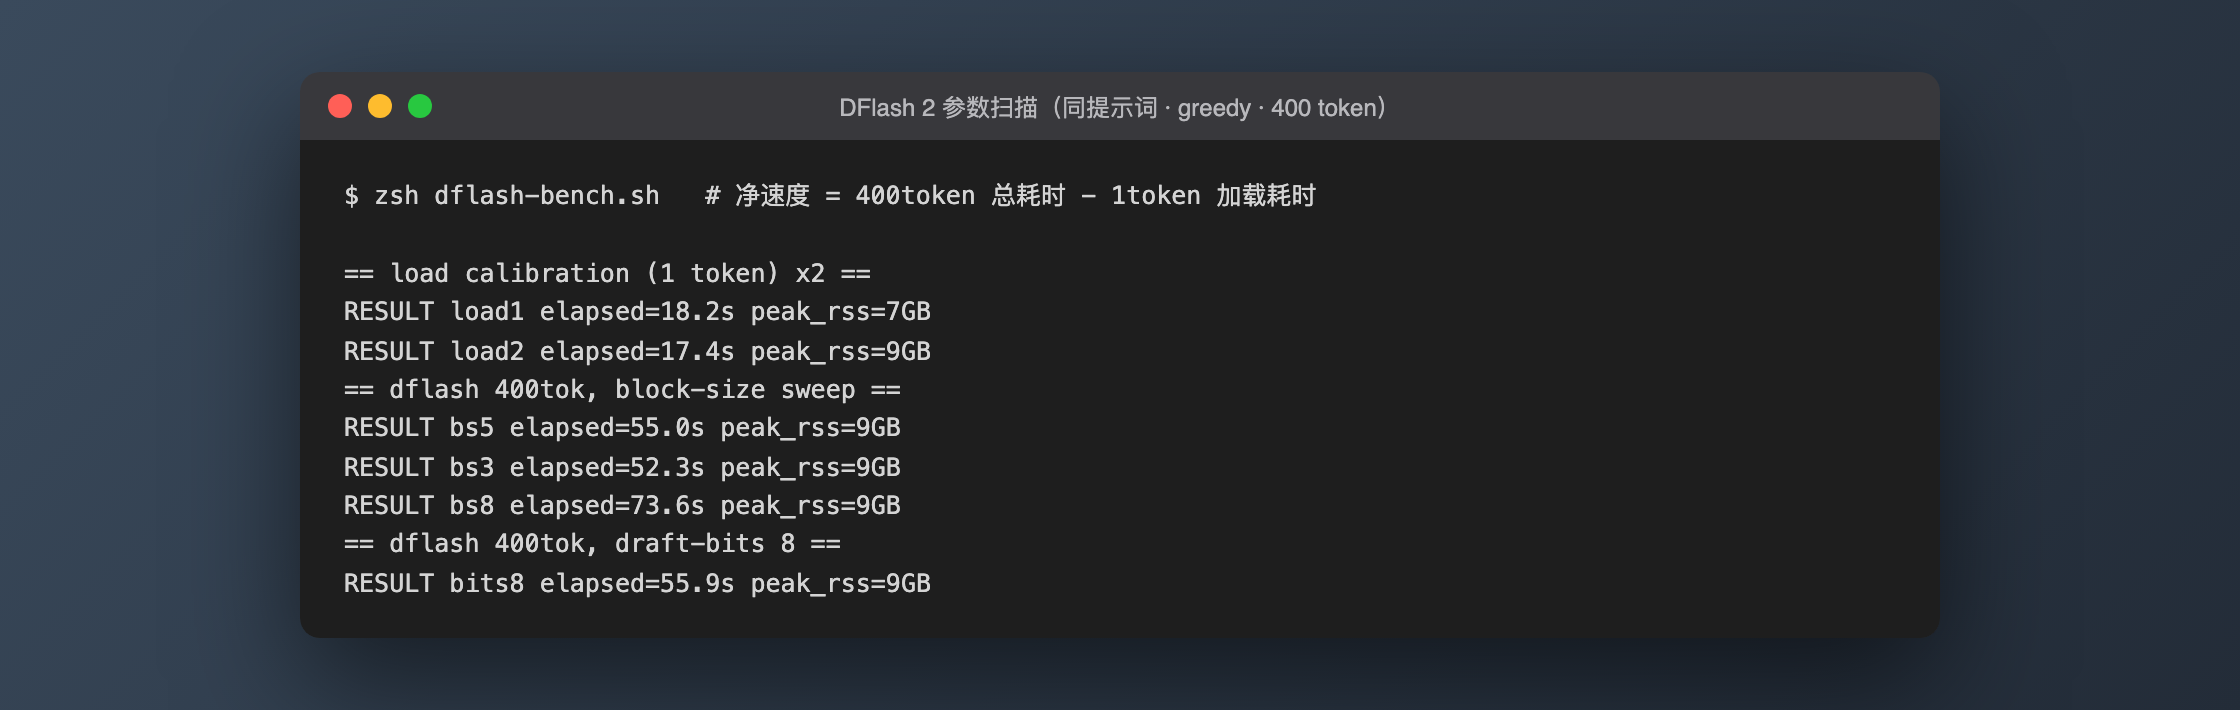
24G Mac mini 跑 Qwen3.8-27B + DFlash 2:实测 1.8x,以及为什么到不了官方的 3x
DFlash 2 发布一周后,我在一台 24G 的 Mac mini M4 上把 Qwen3.8-27B 加投机解码完整跑通:4-bit 量化下从 6.5 tok/s 提到 11.7–12.2 tok/s,稳定 1.8–1.9 倍。这篇记录完整部署命令、三轮对照实测数据、24GB 的内存账,以及官方 2.7–3.4x 数字在消费级 Mac 上打折的三个具体原因。8-29 复测追加 block-size 与草稿精度扫描:block-size 8 崩到 1.11x 坐实官方悬崖警告,block-size 3 反超默认值,8-bit 草稿不如 4-bit。
Qwen3.8 27B:本地模型新标杆,但请先关掉默认推理档
一个 17GB 的量化文件拿下 Artificial Analysis 52 分、画出本地模型史上最好的鹈鹕,但 Simon Willison 实测同一个任务默认档要 21 分钟、关掉推理只要 137 秒。这篇拆解 Qwen3.8 27B 的真实水平、「过度思考」的量化证据,以及 reasoning_effort 到底该怎么调。