24G Mac mini 跑 Qwen3.8-27B + DFlash 2:实测 1.8x,以及为什么到不了官方的 3x
24G Mac mini 跑 Qwen3.8-27B + DFlash 2:实测 1.8x,以及为什么到不了官方的 3x
2026 年 8 月是本地模型玩家的好月份:8 月 14 日 Qwen3.8-27B 开源权重,8 月 18 日 Inco AI 发布 DFlash 2,并直接放出了对应 Qwen3.8-27B 的草稿模型。官方博客里的数字很漂亮:SGLang 上 batch size 1 达到自回归解码 2.7–3.4 倍的吞吐。
问题是,那是数据中心 GPU 上的数字。我手上是一台 24GB 内存的 Mac mini。这篇文章回答三个问题:能不能跑起来?实际快多少?差距差在哪?
先给结论:能跑,稳定 1.8–1.9 倍(6.5 → 11.7–12.2 tok/s),全程三轮对照实测,波动 5% 以内。27B 模型从"勉强能看"提到"流畅阅读",这台机器的形态被这两个 8 月的发布实质性改变了。
测试机器(如实交代)
| 项目 | 配置 |
|---|---|
| 机型 | Mac mini(Mac16,10),2024 款丐版档位 |
| 芯片 | Apple M4(基础版,非 Pro/Max) |
| CPU | 10 核(4 性能 + 6 能效) |
| GPU | 10 核,Metal 4 |
| 内存 | 24GB 统一内存(M4 基础版带宽规格 120GB/s) |
| 系统 | macOS 26.3.1 |
强调"基础版 M4"是因为它直接决定结果:本地 LLM 解码是内存带宽瓶颈型任务,M4 Pro(273GB/s)和 M4 Max 的绝对速度会明显更高,但加速比(本文的主角)主要由算法和量化配置决定,参考价值是通用的。
为什么走 MLX,而不是 vLLM / SGLang
DFlash 2 官方支持四条路:SGLang、vLLM、llama.cpp(PR 阶段)和 MLX。前两条都是 CUDA 生态,Mac 上不用想。而 z-lab/dflash 官方仓库直接内置了 Apple Silicon 的 MLX 后端,README 明确列出 DFlash 2 对 Qwen3.8-27B 的 MLX 支持——这不是社区 hack,是第一方路径。
部署:四条命令
# 1. 环境(Python 3.12:3.14 对 MLX 生态还太新,别冒险)
mkdir -p ~/llm/dflash && cd ~/llm/dflash
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python "dflash[local]"

# 2. 模型(共约 19GB 下载)
.venv/bin/hf download mlx-community/Qwen3.8-27B-4bit    # 目标模型 15G
.venv/bin/hf download z-lab/Qwen3.8-27B-DFlash2         # 草稿模型 3.85G

# 3. 验证 MLX 跑在 GPU 上
.venv/bin/python -c "import mlx.core as mx; print(mx.default_device())"
# 期望输出: Device(gpu, 0)

# 4. 生成
.venv/bin/dflash generate mlx \
    --model mlx-community/Qwen3.8-27B-4bit \
    --draft z-lab/Qwen3.8-27B-DFlash2 \
    --draft-bits 4 --block-size 5 --reasoning low \
    "你的问题"
两个参数不能乱改:
--block-size 5:官方 README 明确要求量化模型下 block_size ≤ 5——MLX 当前的量化 matmul 内核在更大验证宽度下效率不升反降。这个限制是 Mac 上加速比的天花板之一,后面细说。--draft-bits 4:草稿模型下载的是 BF16(3.85GB,约 2B 参数),加载时现场压成 4-bit,内存里只占约 1GB。
实测:三轮对照,方法先说清
对照方法:同一提示词(约 300 词的英文短文写作任务)、greedy 解码(temperature 0)、固定生成 400 token。基线用 mlx_lm 直接跑目标模型(dflash CLI 的本地后端强制要求 --draft,跑不了纯自回归)。DFlash 的净生成速度 = 全程耗时减去纯加载耗时(用只生成 1 个 token 的运行单独实测,约 19–20.5 秒)。
| 轮次 | 基线(纯自回归) | DFlash 2 | 加速比 |
|---|---|---|---|
| 第 1 轮 | 6.48 tok/s | ~11.7 tok/s | 1.80x |
| 第 2 轮 | 6.40 tok/s | ~11.7 tok/s | 1.83x |
| 第 3 轮 | 6.50 tok/s | ~12.2 tok/s | 1.88x |
第 2、3 轮之间我清掉了所有后台程序,数字几乎没动——瓶颈确实在内存带宽,不在 CPU 抢占。三轮波动 5% 以内,6.5 vs 11.7–12.2 tok/s 就是这台机器的定案数字。输出质量方面,投机解码在数学上是无损的(草稿只提候选,目标模型逐块验证),实测数学题答案正确、400 token 长文连贯,与理论一致。
体感差异比数字更直接:6.5 tok/s 读起来要等字蹦;11.7 tok/s 已经接近正常阅读速度。
复测(8 月 29 日):数字站得住,外加两个新发现
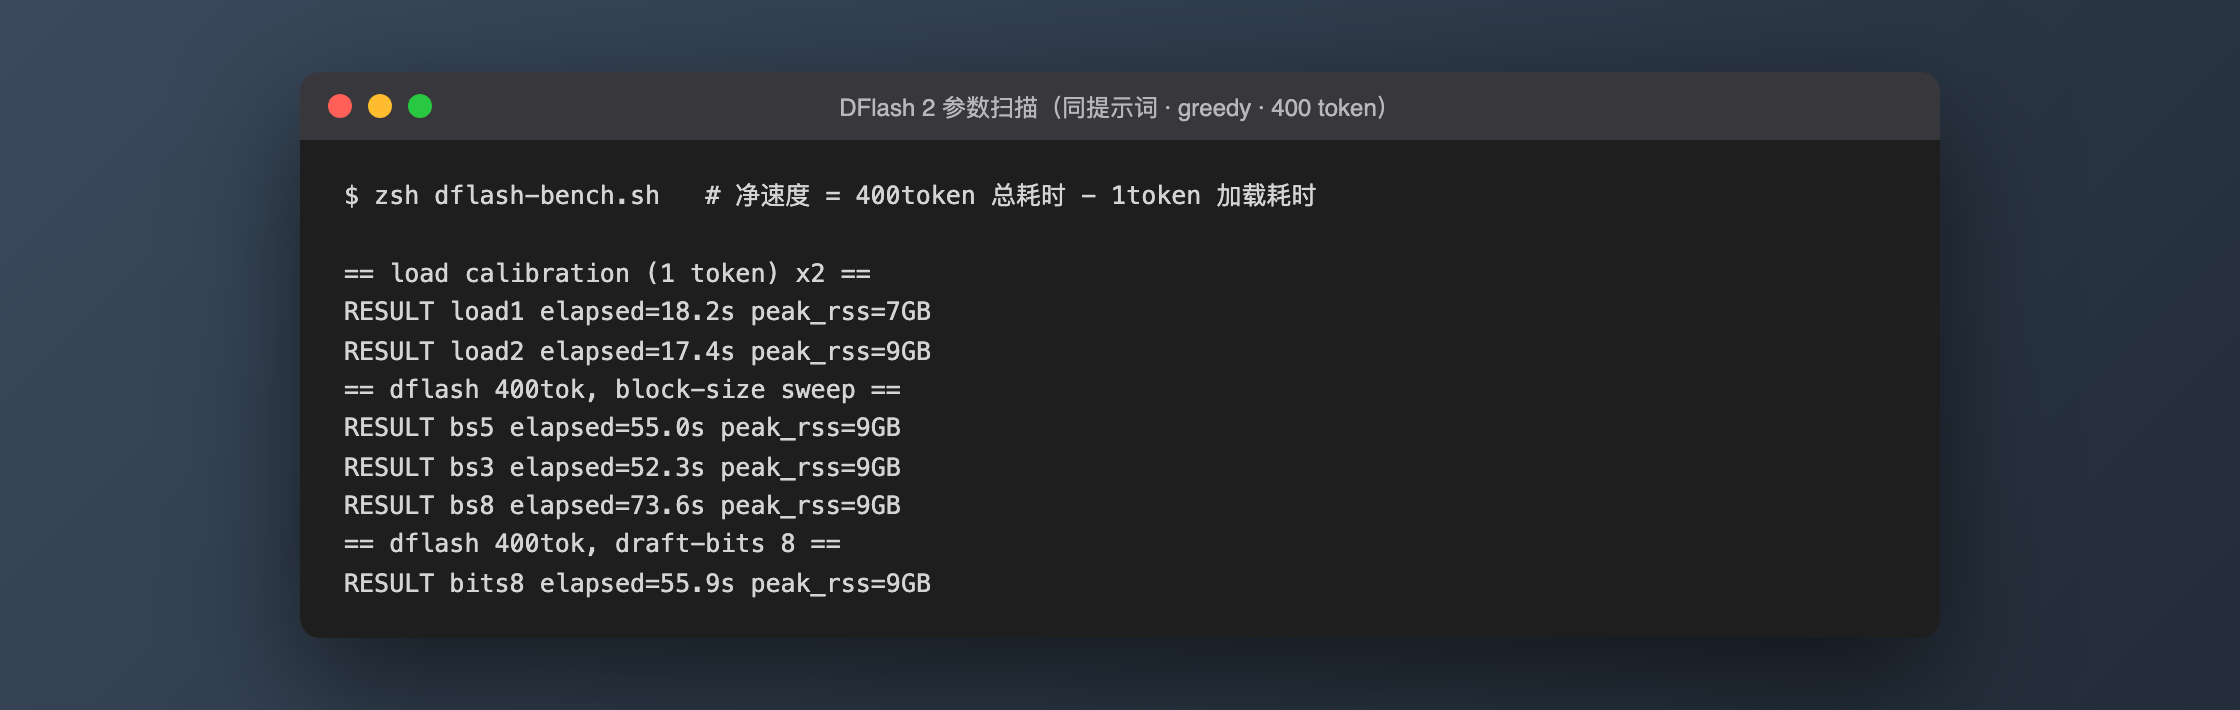
首测 6 天后重新跑了一遍全流程,并补上首测没做的参数扫描。方法同前:同一提示词、greedy、400 token,净速度 = 总耗时减去 1-token 加载标定(本轮实测 17.4–18.2 秒)。
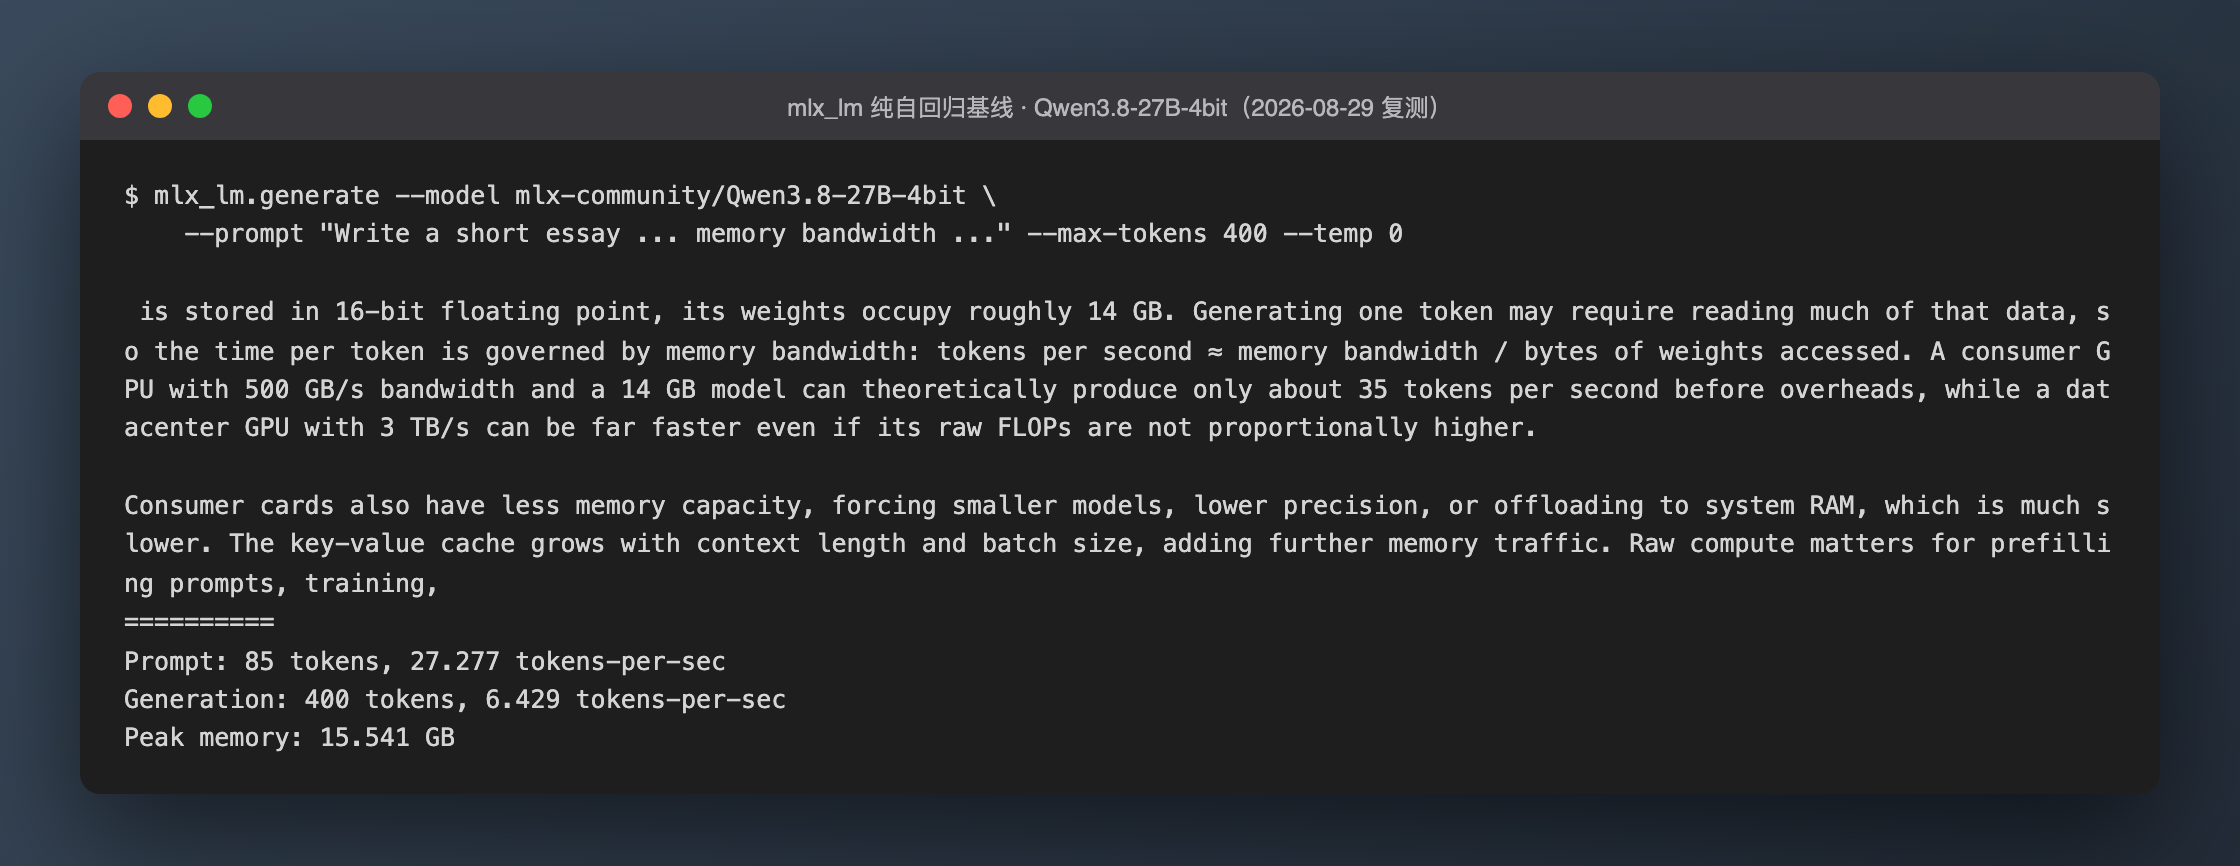
基线先复现:mlx_lm 两轮 6.43 / 6.51 tok/s,Peak memory 15.54GB——与首测 6.40–6.50 完全吻合,一周内数字没漂:
然后是这轮的主菜——block-size 和草稿精度扫描:
| 配置 | 总耗时 | 净速度 | 加速比 |
|---|---|---|---|
| block-size 3 | 52.3s | 11.6 tok/s | 1.79x |
| block-size 5(默认) | 55.0s | 10.8 tok/s | 1.66x |
| block-size 8 | 73.6s | 7.2 tok/s | 1.11x |
| draft 8-bit(bs=5) | 55.9s | 10.5 tok/s | 1.62x |
两个新发现:
1. 官方的 block_size ≤ 5 不是保守建议,是真实悬崖。 硬把 block-size 拉到 8,加速比从 1.66x 直接崩到 1.11x——几乎白干。量化 matmul 内核在更宽验证块下的效率损失是实打实的,前文「天花板」一节的解释被这组数字坐实了。反过来,block-size 3 比默认的 5 还快了 7%:在带宽极度受限的基础版 M4 上,更小的验证块反而更划算,值得作为这台机器的新默认。
2. 草稿模型别用 8-bit。 直觉上草稿更精准 → 验收率更高 → 更快,实测却慢了 3%:草稿模型从 ~1GB 涨到 ~2GB,多吃的内存带宽比验收率带来的收益更贵。4-bit 草稿是对的默认。
另外两条顺带的验证:greedy 下 block-size 3、5 和 8-bit 草稿三轮的输出字节级完全一致(1792 字节一字不差)——「投机解码数学上无损」这句话拿到了最直接的证据;本轮复测是在后台挂着一个 Claude Code 会话的轻负载下跑的(首测第 2、3 轮是清场环境),bs5 的 10.8 比首测的 11.7 低约 8%,但加速比量级不变——结论对日常使用场景同样成立。
官方 2.7–3.4x,我这里 1.8x:差距在哪
三个原因,都具体:
1. 量化砍了验证宽度。 DFlash 的加速原理是"一次前向验证一整块草稿 token",块越宽、单次验证摊薄的成本越多。官方数字用的是未量化模型和更宽的推测窗口(SGLang 配置 --speculative-num-draft-tokens 8);而 MLX 的量化 matmul 内核限制 block_size ≤ 5,起步就少了将近一半的并行验证宽度。
2. 4-bit 下验证的边际成本更高。 投机解码的收益公式里,"验证 k 个 token 的耗时 ≈ 验证 1 个"这个近似在带宽极度受限、算子效率打折的场景下成立得更差——每宽一位都要多付一点真实代价。
3. 官方数字本来就是最优场景。 2.7–3.4x 出自 DFlash 2 博客的 SGLang 数据中心场景(batch size 1);DFlash 论文摘要里"6x 无损加速"更是跨模型跨任务的峰值口径。拿消费级 Mac 对标这些数字本身就不公平——反过来说,在这么多打折项下还剩 1.8–1.9x,这套方法的含金量是实打实的。
24GB 的内存账
这台机器能装下,但账要算到 GB 级:
| 项目 | 占用 |
|---|---|
| 目标模型(4-bit) | ~15GB |
| 草稿模型(4-bit 加载后) | ~1GB |
| KV cache + 运行时开销 | ~1–3GB(随上下文长度涨) |
| 实测峰值内存足迹 | 19.4GB(/usr/bin/time -l 实测) |
24GB 机器上 macOS 默认给 GPU 的 wired 内存上限约在总内存的 75%(约 18GB)一线,我的实测峰值已经贴着甚至越过这条线(footprint 含非 wired 部分),所以两条实用建议:跑之前关掉浏览器大标签页和 IDE;上下文别贪长,从 8K 起步观察内存压力再加。Qwen3.8 的混合注意力架构(48 层 DeltaNet 线性注意力 + 16 层全注意力)在这里帮了忙——四分之三的层不随上下文涨 KV。
另外别试 BF16 或 8-bit:27B 的 BF16 权重 55.6GB,8-bit 也要 28GB 上下,这台机器 4-bit 是唯一解。也别低于 4-bit——社区多方实测反馈质量在 4-bit 以下断崖式下跌。
踩坑清单
按遇到的顺序:
- dflash CLI 本地后端必须带
--draft,想跑纯自回归基线要换python -m mlx_lm generate。 - Python 选 3.12。系统自带 3.14 太新,MLX 生态的轮子跟进有滞后,不值得当小白鼠。
- 国内网络 Hugging Face 下载要挂代理,
HTTPS_PROXY环境变量对hf download生效。 --reasoning档位影响体感:Qwen3.8 默认xhigh会先输出大段思考再给答案,日常问答用low,答案直出。- 冷加载约 20 秒(16GB 权重从 SSD 进内存 + 草稿模型现场量化),这是每次进程启动的固定成本,频繁调用应该起常驻服务而不是反复跑 CLI。
还值得盯的两条路线
- llama.cpp 路线:DFlash 2 官方博客给出了 llama.cpp PR #27342 的 GGUF 部署方式(
Q4_K_M目标 + GGUF 草稿),合并后会是更省内存的选择,值得等。 - Qwen3.8 原生 MTP 头:模型自带训练好的多 token 预测头,llama.cpp 已支持挂载(ggml-org 仓库有独立的 MTP GGUF),不需要额外 2B 草稿模型,是 24GB 机器上更抠内存的方案——代价是加速比路线不同,值得单独对照实测一次。
本文全部性能数字为 2026-08-23 首测、2026-08-29 复测于上述同一台机器的一手实测;官方口径数字均已标注原始出处。模型和工具都发布不满一个月,结论有时效性。