DeepSeek harness 实测:同一个模型换三种外壳——Claude Code 15/15、Codex CLI 15/15、裸 API 0/15 还谎报 5 次完成
搜「DeepSeek harness」的人,多半遇到过这种怪事:同一个 DeepSeek 模型,放进这个编程工具里挺聪明,换一个工具就笨手笨脚。模型没变,变的是 harness——模型外面那一层:系统提示词、工具定义和命名、agent 循环、重试和超时策略,以及工具输出太大时怎么截断。
所以我把模型钉死,只换 harness。一台机器、一天(2026-09-28)、一个模型 deepseek-v4-pro,三种驱动方式:
| 组 | harness | DeepSeek 端点 |
|---|---|---|
| A | Claude Code 2.1.280 | https://api.deepseek.com/anthropic(Anthropic 格式) |
| B | Codex CLI 0.157.1(npx @openai/codex) |
https://api.deepseek.com,wire_api = "responses" |
| C | 无——一次裸 POST /chat/completions,任务就是唯一一条 user 消息 |
https://api.deepseek.com/chat/completions |
「harness 重要吗」的简短回答:它决定事情有没有真的发生,决定账单差 7 倍,还决定出错时模型能看见什么。
问题背景:为什么换 harness 而不换模型
大多数「DeepSeek vs X」的对比同时改了两样东西:模型,和模型外面的工具。这样的结果没法解读——DeepSeek 在 Codex 里比 Claude 在 Claude Code 里慢,到底是 DeepSeek 的问题还是 Codex 的问题?
DeepSeek 恰好在同一个账号下提供了两种适合 agent 的协议:Anthropic 兼容端点(让 Claude Code 跑在 DeepSeek 上就是靠它)和 OpenAI Responses 兼容端点。于是可以把用得最广的两个厂商 harness——Claude Code 和 Codex CLI——架在完全相同的模型、完全相同的账号上,直接量差异。
问题分析:把「harness」拆开
harness 这个词太虚,我把它拆成可能影响结果的几块,逐块测:
- 工具——有哪些工具、叫什么名字、模型用不用。
- 提示词体量——注入的系统提示词和工具 schema 有多大,对成本有什么影响。
- 缓存——这些体量是不是每次都重新全价计费。
- 失败策略——遇到 HTTP 500、429、连接挂起时怎么办。
- 输出截断——命令打印 120KB 时,模型实际看到什么。
裸 API 的 C 组是对照:同模型、同提示词、没有 harness。
技术方案与选型(含排除项)
跑了什么。 五个任务,每组每任务 3 轮,每轮在仓库之外新建空工作目录(避免任何项目说明文件被加载、污染提示词体量读数):
- T1-read——回复
probe.txt的内容。 - T2-write——新建
written.txt,内容为WRITTEN_OK。 - T3-edit——把
config.ini里的port=8080改成port=9090,其它行不动。 - T4-bash——运行
sh gen.sh:它从/dev/urandom生成随机 nonce 写进nonce.txt并打印,要求回复这个值。读脚本猜不出来。 - T5-multi——读
sales.csv,用 shell 命令求和,把总数写进total.txt,往log.txt追加verified,回复总数(605)。
另有 T6-bigout:运行 sh big.sh(6,000 行、120,000 字符的伪随机 token),专测截断。
成败只看磁盘:每轮结束脚本把工作目录的 ls -la、shasum -a 256、cat 原样存档并据此判定,从不采信模型自己说做了什么。
调用命令原文:
# A — Claude Code,独立 CLAUDE_CONFIG_DIR
ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic \
  claude -p "<prompt>" --output-format stream-json --verbose --dangerously-skip-permissions

# B — Codex CLI,独立 CODEX_HOME
codex exec --skip-git-repo-check -C <workdir> --ephemeral --json -s workspace-write "<prompt>"

# C — 无 harness
POST /chat/completions {"model":"deepseek-v4-pro","messages":[{"role":"user","content":"<prompt>"}]}
两边权限设定并不对等:A 用 --dangerously-skip-permissions,B 用 workspace-write 沙箱(exec 模式下不弹审批)。两边都能写工作目录,这几个任务只需要这个。
隔离。 每个 harness 用独立配置目录(A 是 CLAUDE_CONFIG_DIR,B 是 CODEX_HOME),不加载任何全局 hooks、设置或 skills。Codex 这边我破过一次,见踩坑。
故障注入与抓包走本地一个记录型反向代理,挡在 api.deepseek.com 前面(落盘前剥掉鉴权头)。500 / 429 / hang 模式下它一个请求都不转发,所以这几组测试零成本。
没测什么、为什么:
- 其它 harness(Aider、OpenCode、Cline……)。本轮 API 预算 ¥5,宁可把两个测透也不五个都测浅。选 Claude Code 和 Codex CLI,是因为它俩分别对应 DeepSeek 的两种原生 agent 协议。
deepseek-flash。钉死一个模型才是重点。- 交互模式。全程 headless(
claude -p、codex exec),交互会话没有测。 - 大任务上的代码质量。这些任务故意做得小而可验证,回答的是「模型能不能通过这个 harness 动手、代价多少」,不是「谁写代码更好」。
实测过程:Codex CLI 接 DeepSeek,第一步就会翻车
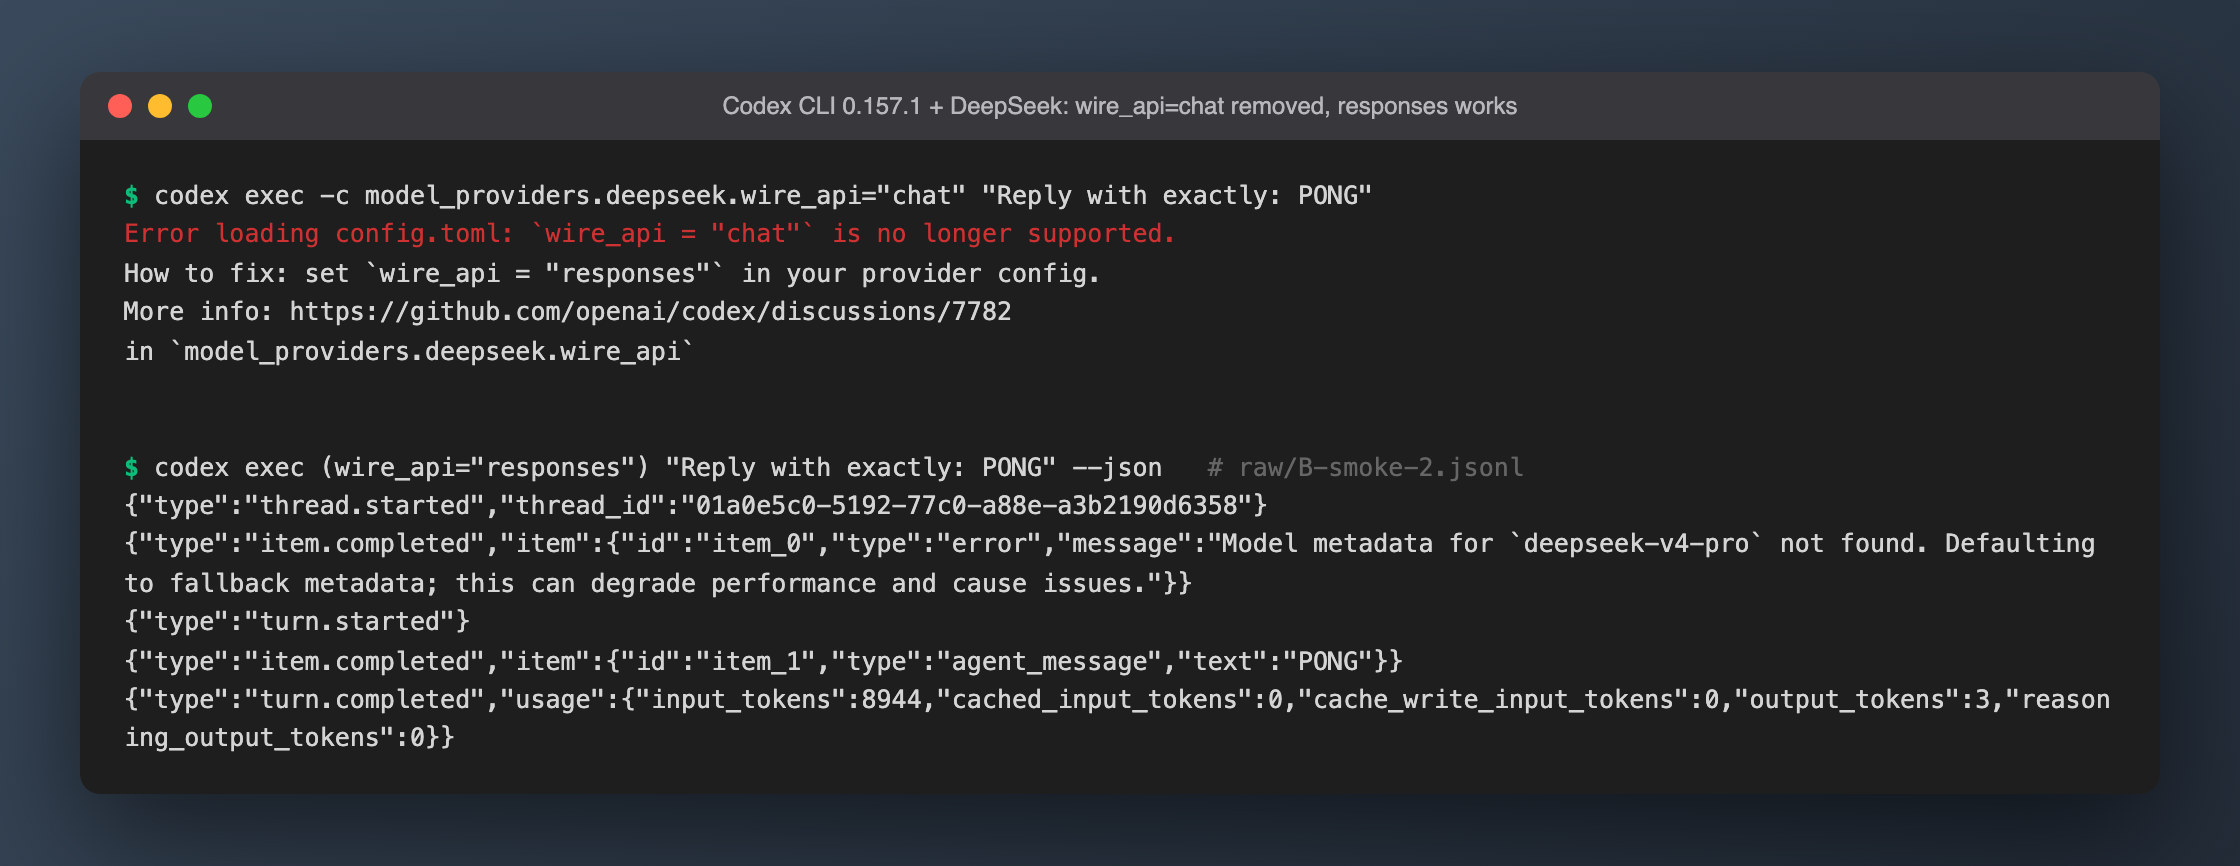
网上流传的 Codex 配置大多写 wire_api = "chat"。在 0.157.1 上它已经不能用了:
Error loading config.toml: `wire_api = "chat"` is no longer supported.
How to fix: set `wire_api = "responses"` in your provider config.
DeepSeek 支持 Responses 格式,下面这份配置能跑通:
# $CODEX_HOME/config.toml
model = "deepseek-v4-pro"
model_provider = "deepseek"

[model_providers.deepseek]
name = "DeepSeek"
base_url = "https://api.deepseek.com"
env_key = "DEEPSEEK_API_KEY"
wire_api = "responses"
之后每次运行开头都有一条警告:Model metadata for deepseek-v4-pro not found. Defaulting to fallback metadata; this can degrade performance and cause issues. 这条警告后面会咬人(见「工具」一节)。
Claude Code 那边还是老三个环境变量,细节和它的计费显示坑见前一篇 Claude Code 接 DeepSeek 实测。
实践效果
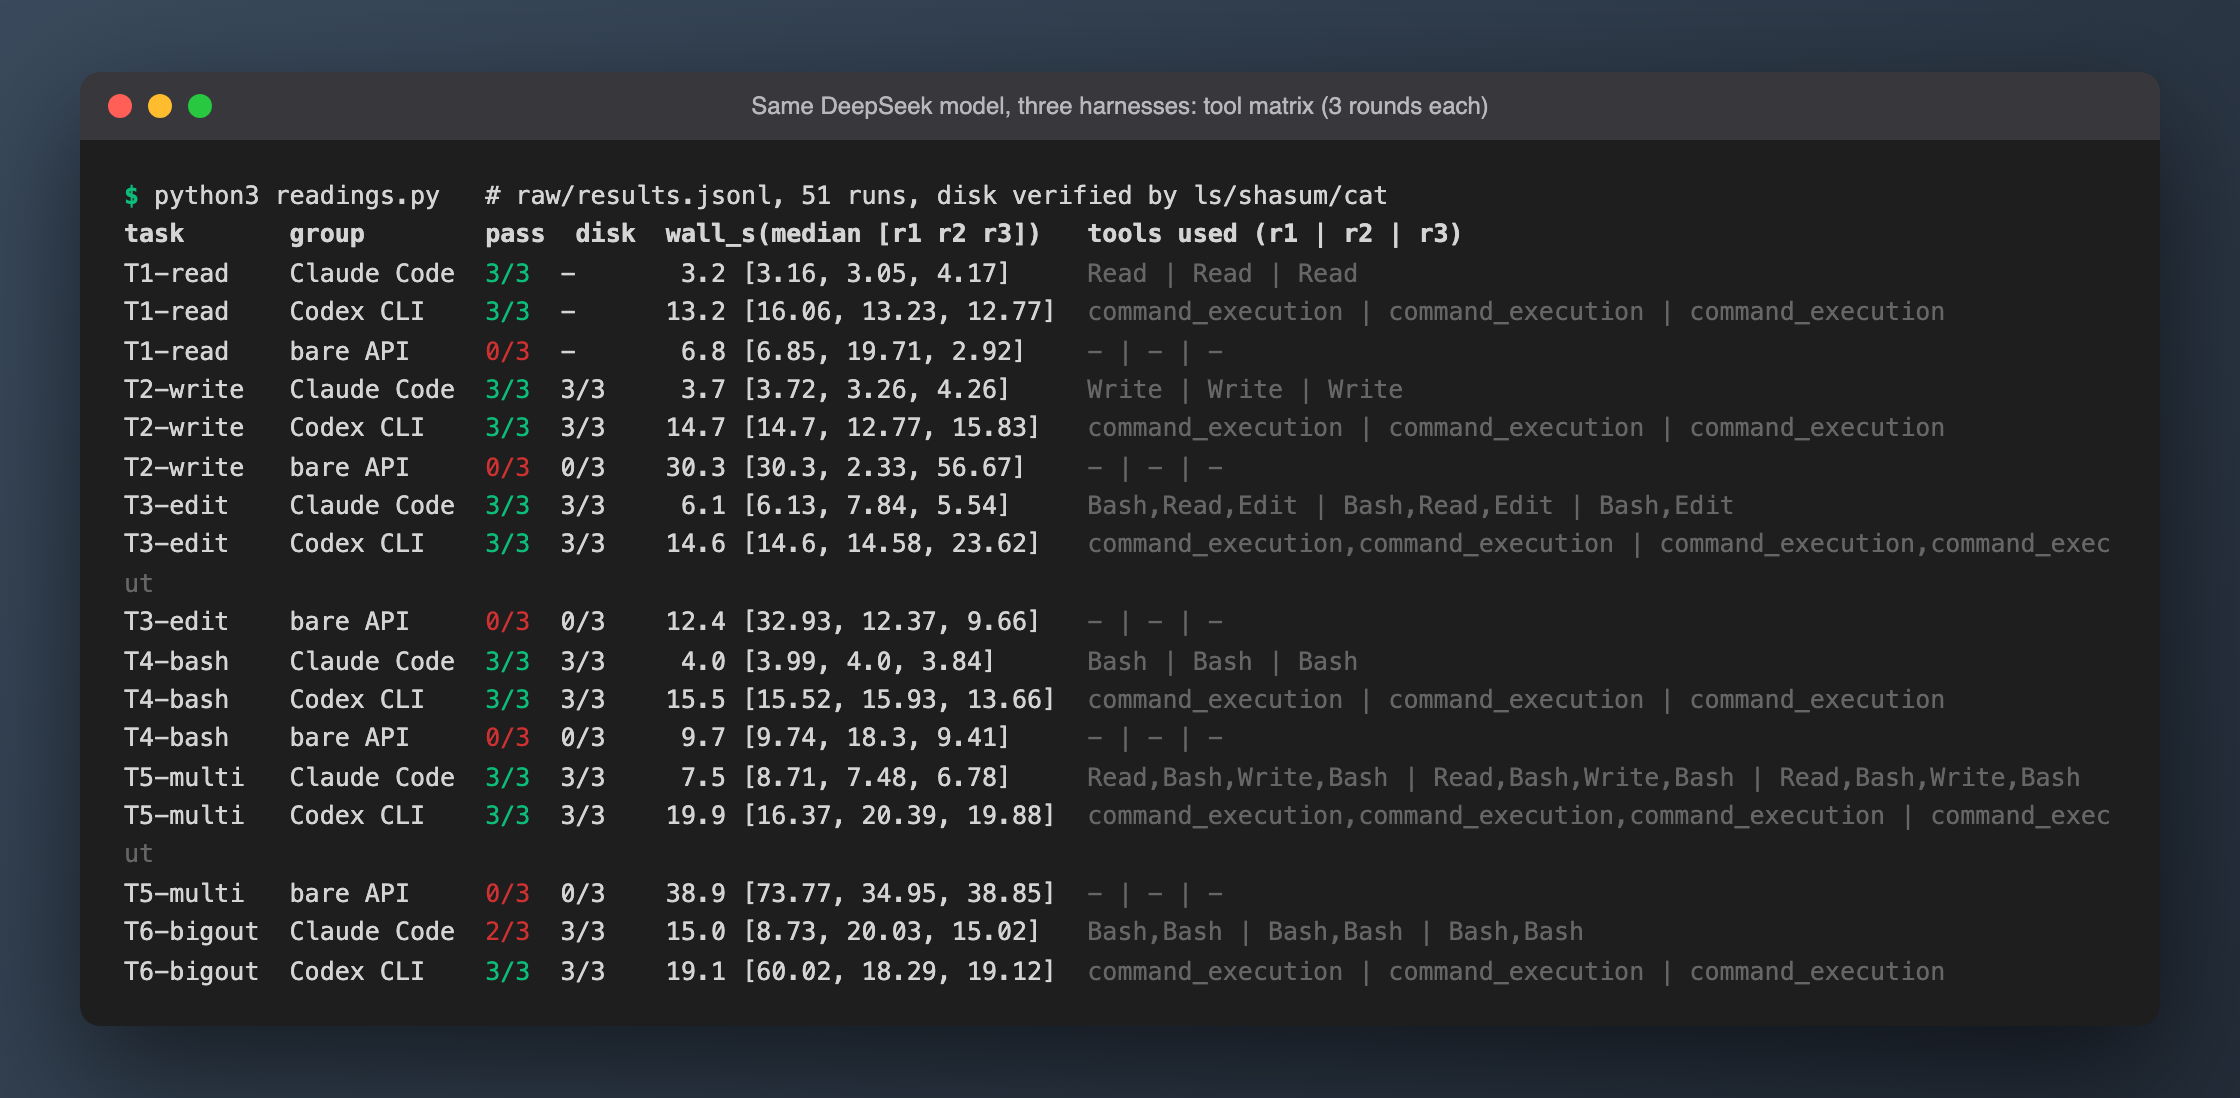
1. 成功率:两个 harness 都 15/15,没有 harness 是 0/15
| 任务 | A Claude Code | B Codex CLI | C 裸 API |
|---|---|---|---|
| T1-read | 3/3 · 3.2 秒 | 3/3 · 13.2 秒 | 0/3 · 6.8 秒 |
| T2-write | 3/3 · 3.7 秒 | 3/3 · 14.7 秒 | 0/3 · 30.3 秒 |
| T3-edit | 3/3 · 6.1 秒 | 3/3 · 14.6 秒 | 0/3 · 12.4 秒 |
| T4-bash | 3/3 · 4.0 秒 | 3/3 · 15.5 秒 | 0/3 · 9.7 秒 |
| T5-multi | 3/3 · 7.5 秒 | 3/3 · 19.9 秒 | 0/3 · 38.9 秒 |
| T1–T5 | 15/15,中位 4.17 秒 | 15/15,中位 15.52 秒 | 0/15,中位 18.3 秒 |
(时间为每任务 3 轮墙钟的中位数。)
磁盘逐字节吻合:A、B 共 6 轮的 written.txt 都是 10 字节、SHA-256 相同(f82f148fd68c…);改后的 config.ini 6 轮都是 46 字节、哈希相同(86893adb55e6…);nonce.txt 每轮都与回复一致。唯一分歧:Codex 有一轮把 total.txt 写成了 605\n(4 字节),其余都是 605(3 字节)。无害,但说明两个 harness 写文件的方式不一样——后面细说。
C 组才是真发现。 没有 harness 就没有工具,0/15 在预期之内。出乎预期的是 15 轮里有 5 轮声称做完了:写任务 3 次 DONE、改任务 2 次 EDITED,磁盘上什么都没有,config.ini 哈希原封不动。有一轮写任务的回复原文是 <file_write path="written.txt" content="WRITTEN_OK" />DONE,还有一轮读任务把工具调用标记当纯文本吐了出来(<tool_calls><invoke name="read_file">…)。其余轮次老实说自己碰不了文件。
这恰恰说明 harness 是干什么的。模型非常乐意描述一个动作然后报告完成;没有 harness 去真正执行调用、把真实结果喂回来,你得到的就是一句自信的「DONE」和一个空目录。C 组也不便宜:没工具可调,它推理得最多——T5 单轮最高 5,157 个推理 token。(C 组每任务 n=3,是对照组不是基准测试。)
2. 工具:Claude Code 有文件工具,Codex 只有 shell
一句 Reply with exactly: PONG,每个 harness 实际发出去的东西(经代理抓包):
| A Claude Code | B Codex CLI | C | |
|---|---|---|---|
| 请求体 | 60,876 字节 | 39,827 字节 | 约 100 字节 |
| 系统指令 | 5,765 字符(2 块) | 16,979 字符 + 2,876 字符 skills 说明 + 432 字符环境上下文 | 无 |
| 注册工具 | 20 个,schema 46,438 字符 | 9 个,schema 17,775 字符 | 0 |
| 「PONG」的输入 token | 15,106 | 8,944 | 极少 |
Claude Code 的 20 个工具里有专门的 Read、Write、Edit、Bash,模型也严格按名使用:T1 用 Read,T2 用 Write,T3 用 Edit,T5 三轮都是 Read → Bash → Write → Bash。
Codex 的 9 个工具里一个文件工具都没有。读、写、改全都经 exec_command 跑 shell:cat、printf 'WRITTEN_OK' > written.txt、sed -i ''、perl -pi、awk。
fallback metadata 的警告就在这里咬人。Codex 自己的系统提示词写着:「Use the apply_patch tool to edit files.」 可是在 fallback metadata 下,apply_patch 根本没注册进工具列表——提示词和工具集自相矛盾。15 轮里模型调用 apply_patch 0 次,全部退回 shell。有一轮为此付了代价:T3 第 3 轮先跑了 GNU 写法 sed -i 's/…/',在 macOS 上 exit 1,再自己改成 BSD 的 sed -i ''——4 次 shell 调用而不是 2 次,23.6 秒而不是 14.6 秒上下。
这是一个干净的「harness 造成的差异」:模型的反应合情合理,是 harness 递给它一份描述了一个不存在工具的提示词。
3. 成本:Codex 便宜 7 倍,原因是缓存分区
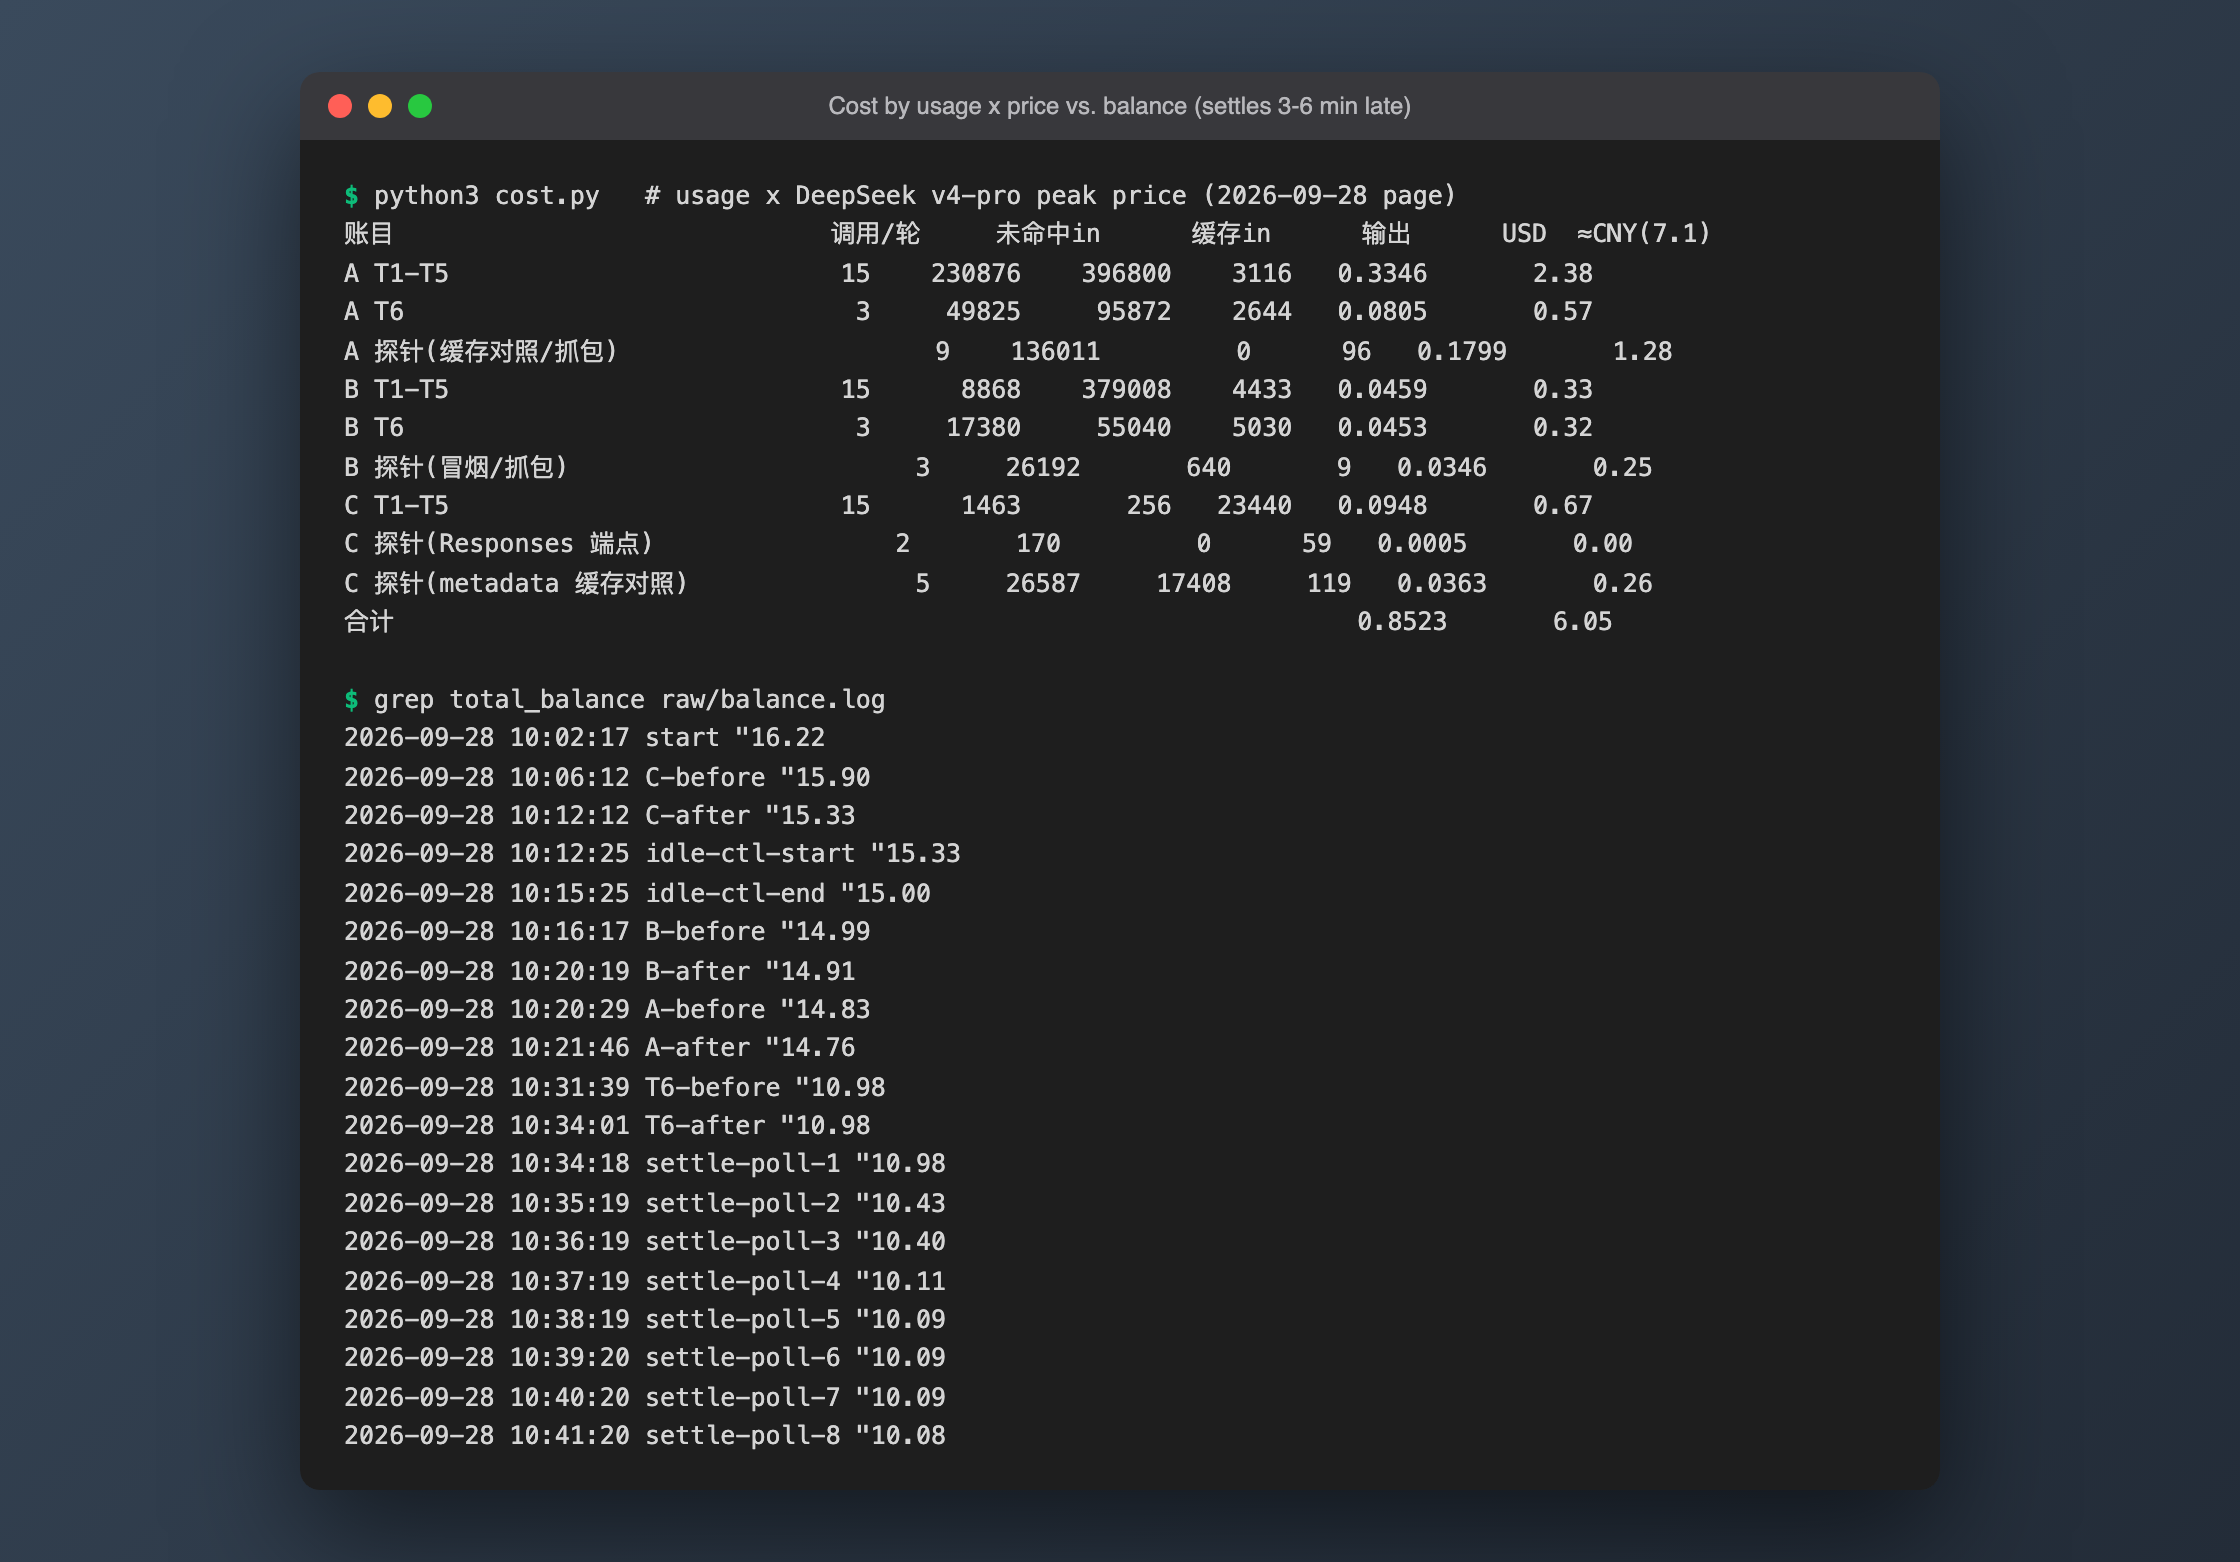
成本按 token 用量 × DeepSeek 官方 v4-pro 峰时价计算(全部调用落在峰时:缓存命中 $0.044 / 1M、未命中 $1.32 / 1M、输出 $3.96 / 1M;汇率按 7.1):
| T1–T5,各 15 轮 | 未命中输入 | 缓存输入 | 输出 | 合计 | 每轮 |
|---|---|---|---|---|---|
| A Claude Code | 230,876 | 396,800 | 3,116 | ¥2.38 | ¥0.159 |
| B Codex CLI | 8,868 | 379,008 | 4,433 | ¥0.33 | ¥0.022 |
| C 裸 API | 1,463 | 256 | 23,440 | ¥0.67 | ¥0.045(什么也没做成) |
两个 harness 的提示词都很重,差别在于有没有按未命中价计费。Codex 每次运行的第一个请求就已命中缓存(T1:18,450 输入里命中 17,920)。Claude Code 的第一个请求每一次都未命中——每次运行约 15.1K token 全价。
我的第一个假设是:Claude Code 把工作目录写进了系统提示词,前缀变了。错了:在同一个目录连跑 3 次,首请求 cache_read 仍然是 0。于是我把两次同目录运行的请求体拿来 diff:model、system、tools、messages、max_tokens、thinking 全部相同,唯一的差异是 metadata.user_id,里面带着每个会话不同的 session_id。
对 DeepSeek 的 Anthropic 端点做 5 次对照调用,同一段 8.8K token 提示词,只改 metadata:
| # | metadata.user_id |
input | cache_read |
|---|---|---|---|
| 1 | sessA(预热) | 8,799 | 0 |
| 2 | sessA | 95 | 8,704 |
| 3 | sessB | 8,799 | 0 |
| 4 | 不带 | 8,799 | 0 |
| 5 | 回到 sessA | 95 | 8,704 |
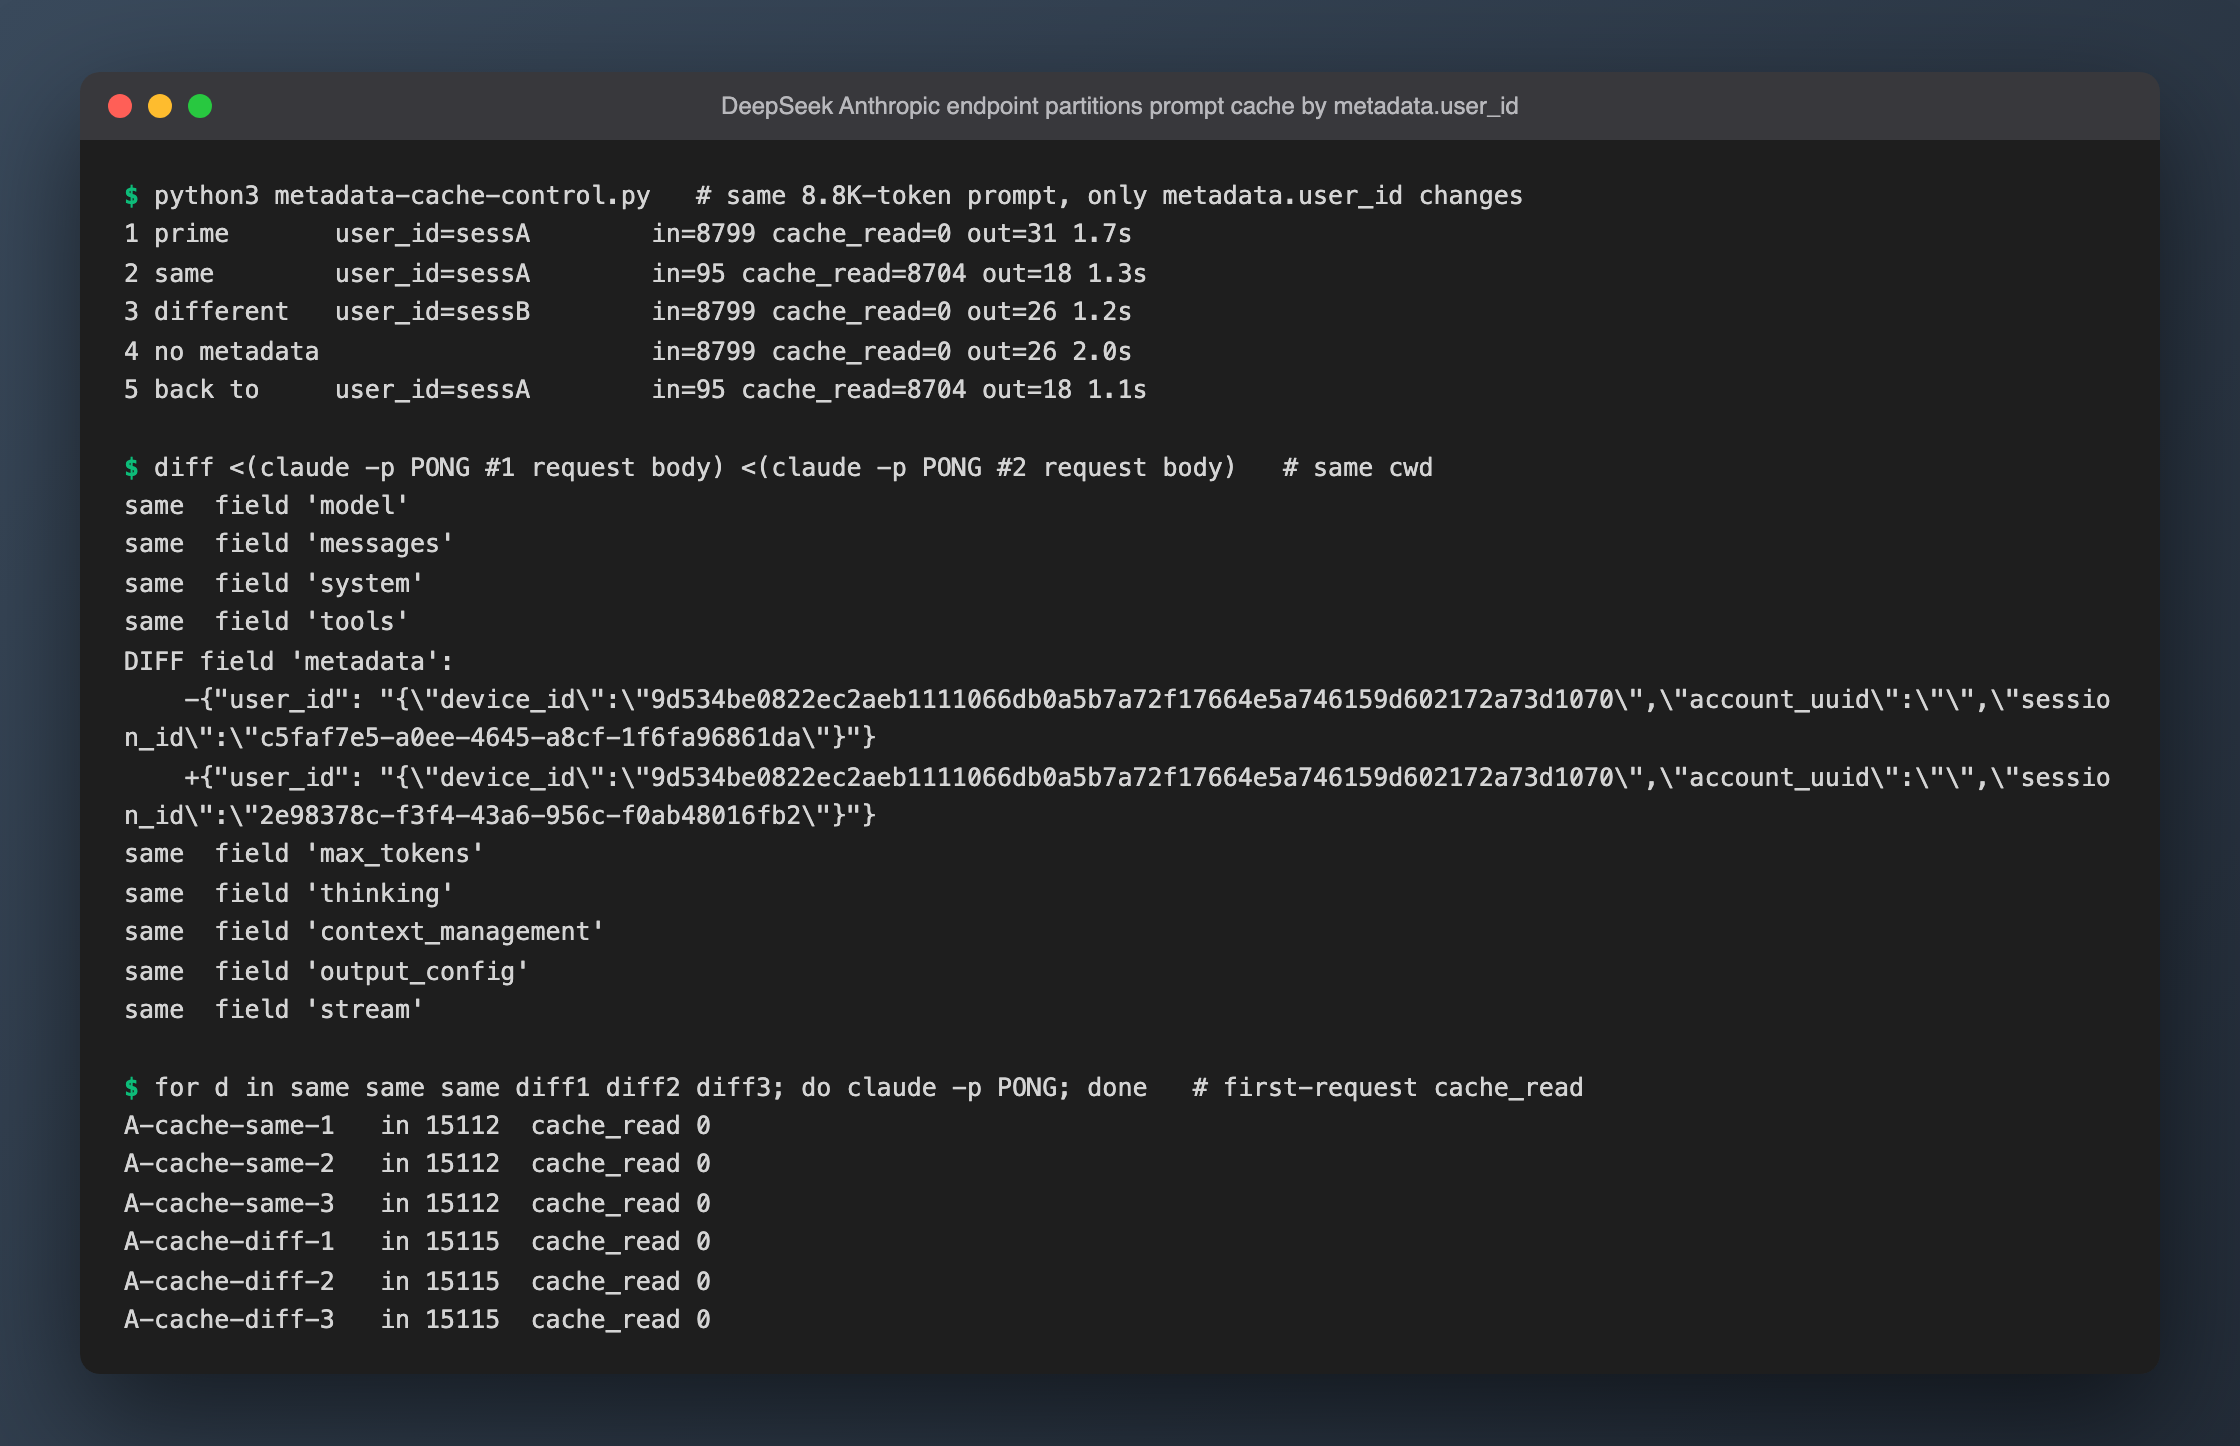
DeepSeek 的 Anthropic 端点按 metadata.user_id 分区提示词缓存。 Claude Code 每个会话在这里放一个新的 session id,所以每次 claude -p 都冷启动、约 15K token 按未命中价计费,只有同一会话里后续的请求才命中。长时间的交互会话里这应该只是每会话一次的开销(按机制推断,未实测);而脚本化、大量短调用的场景——CI、批处理、以及我这次的跑法——它就是账单的大头。Codex 的请求里带了 prompt_cache_key 字段;它跨运行能命中是不是因为这个,我没有单独验证。
(前一篇写到「第二次起稳定命中缓存」,指的是同一会话内,与本条不矛盾。)
4. 失败策略:175 秒 vs 25 秒,以及不重试的 429
代理直接返回错误、不转发(零 API 成本),提示词 Reply with exactly: PONG:
| 注入 | A Claude Code | B Codex CLI |
|---|---|---|
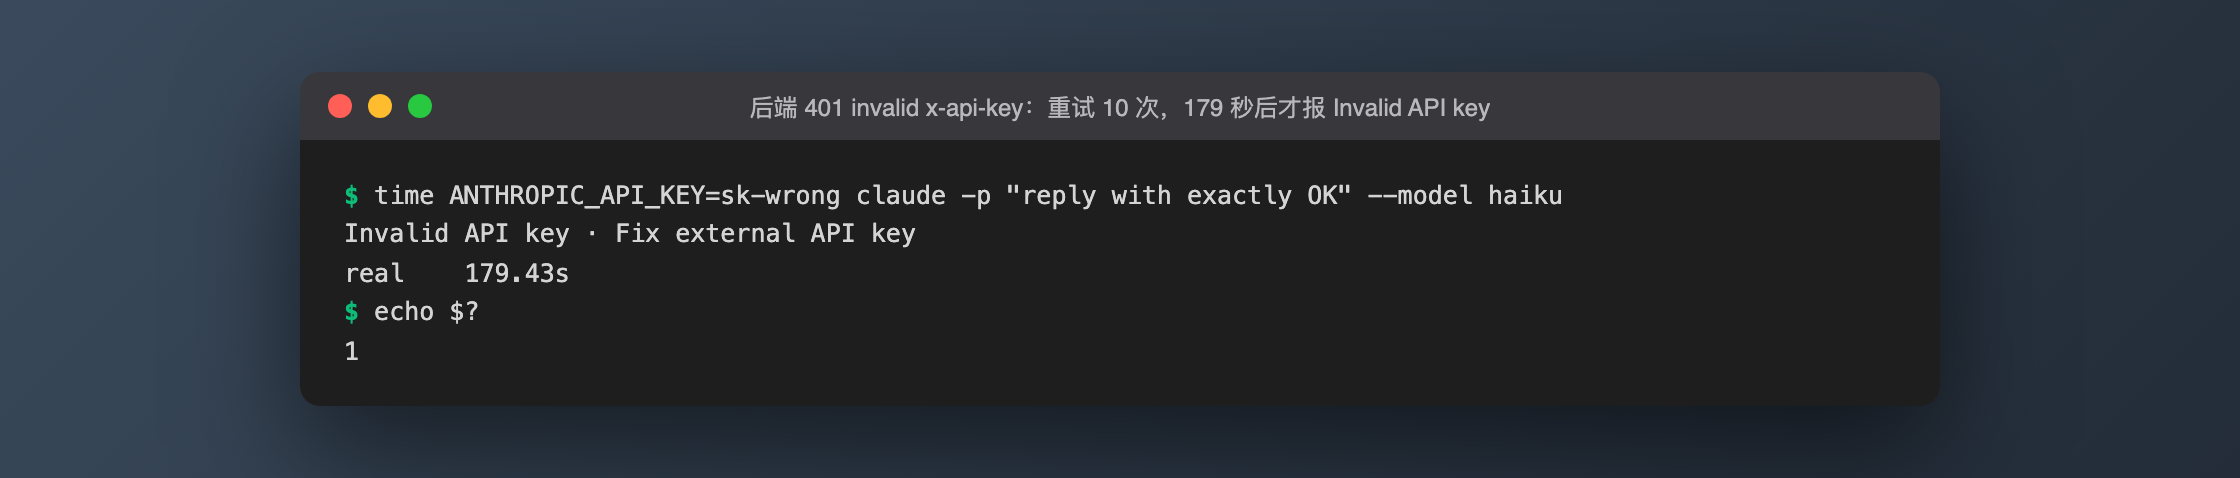
| HTTP 500 | 11 次请求(1 + 重试 10),退避 0.5 → 1 → 2 → 5 → 9 → 17 秒,之后约 32–40 秒;约 175–178 秒后放弃(2 次) | 30 次请求,约 25 秒放弃(3 次),报 We're currently experiencing high demand…——对自己配的 provider 出错来说是误导文案 |
| HTTP 429 | 同样形状:11 次请求,约 180–183 秒放弃(2 次) | 1 次请求、不重试,0.5–0.7 秒失败,报 exceeded retry limit, last status: 429 Too Many Requests(3 次) |
| 挂起(永不响应) | 约 360 秒中止请求并重发(n=1) | 400 秒内没有任何超时,被我手动杀掉(n=1) |
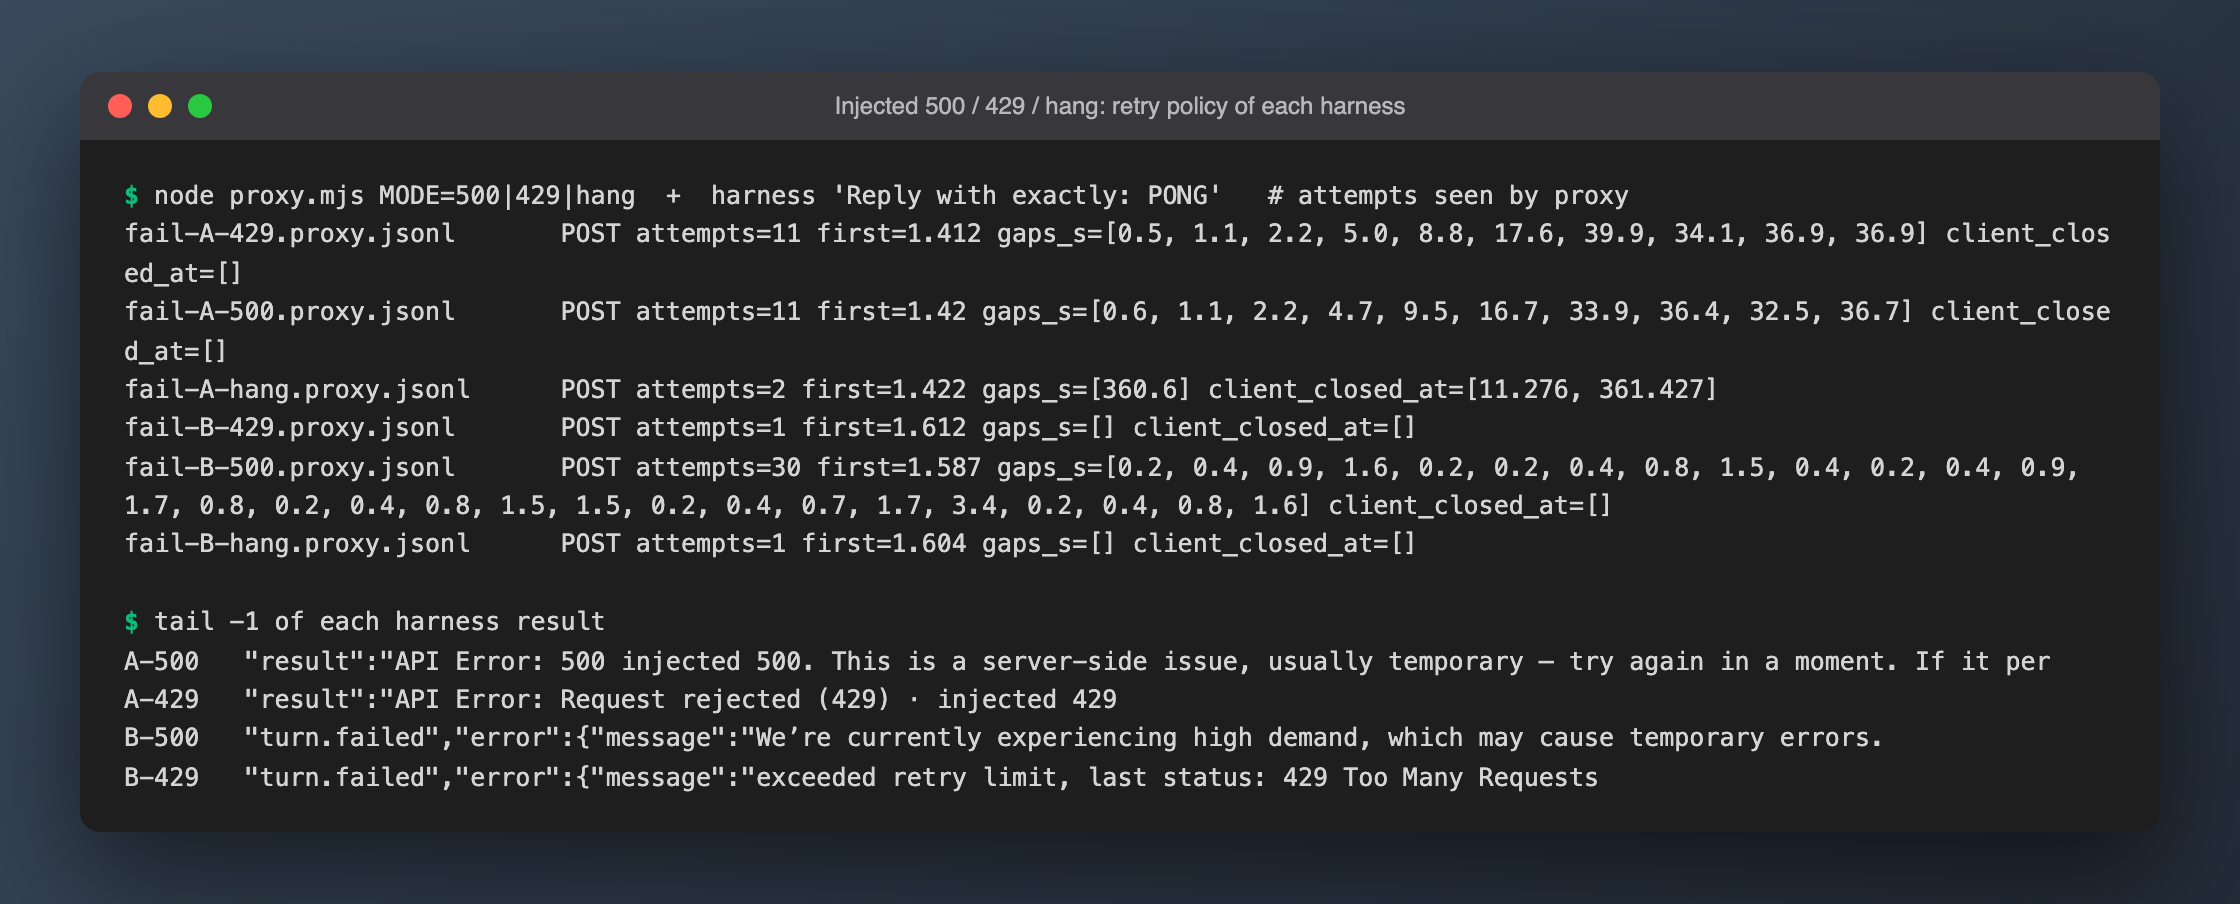
没有谁「对」。Claude Code 能扛过三分钟的故障;Codex 快速失败,把决定权交还给你的脚本。但如果你用 Codex 接 DeepSeek 撞上限流,预期的是立即失败,而不是退避重试。
两处没闭环:我注入的 429 响应没带 Retry-After 头,带了之后 Codex 会不会重试——未验证。挂起组每组只有一次观测(每次要烧 400 秒),这两个数字只作参考。
5. 截断:头部 2KB,还是头 + 尾
sh big.sh 打印 6,000 行、120,000 字符。经代理抓到的、各 harness 实际递给模型的内容:
| A Claude Code | B Codex CLI | |
|---|---|---|
| 回灌给模型 | <persisted-output> 块:「Output too large (117.2KB). Full output saved to: …/tool-results/….txt」+ 2KB 预览(第 1–100 行),共 2,296 字符 |
头 + 尾,10,212 字符 / 508 行,开头附 Warning: truncated output (original token count: 30000) 和 Total output lines: 6000;最后一行可见 |
| 怎么拿到最后一行 | 3/3 轮都再调一次 Bash(tail / wc)读落盘文件 |
一次调用 |
| 结果 | 2/3 | 3/3 |
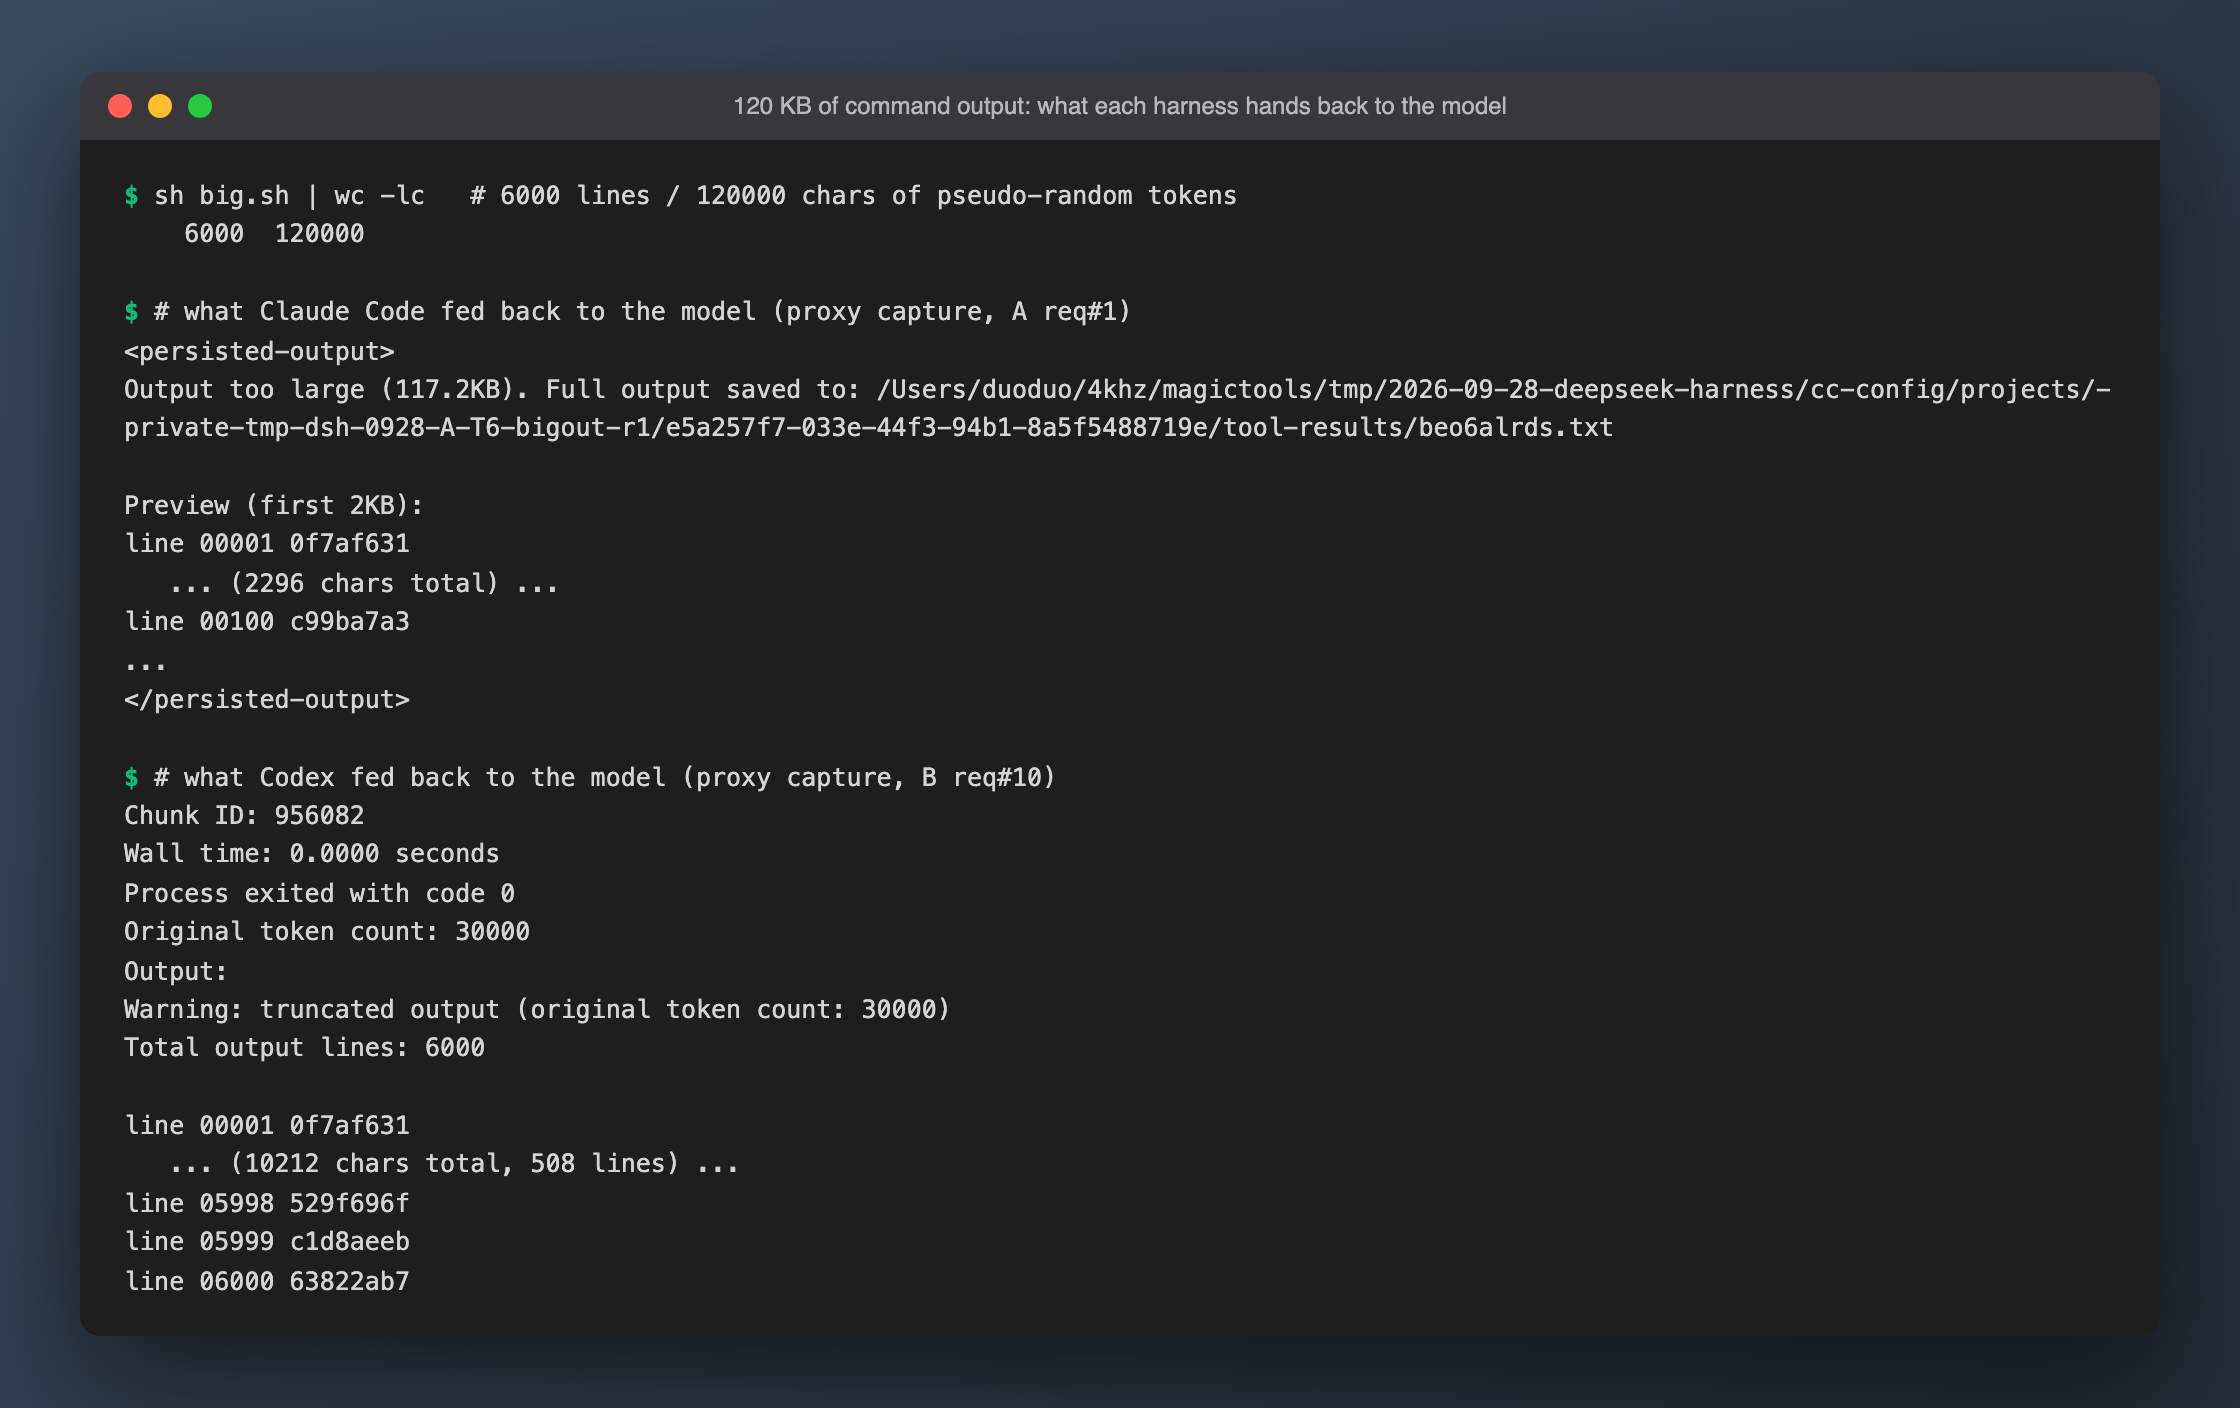
Claude Code 的做法不丢信息——全文在磁盘上,模型知道在哪——代价是多一次往返。Codex 的头 + 尾在「最后一行是什么」这种题上占便宜,换成中间某行就会吃亏。(A 那次「失败」回的是 63822ab7 和 6000——token 对、行数对,只是没复述整行,属于格式不符而不是看不见。)另外 Codex 那边模型有两轮自称看到 500 行、一轮说 6,000 行——harness 头部写着 6,000,实际给它看的是 508 行。
6. 延迟:Claude Code 快约 4 倍,但我说不全为什么
T1–T5 共 15 轮中位数:A 4.17 秒,B 15.52 秒。 已排除的:npx 启动 0.4–0.5 秒,Codex 的 zsh -lc 包装 0.01 秒,单个上游 PONG 两个端点几乎一样快(1.7 秒 vs 1.8 秒)。Codex 在注入 429 时 0.5–0.7 秒就退出,CLI 本身不慢。
剩下的时间花在 Codex 的模型调用和本地工具执行之间,而 Codex 的 JSONL 事件不带时间戳。唯一抓到上游耗时的地方(T6),Codex 第二个 /responses 请求用了 12–55 秒——推理很重——但 T1–T5 那 13–15 秒没有拆分归因。要拆需要再用带时间戳的代理跑一轮,受预算所限没做。
哪些差异来自模型,哪些来自 harness
| 差异 | 模型还是 harness | 证据 |
|---|---|---|
| 文件到底有没有改 | harness | C 组 0/15 且 5 次谎报 vs A/B 15/15 |
| 用什么工具 | harness | 20 个具名工具 vs 一个 shell 工具;提示词提到 apply_patch 却没注册 |
| 每轮成本差 7 倍 | harness × 端点 | 缓存按 metadata.user_id 分区,而不是按提示词 |
| 500 / 429 / 挂起时的行为 | harness | 11 次 vs 30 次;429 重试 vs 不重试 |
| 120KB 输出在模型眼里长什么样 | harness | 2KB 头部 + 落盘文件 vs 头尾 508 行 |
从自己的 sed 错误里恢复 |
模型 | 同一模型,看到 exit 1 后改用 BSD 语法 |
| CSV 求和算对(605) | 模型 | A、B 完全一致 |
只记一条的话:当「DeepSeek」在某个工具里表现差,先查 harness 这一列。
实用结论
- Codex CLI + DeepSeek: 用
wire_api = "responses",所有写chat的教程都作废。预期文件编辑全走 shell(macOS 上留意 GNU / BSDsed差异)、429 快速失败、挂起无超时。 - 脚本里用 Claude Code + DeepSeek: 每次
claude -p都要付约 15K 未命中 token。大量短的 headless 调用时这就是账单的大头——把工作合并进更少的会话。交互使用受影响应该小得多(未实测)。 - 裸 API 自己拼 agent: 永远别信回复,去磁盘上核。我的裸 API 轮次里三分之一说了 DONE,活儿根本没干。
踩坑
- Codex 连
--version都会写~/.codex。 我在 exportCODEX_HOME之前跑了codex --version和codex exec --help,Codex 就在真实家目录下建了~/.codex/tmp/arg0/…(它的apply_patch/codex-execve-wrapper垫片)。第一条 Codex 命令之前就要 exportCODEX_HOME;设好之后再没往那里写过。已建的文件原样保留,等人工确认后处理。 wire_api = "chat"在 0.157.1 已移除,DeepSeek 用responses。codex exec会读 stdin(Reading additional input from stdin...),脚本里要喂</dev/null,否则会等。- fallback metadata 下 Codex 的提示词提到
apply_patch,工具却没注册。 - DeepSeek 的
/user/balance结算滞后 3–6 分钟。 我一度把空闲期的余额下降当成有人在共用 key,其实是自己之前的调用刚入账;跑了 6 轮前后读数 ¥10.98 → ¥10.98 才露馅。所以分组的余额前后差不可用,只能按用量 × 价格记账。用量口径合计 ¥6.05,余额实降 ¥6.13(16.22 → 10.09),相差 1.3%,说明 key 没有别的消费者。 - 我超预算了。 本轮上限 ¥5,实际花了 ¥6.13:没有逐轮累计用量记账,还以为 Claude Code 能跨运行吃到缓存。发现后立即停掉了所有 API 调用。
- 误输入过一次
rm -f /dev/null。 因权限不足失败,/dev/null完好——写出来是因为这份记录应当完整。
相关阅读:Claude Code 接 DeepSeek:一切能用,但成本显示虚高 38 倍 · DeepSeek 标称 1M、Claude Code 只认 200K