Claude Code 报错 Command timed out after 2m 0s 怎么解决:两条超时路径、BASH_DEFAULT_TIMEOUT_MS 与 run_in_background 实测
问题背景
让 Claude Code 跑一个慢命令,比如冷启动的 npm install、整套测试、docker build,或者一段 sleep 轮询,过了两分钟,工具结果变成这样:
Exit code 143
Command timed out after 2m 0s
这是 Claude Code 的 Bash 工具默认超时:120000 ms。常见的处理办法是「把超时调大」,但实际碰到后,至少还有三个问题没回答:
- 命令被杀后,已经输出的内容还在不在?子进程会不会变成孤儿进程?
- 用脚本跑
claude -p时,怎么发现命令其实超时了? BASH_DEFAULT_TIMEOUT_MS、BASH_MAX_TIMEOUT_MS、单条命令的timeout参数、run_in_background,分别该在什么场景用?
这篇的所有报错原文和数字,都来自 2026-09-26 在本机 Claude Code 2.1.280 上跑的 19 次真实 claude -p 会话,逐字照抄。
问题分析
先读了一遍 2.1.280 的二进制(claude.exe,217,254,576 字节),相关代码有这几段:
- 默认值和上限:
var p=120000,d=600000。BASH_DEFAULT_TIMEOUT_MS只有在!isNaN(o)&&o>0时才生效,否则回落 120000。BASH_MAX_TIMEOUT_MS取Math.max(max, default),所以上限永远不会小于默认值。 - 报错模板:
Command timed out after ${zt(this.#u)}。 - 单条命令的 timeout 取
Math.min(请求值||默认值, 上限, …)。被夹小时只发一个timeout_clamped遥测事件,模型看不到。 - 超时自动转后台:满足
!or&&Ee===void 0&&kYr(Be)时,超时的命令不杀,改为转到后台。kYr会取命令的首词,只要不在gYr=["sleep"]里就放行。or为真的情况包括设置了CLAUDE_CODE_DISABLE_BACKGROUND_TASKS。
最后一条是这次最意外的发现。2.1.280 里 Bash 超时有两条完全不同的路径:
| 路径 | 触发条件 | 工具结果 | is_error |
|---|---|---|---|
| 被杀 | 首词是 sleep,或设了 CLAUDE_CODE_DISABLE_BACKGROUND_TASKS=1 |
Exit code 143\nCommand timed out after 2m 0s |
true |
| 转后台 | 其它命令,例如 echo …; sleep 300、(sleep 301; echo X) | cat |
Command did not complete within its 120s timeout and was moved to the background (ID: …) |
false |
也就是说,在 2.1.280 里真正会看到「Command timed out after 2m 0s」的,只有第一种情况。标题里这条报错,下面的实验主要用 sleep 300 来稳定复现。
技术方案与选型
默认两分钟不够用时,有三种绕法,它们的代价不一样:
| 绕法 | 代价 | 适用场景 |
|---|---|---|
环境变量 BASH_DEFAULT_TIMEOUT_MS(配合 BASH_MAX_TIMEOUT_MS) |
对所有命令生效,真卡死的命令也要等满新阈值;0 或非数字会静默回落 120 秒;上限默认 600000 ms,想超过 10 分钟必须同时抬高 MAX |
整个会话都在跑长构建,或 CI 类无头任务 |
单条命令传 timeout 参数(上限是 BASH_MAX_TIMEOUT_MS,默认 600000) |
要靠模型主动传参;超过上限会被静默夹取 | 已知个别命令慢,例如一次长测试 |
run_in_background |
立即返回,但完成通知不带输出,要再读文件;-p 模式下最终回复 5 秒后就会被 kill;实测模型还可能编造完成通知 |
交互式长任务;在 -p 下必须让模型前台轮询到完成 |
排除项:
- 不推荐在命令外面再套一层
timeout 600 …。外层的 GNUtimeout只能让命令提前结束,没法延长 Claude Code 自己的 120 秒计时器(这是按代码逻辑推断的,本轮未实测)。 - 不推荐靠
nohup … &把进程甩出去。本轮sleep 305 & wait的实验里,&起的子进程和外层 shell 同属一个进程组,超时时被一起杀掉(见下文 B2c)。就算甩出去了,模型也拿不到结果。 - 本轮不讨论
CLAUDE_CODE_AUTO_BACKGROUND_TIMEOUT_MS。二进制里有这个变量(会把可转后台命令的超时缩短),但本轮没实测,不给建议。
实测过程
所有会话都用同一种形式调用,每个 run 用独立的 work/ 目录和隔离的 config 目录:
cd <run>/work
CLAUDE_CONFIG_DIR=<lab>/claude-config claude -p '<prompt>' \
  --allowedTools Bash --model haiku --setting-sources user \
  --debug-file <run>/debug.log --output-format text < /dev/null
逐字的工具结果都取自每个会话的 transcript.jsonl。「工具耗时」是 transcript 里 tool_use 到 tool_result 的时间戳差。
A. 默认超时:报错原文、退出码和计时
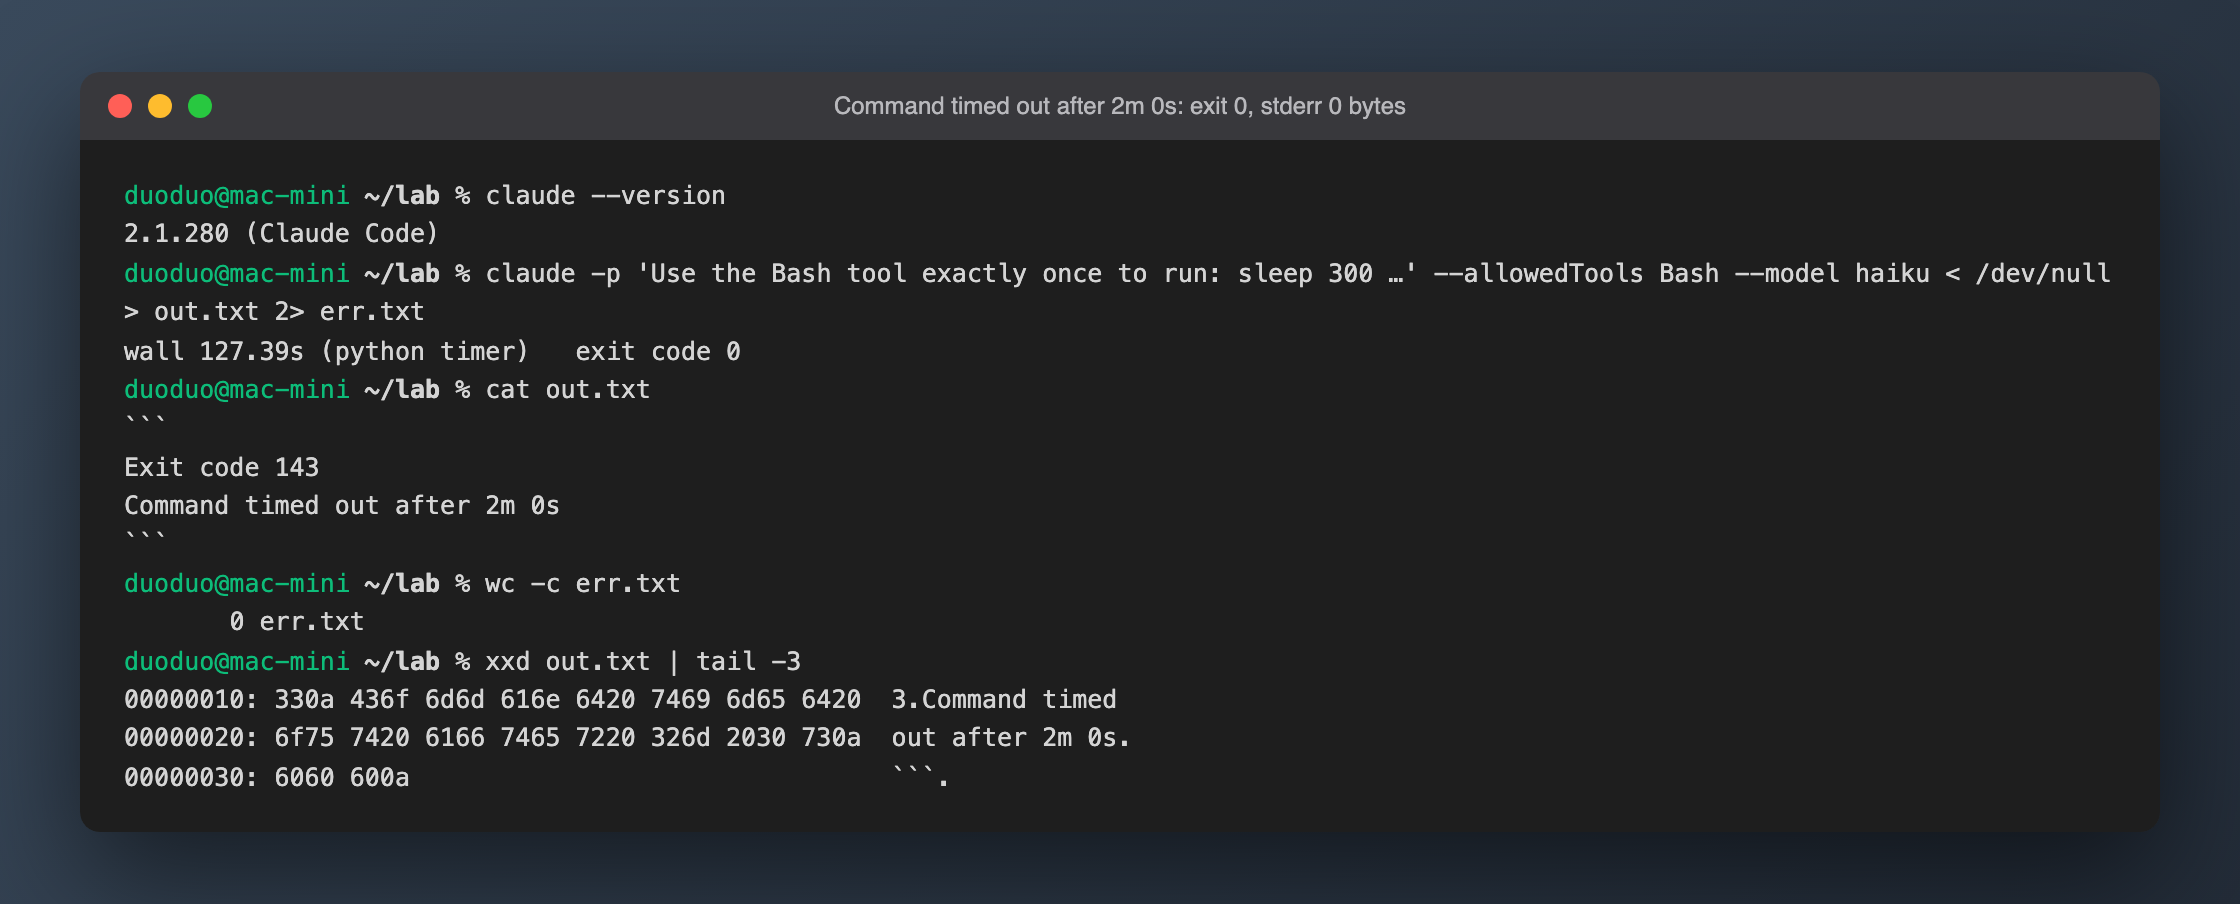
A1(text 输出)的读数:
| 项 | 读数 |
|---|---|
| 墙钟 | 127.39 s |
| 工具耗时 | 120.177 s |
claude 退出码 |
0 |
| stderr | 0 字节 |
| 工具结果(transcript) | Exit code 143\nCommand timed out after 2m 0s,is_error=true |
Exit code 143= 128 + 15,也就是被 SIGTERM 杀死。- 工具结果在
2m 0s后面没有换行。stdout 里那个代码块是模型自己排版的转述,不是 CLI 打出来的。 - 在
claude -p里,这条报错既不在 stdout 也不在 stderr,它是对话内部的 tool_result。stdout 上能不能看到它,完全看模型最后怎么转述。
A2 用 --output-format json 跑同一个 prompt:
| 字段 | 值 |
|---|---|
顶层 is_error / subtype |
false / success |
num_turns |
2 |
duration_ms |
126196 |
duration_api_ms |
6021 |
total_cost_usd |
0.0115758 |
JSON 顶层也看不出命令超时了。duration_ms 包含了 120 秒的工具等待,duration_api_ms 不包含,所以脚本里可以用两者之差来判断时间是不是耗在了 Bash 上。这一点和 MCP 连接超时那篇正好相反:那边的等待发生在第一次 API 请求之前,duration_ms 没算进去。
稳定性:同样跑 sleep 300(B2c 为 sleep 305 & wait)、默认 env 的 6 个 run 都得到同一段工具结果,工具耗时全部落在 120.149–120.189 s,墙钟 125.48–127.39 s,差额是模型两轮推理的时间。另外 A3-r3 的模型把工具结果连同外层的 <error>…</error> 和一段 <system-reminder> 一起抄进了 stdout,由此能看出,模型收到的超时结果外面包着 <error> 标签。
B. 部分输出与进程残留
**B1:echo PARTIAL_OUTPUT_START; sleep 300(默认 env)。**这里没有出现「Command timed out」,因为首词是 echo,走的是转后台路径:
Command did not complete within its 120s timeout and was moved to the background (ID: b1lixbsks). Output is being written to: /private/tmp/claude-501/…/tasks/b1lixbsks.output. You will be notified when it completes. To check interim output, use Read on that file path.
is_error=false,toolUseResult 里 stdout 为 "",同时带有 "timedOutAfterMs": 120000。已经打印的 PARTIAL_OUTPUT_START 没有进工具结果,只写进了后台输出文件。会话结束时这个文件的内容是 PARTIAL_OUTPUT_START\n\n[killed]\n(31 字节)。
**B1b:同一条命令,加上 CLAUDE_CODE_DISABLE_BACKGROUND_TASKS=1 和 BASH_DEFAULT_TIMEOUT_MS=10000,强制走被杀路径。**工具结果:
Exit code 143
Command timed out after 10s
PARTIAL_OUTPUT_START
被杀路径会保留已有的 stdout,追加在报错两行后面。(这次同时改了两个变量;默认 120 秒下的这种组合没有单独跑,未验证。)
**B2:子进程会不会残留。**每条命令都会被包成 /bin/zsh -c source …/shell-snapshots/snapshot-zsh-….sh … && eval '<cmd>' < /dev/null && pwd -P >| /tmp/claude-XXXX-cwd 执行,这个 zsh 是进程组组长。
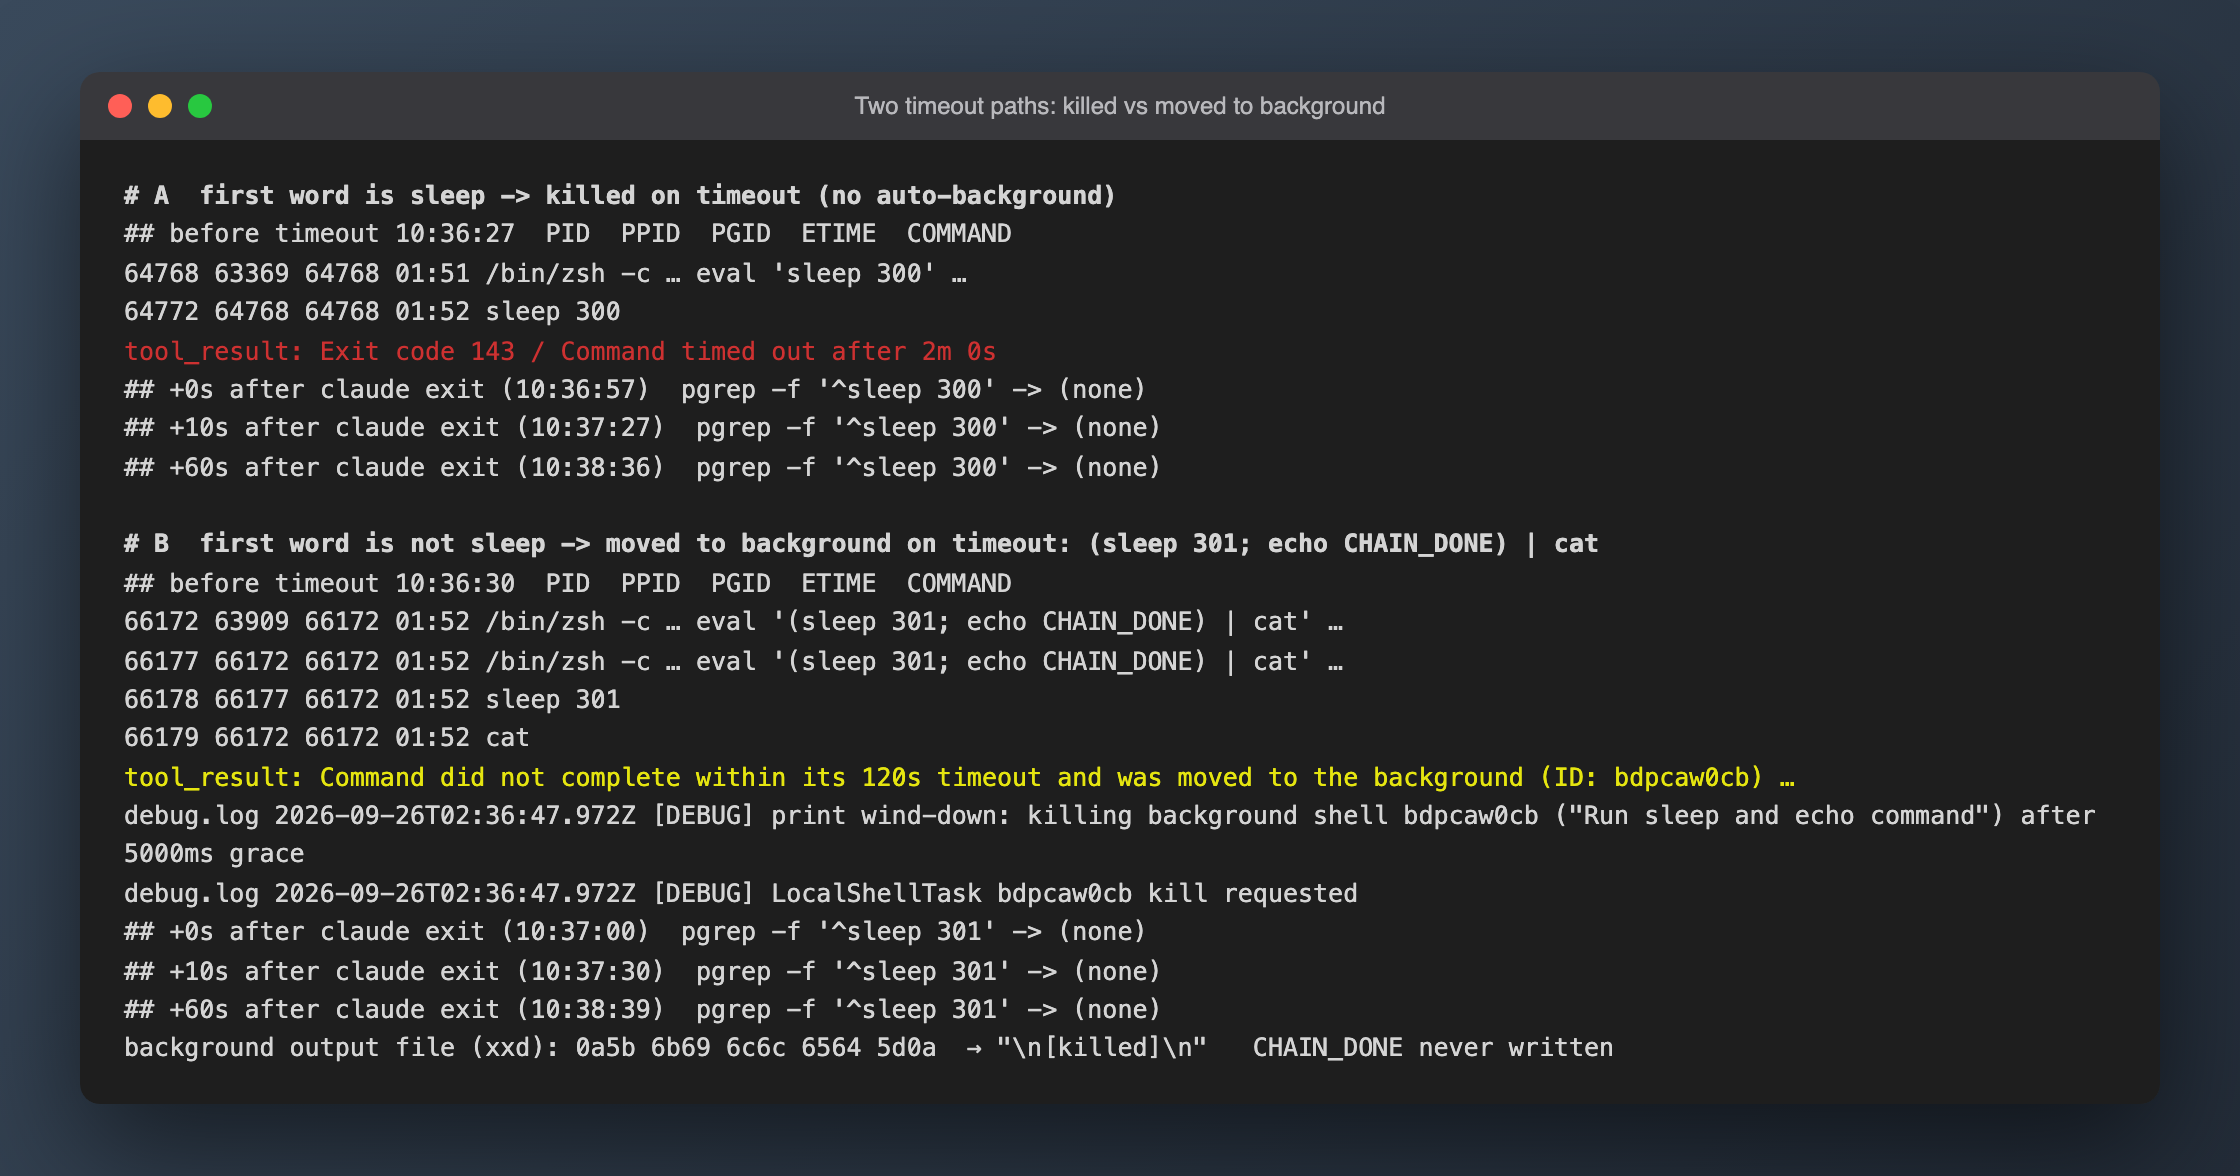
| run | 命令 | 路径 | 运行中进程 | claude 退出后 +0 / +10 / +60 s |
|---|---|---|---|---|
| B2-r2 | sleep 300 |
被杀 | zsh(64768) → sleep(64772),同一 PGID | 无 / 无 / 无 |
| B2c | sleep 305 & wait |
被杀 | zsh(65537) → sleep(65543),同一 PGID | 无 / 无 / 无 |
| B2d | (sleep 301; echo CHAIN_DONE) | cat |
转后台 | 4 个进程同一 PGID 66172 | 无 / 无 / 无 |
- 被杀路径下,用
&起的子进程也一起消失了,可以认为杀的是整个进程组。 - 转后台路径下,命令超时后还在跑,直到
claude -p收尾才被杀。debug.log 里是print wind-down: killing background shell bdpcaw0cb ("Run sleep and echo command") after 5000ms grace,时间正好在模型最终回复后 5 秒。CHAIN_DONE一直没有写出来。 - 19 个有效 run 的
work/目录都没有残留文件。/tmp/claude-XXXX-cwd抽查 3 个都不存在,因为被杀路径根本走不到&& pwd -P。唯一留下的是/private/tmp/claude-501/<项目>/…/tasks/*.output,共有 5 个 run 留下了这种文件。
C. 环境变量覆盖
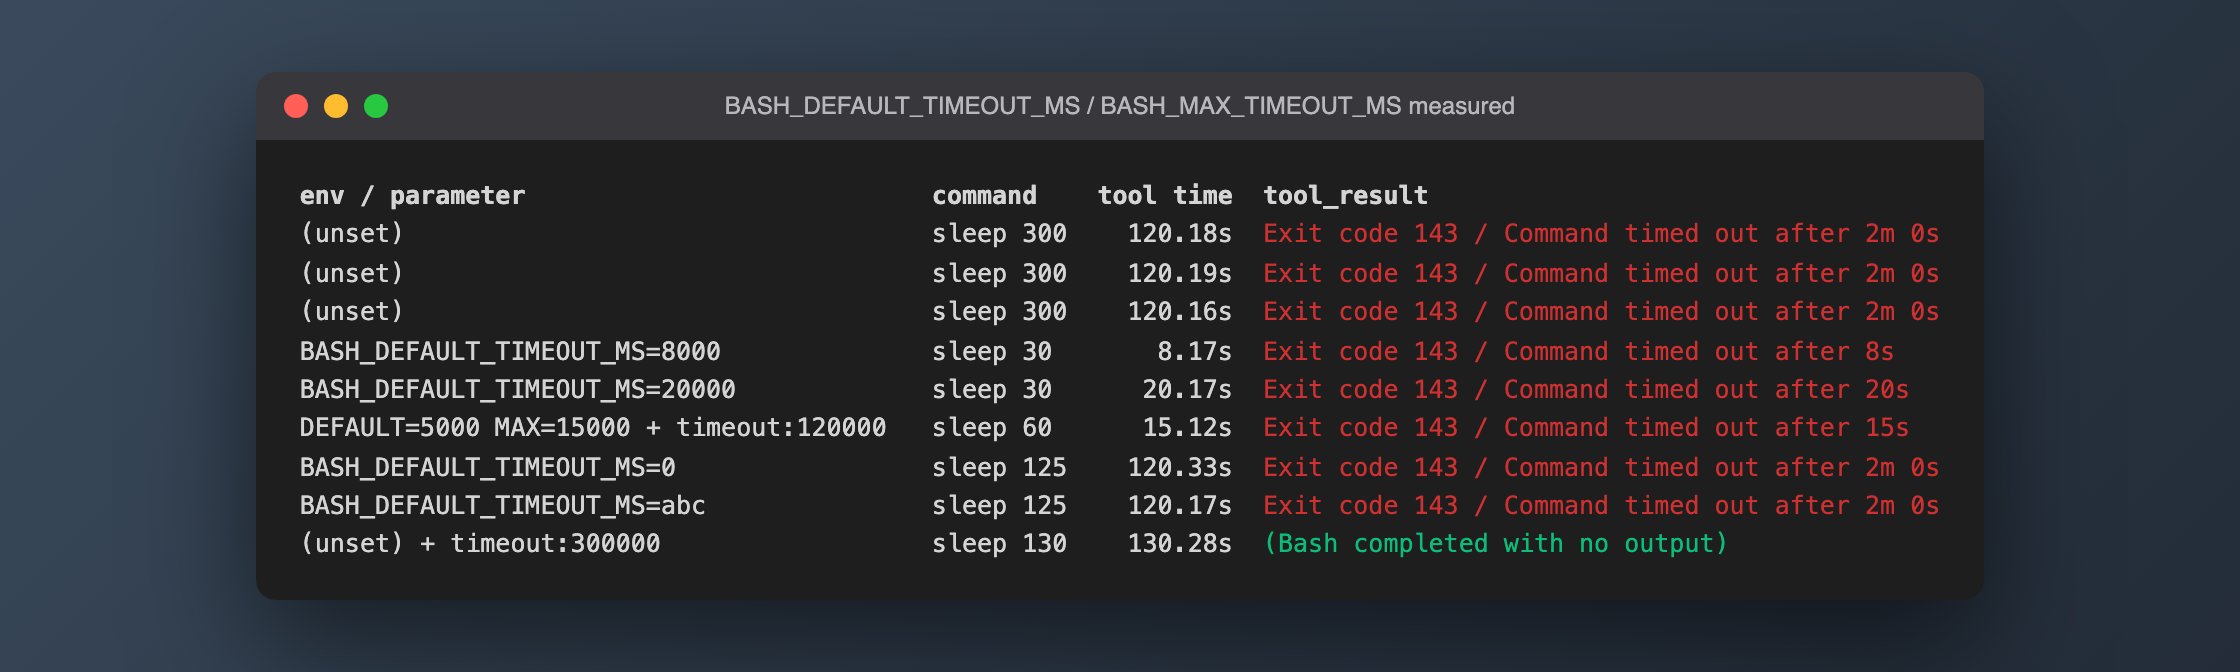
| 设置 | 命令 | 工具耗时 | 工具结果 |
|---|---|---|---|
BASH_DEFAULT_TIMEOUT_MS=8000 |
sleep 30 |
8.166 s | Command timed out after 8s |
BASH_DEFAULT_TIMEOUT_MS=20000 |
sleep 30 |
20.167 s | Command timed out after 20s |
DEFAULT=5000 MAX=15000,模型传 "timeout": 120000 |
sleep 60 |
15.119 s | Command timed out after 15s |
BASH_DEFAULT_TIMEOUT_MS=0 |
sleep 125 |
120.334 s | Command timed out after 2m 0s |
BASH_DEFAULT_TIMEOUT_MS=abc |
sleep 125 |
120.167 s | Command timed out after 2m 0s |
(每行工具结果前面都还有一行 Exit code 143。)
- 时长的写法是
8s、15s、2m 0s,不是毫秒数。 - C2 里模型确实传了
{"command": "sleep 60", "timeout": 120000},结果在 15 秒被杀,工具结果里没有任何「被夹取」的提示。 0和abc都静默回落到 120 秒,不报错也不给警告。- 默认值大于上限时,上限会被抬到默认值:这一点只从代码
Math.max(max, default)读出,未实测。
D. 自救路径
**D2:单条命令显式传 timeout。**模型传参 {"command": "sleep 130", "timeout": 300000},工具耗时 130.285 s,结果 (Bash completed with no output),没有在 120 秒被掐断,墙钟 135.34 s。
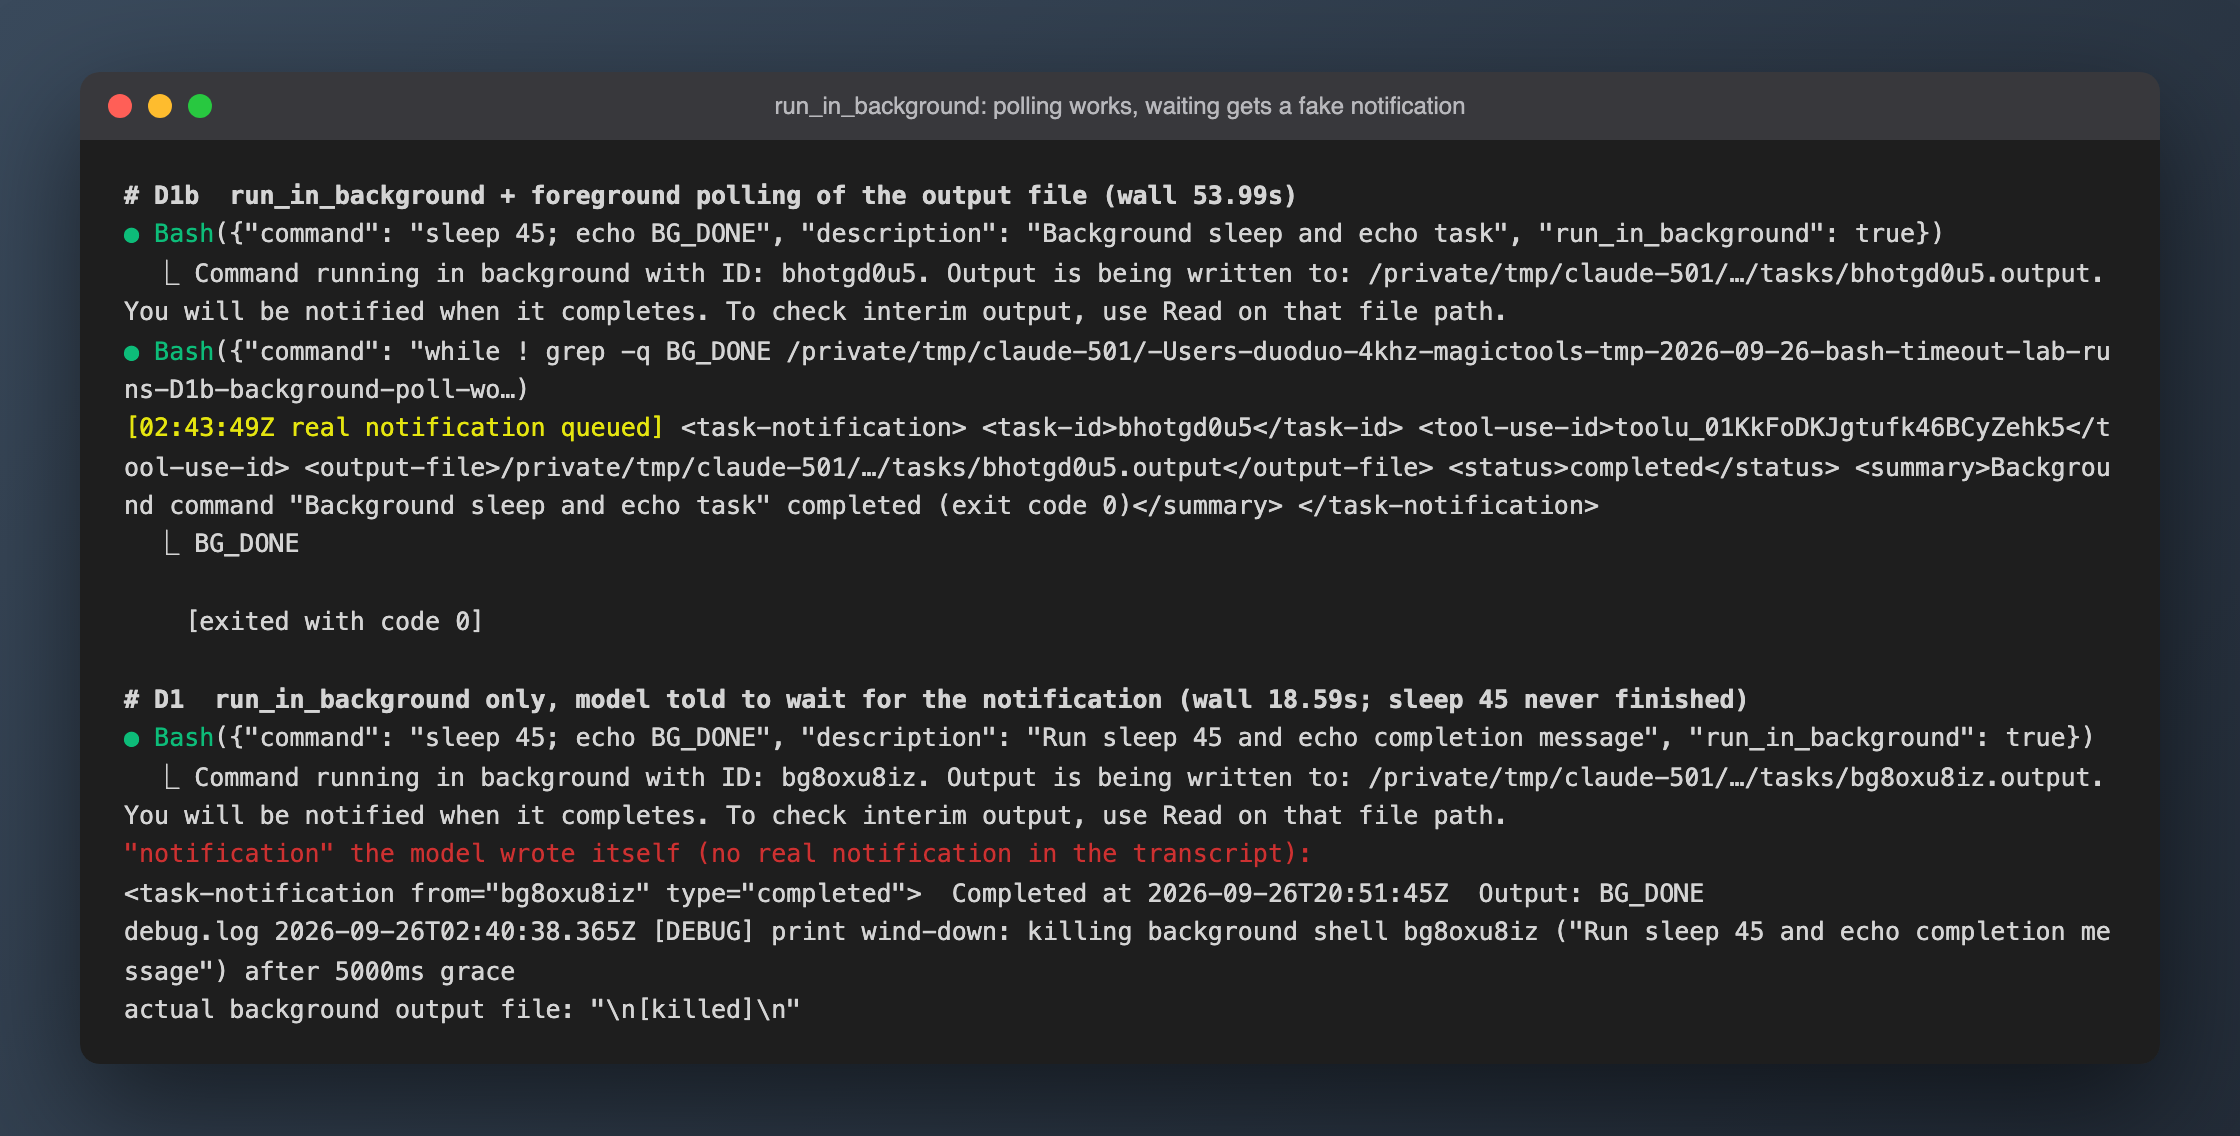
**D1:只用 run_in_background,prompt 让模型「等通知」。**工具 0.118 s 就返回了,整个会话墙钟只有 18.59 s,sleep 45 根本没跑完。debug.log 显示最终回复 5 秒后后台 shell 被 kill,输出文件内容是 \n[killed]\n。
更麻烦的是,haiku 在最终回复里自己编了一段完成通知:
<task-notification from="bg8oxu8iz" type="completed">
Completed at 2026-09-26T20:51:45Z
它还声称输出是 BG_DONE。transcript 里没有任何真实通知入队,时间戳也是编的。
**D1b:后台启动之后,前台轮询输出文件。**第二次 Bash 调用 while ! grep -q BG_DONE <file>; do sleep 5; done; cat <file>,拿到 BG_DONE\n\n[exited with code 0],墙钟 53.99 s,num_turns 3,cost $0.01930。真实通知的格式如下:
<task-notification>
<task-id>bhotgd0u5</task-id>
<tool-use-id>toolu_01KkFoDKJgtufk46BCyZehk5</tool-use-id>
<output-file>/private/tmp/claude-501/…/tasks/bhotgd0u5.output</output-file>
<status>completed</status>
<summary>Background command "Background sleep and echo task" completed (exit code 0)</summary>
</task-notification>
真实通知不带输出内容,只有状态、退出码和文件路径。
实践效果
把上面的读数整理成可以直接照做的结论:
**1. 在脚本里跑 claude -p 时,别指望退出码。**超时时 claude 照样 exit 0、stderr 为空,JSON 顶层是 is_error=false / success。可行的检测方法:
claude -p "$PROMPT" --output-format json < /dev/null > out.json
jq '.duration_ms - .duration_api_ms' out.json
A2 实测差值是 126196 − 6021 = 120175,也就是一次卡满 120 秒的超时。要精确判断,可以解析 transcript 里 is_error=true 的 tool_result,或者找带 timedOutAfterMs 字段的记录(转后台路径)。
**2. 已知整场都慢,就在启动时抬默认值。**本轮所有 env 都是在命令行前缀里传的:
BASH_DEFAULT_TIMEOUT_MS=600000 BASH_MAX_TIMEOUT_MS=1200000 claude
注意值必须是正整数,写 0 或 10m 都会静默回落 120 秒。想超过 600000,要同时抬高 BASH_MAX_TIMEOUT_MS。
**3. 只有个别命令慢,就让模型传 timeout。**实测 timeout: 300000 跑完了 130 秒的命令。超过上限不会报错,只会被悄悄夹小,所以设了上限之后请求值要在上限以内。
**4. -p 模式里用 run_in_background,必须前台轮询到完成。**只「等通知」的话,会话在最终回复 5 秒后就会收尾并 kill 后台任务,模型还可能编一个完成结果。
**5. 看到 moved to the background 而不是 timed out,是正常的。**这是 2.1.280 对首词不是 sleep 的命令的默认行为,命令并没有失败,只是没跑完。在 -p 下它同样会在收尾时被 kill。
本轮 19 个有效会话的 API 花费合计 $0.4152。
踩坑
- **本机
grep是 ugrep 的别名。**静态复核时用带.{0,N}的正则搜 217 MB 的二进制,直接报exceeds complexity limits。换成/usr/bin/grep后,前导.{0,255}又跑了超过 600 秒,连我自己驱动实验的那个 Bash 命令也因此被自动转后台,算是先亲身体验了一次本文要测的东西。最后改用 python mmap 按偏移切片。 - **API 网关 503。**第一批 6 个 run 并发跑,全部撞上
503 No available accounts,11 次重试耗尽,cost 为 0。这些 run 移到_invalid_503/作废,之后把并发降到 2–3 重跑。B2 首跑的「运行中进程快照」因为 503 延迟没采到。 - **仓库 hook 误捕获。**我查看读数的命令输出里有
Exit code 143/timed out,仓库的 PostToolUse hook 把它们当成失败命令,往tasks/lessons-inbox.md追加了 10 行(18→28)。确认只是尾部追加后,截回了前 18 行。在写「超时」主题的仓库里跑实验,要记得这件事。 - 模型编造后台完成通知(D1),只在 haiku 上见过 1 次,其它模型和重复率未测。结论照样成立:别信回复里的「完成通知」,去读输出文件。
- **进程轮询精度有限。**用 lsof 按 cwd 归属进程很慢,实际轮询间隔 8–25 秒,所以「超时那一刻进程就消失了」只能精确到「claude 退出时已经不在了」。
未验证清单:zt() 格式化函数的源码没有定位到(格式只按实测);CLAUDE_CODE_AUTO_BACKGROUND_TIMEOUT_MS 和 sleep≥25 检测只读了代码;默认 120 秒下「非 sleep 首词 + 关后台」的被杀路径;交互式(非 -p)会话里转后台之后的行为;DEFAULT 大于 MAX 时上限被抬高。