DeepSeek 标称 1M、Claude Code 只认 200K:两个都测了,真正卡住你的是第三个数
DeepSeek 价格页给 deepseek-flash 和 deepseek-v4-pro 都标了 1M 上下文。把 Claude Code 接到 DeepSeek 的 Anthropic 兼容端点上(三个环境变量,接法和它的计费坑我另写了一篇),Claude Code 对同一个模型报告的是:
"contextWindow": 200000
两个数字差 5 倍,描述同一个模型。谁说了算?
我测了。答案是两个都不算,而且失效的方式比这两个数字本身更有意思。
测了哪三层
三个经常被混为一谈的问题:
- 端点收不收?——API 的硬上限。
- 模型用不用得上?——能检索到,不只是没报错。
- Claude Code 让不让你到那儿?——没人写过的客户端闸门。
全部条件:Claude Code 2.1.270、deepseek-flash、macOS、独立 CLAUDE_CONFIG_DIR。大海捞针的针放在第 0 位(海量上下文里最难捞的位置),问题放在最末尾。每个请求带唯一 nonce 破缓存——这个实验的第一版没加,结果两个体量差一倍的负载报出了几乎相同的 token 数。
第一层:DeepSeek 的真实上限是 2^20,不是「一百万」
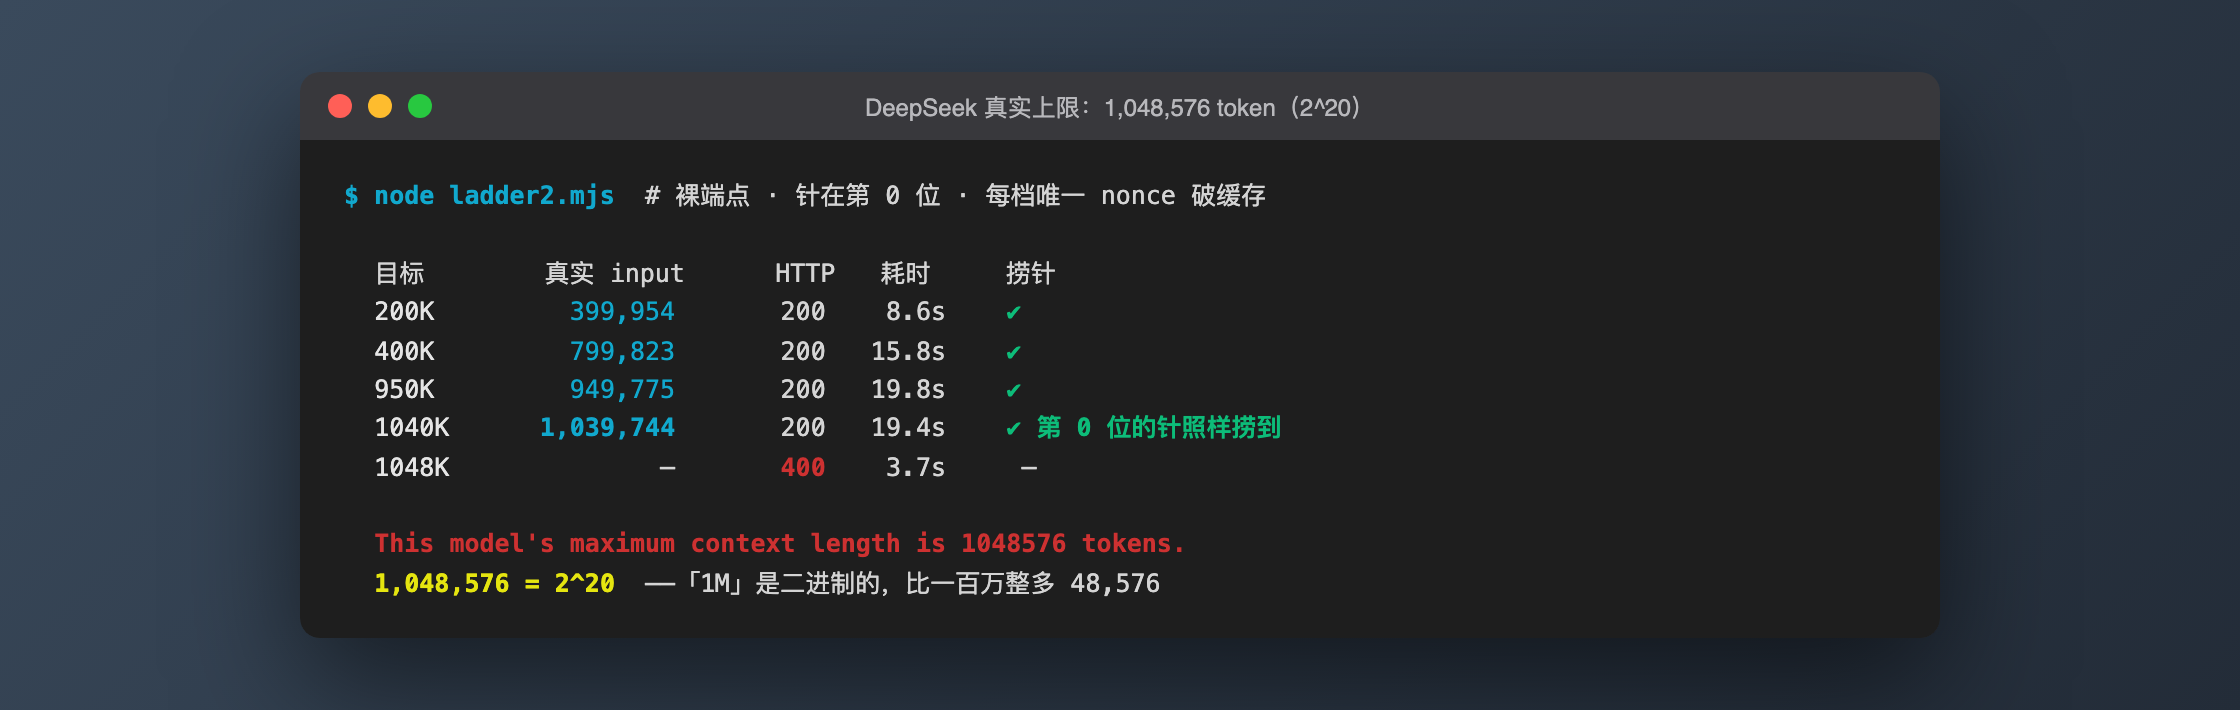
裸端点阶梯,针在第 0 位:
| 目标 | 真实 input token | HTTP | 耗时 | 捞到针 |
|---|---|---|---|---|
| 200K | 399,954 | 200 | 8.6s | ✅ |
| 400K | 799,823 | 200 | 15.8s | ✅ |
| 950K | 949,775 | 200 | 19.8s | ✅ |
| 1040K | 1,039,744 | 200 | 19.4s | ✅ |
| 1048K | — | 400 | 3.7s | — |
1,039,744 token 时,模型仍能把开头第一行的字符串准确取出,用时不到 20 秒。这个长上下文是真的,不是参数表上的数字。
被拒那次直接给出了上限:
This model's maximum context length is 1048576 tokens.
1,048,576 = 2^20。 所以这个「1M」是二进制的,比字面一百万多出 48,576 个 token。
这个额度包含你的输出预算
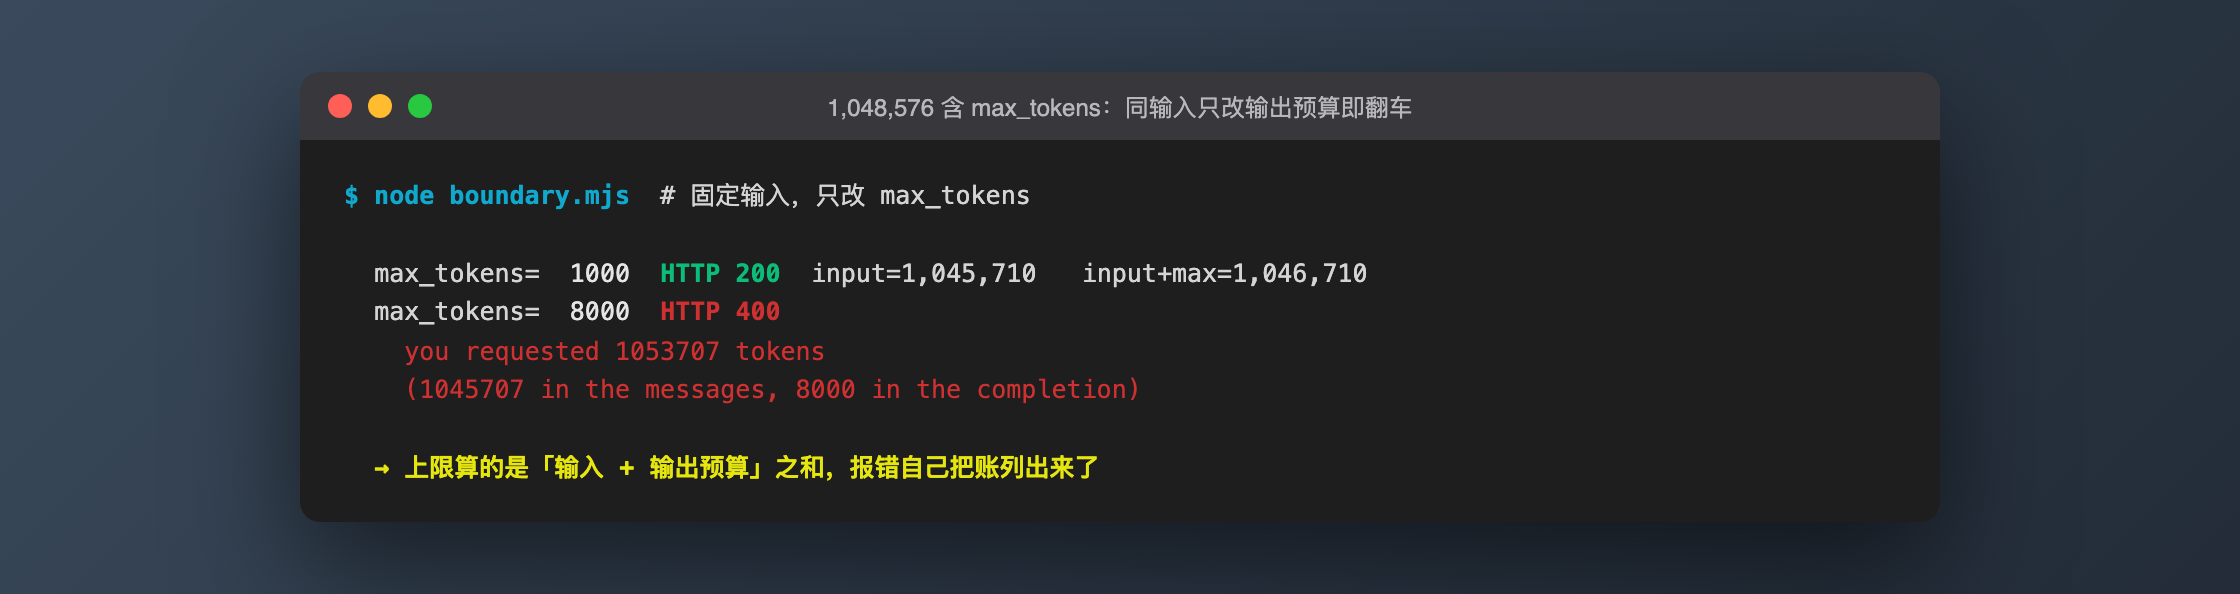
下单之前得知道。固定输入,只改 max_tokens:
| 输入 token | max_tokens |
结果 |
|---|---|---|
| 1,045,710 | 1,000 | ✅ 200 |
| 1,045,707 | 8,000 | ❌ 400 |
报错自己把账算给你看了:
you requested 1053707 tokens (1045707 in the messages, 8000 in the completion)
所以预算是 输入 + 输出 ≤ 1,048,576。在接近满窗时给一个慷慨的 max_tokens,会让本来没问题的输入被拒。
第二层:Claude Code 在本地就拒了,根本不发请求
把超长 prompt 管道喂给 claude -p:
result: "Prompt is too long"
is_error: true
duration_ms: 34
input_tokens: 0
34 毫秒、零 token。 Claude Code 在本地拒的,DeepSeek 压根没见到这个请求,你也没被扣费。
到这儿还算合理——它声明了 20 万窗口,它在执行一个窗口。问题是这个数也对不上。
二分查找,重复英文语料:
| 目标用户 token | 结果 | 真实总 input |
|---|---|---|
| 30K | ✅ 通过 | 64,040 |
| 80K | ✅ 通过 | 114,024 |
| 85K | ✅ 通过 | 119,022 |
| 90K | ❌ 拒绝 | 0(24ms) |
| 95K / 105K / 112K / 120K / 140K / 150K / 180K / 195K / 205K | ❌ 拒绝 | 0 |
闸门在约 11.9 万总 token 处落下——只有它自称的 20 万的六成左右。(其中约 34K 是 Claude Code 自己的系统提示词和工具定义,每轮都要付。)
第三层:这道闸门量的根本不是 token
这才是关键。Claude Code 不可能知道 DeepSeek 的分词器,所以它只能估算。如果用的是常见的「字符 ÷ 4」启发式,那闸门就应该固定在字符数上,而真实 token 数会随内容性质任意漂移。
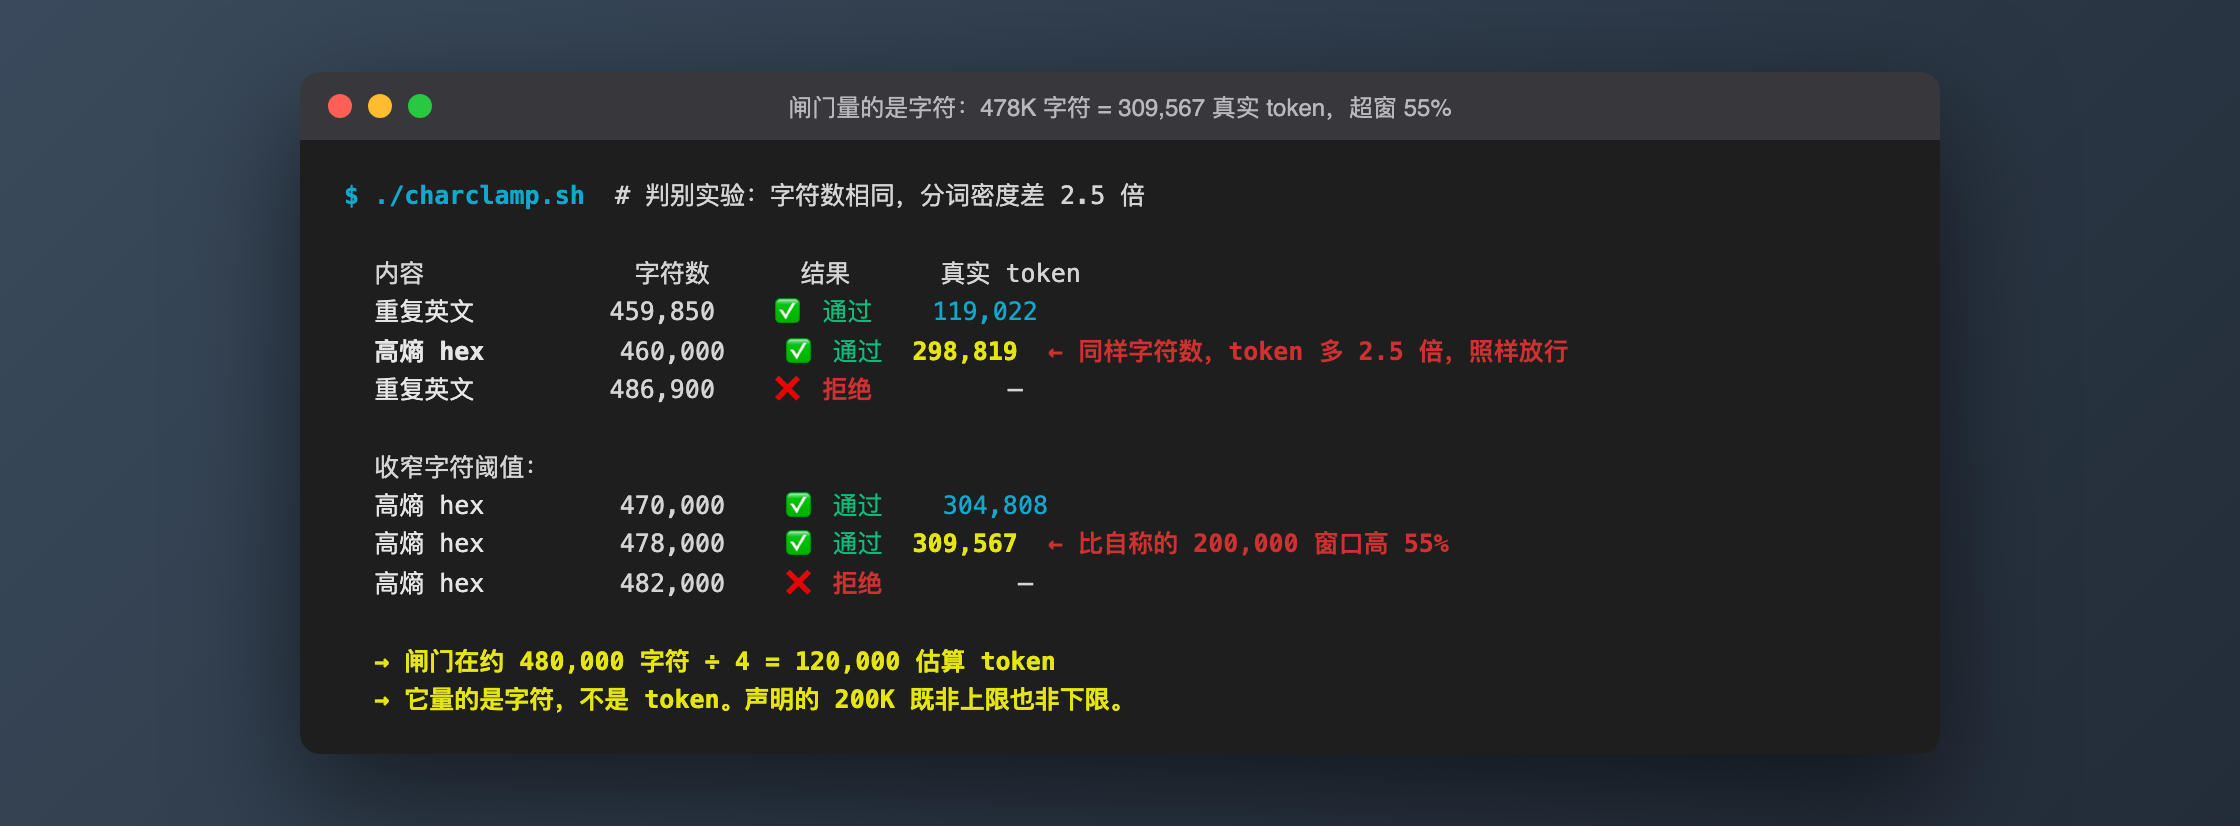
判别实验:字符数相同,分词密度差异极大。重复英文在这里约 5.4 字符/token,随机 hex 约 1.5。
| 内容 | 字符数 | 结果 | 真实 token |
|---|---|---|---|
| 重复英文 | 459,850 | ✅ 通过 | 119,022 |
| 高熵 hex | 460,000 | ✅ 通过 | 298,819 |
| 重复英文 | 486,900 | ❌ 拒绝 | — |
同样约 46 万字符。一个装了 11.9 万 token,另一个装了 298,819,两个都放行。闸门对 2.5 倍的真实 token 差异毫无察觉。
收窄字符阈值:
| 字符数 | 结果 | 真实 token |
|---|---|---|
| 470,000 | ✅ 通过 | 304,808 |
| 478,000 | ✅ 通过 | 309,567 |
| 482,000 | ❌ 拒绝 | — |
闸门在约 48 万字符。 除以 4 正好 120,000——就是「字符÷4」启发式,而这个预算本身又只有声明窗口的六成。
两个真会咬人的后果:
- 声明的 20 万窗口不是上限。 478,000 字符的 hex 顺利通过,真实 token 309,567,比标称窗口高出 55%,针照样准确返回。什么都没坏——因为 DeepSeek 的真实上限是 1M,空间大得很。
- 它也不是下限。 普通英文在约 11.9 万真实 token 处就被切掉了,远不到 20 万。
如果你的工作内容是中文、压缩过的代码、base64 或日志——任何不按 4 字符/token 分词的东西——屏幕上那个数字在两个方向上都没在描述你的处境。
第四层:日常使用里你一个都碰不到
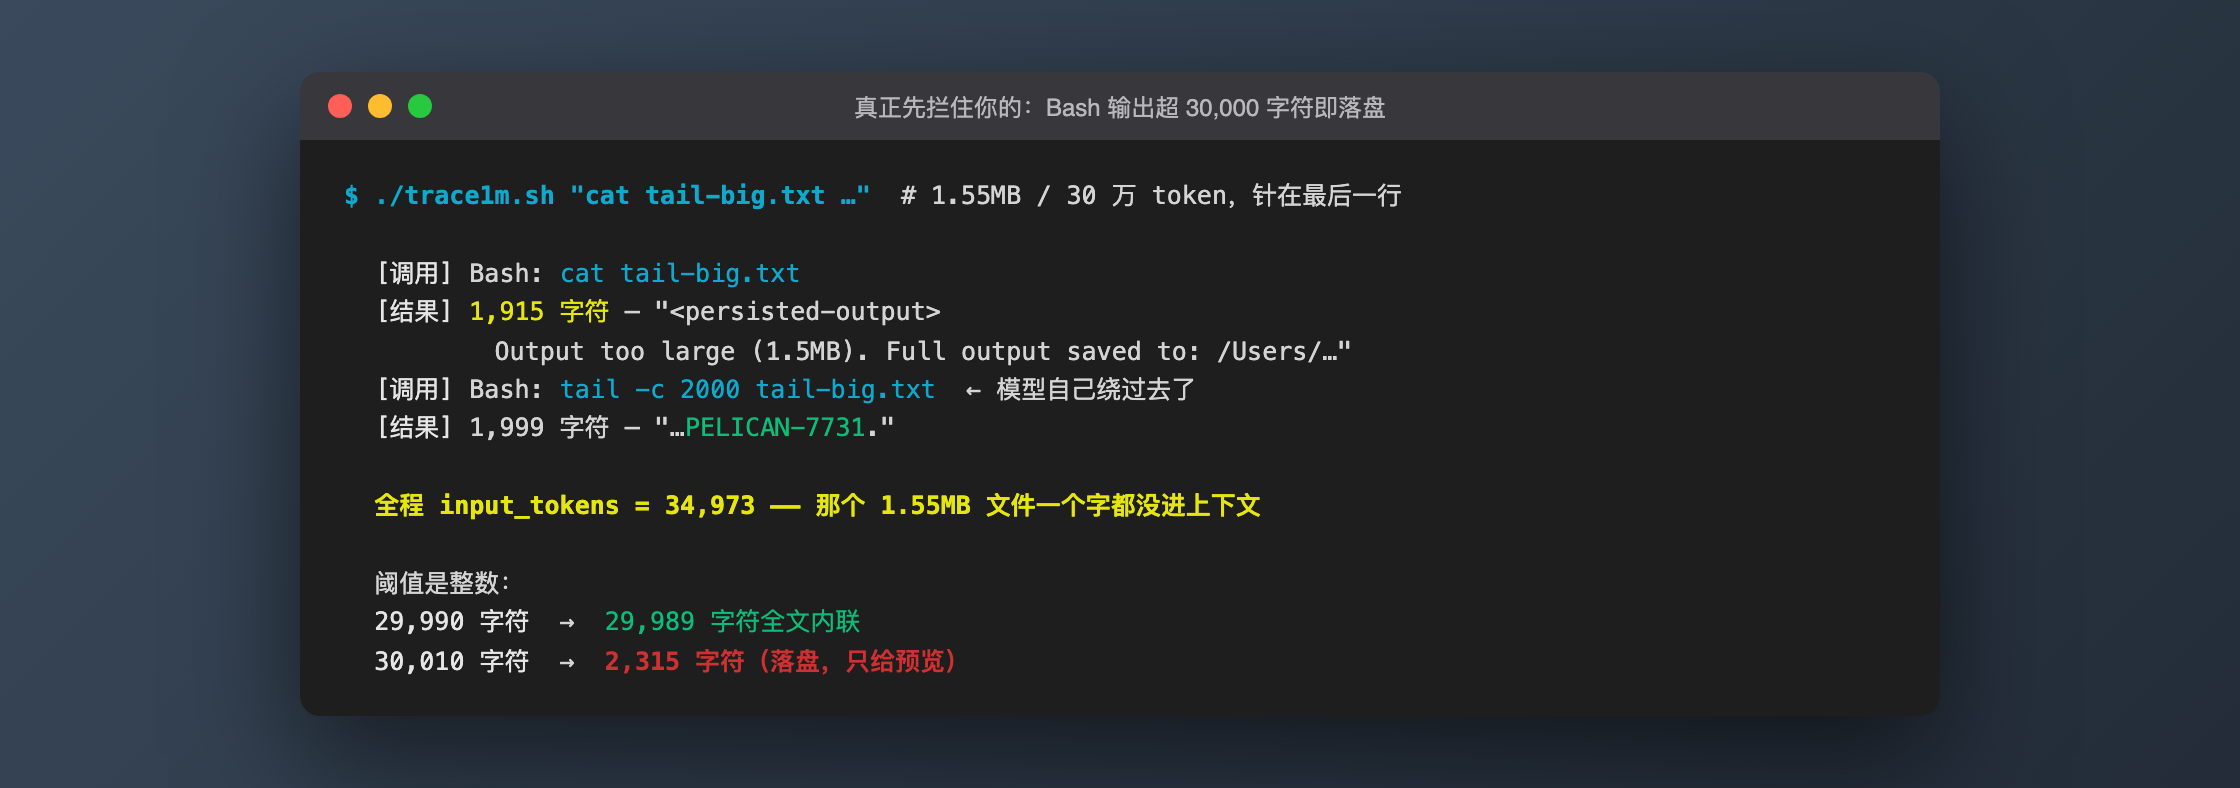
我造了个 1.55MB、30 万 token 的文件,针放最后一行,让 Claude Code cat 它。它答对了。但用量显示:
input_tokens: 34,973
文件根本没进上下文。抓真实工具调用才看清为什么:
[调用] Bash: cat tail-big.txt
[结果] 1,915 字符 — "<persisted-output>
        Output too large (1.5MB). Full output saved to: /Users/…"
[调用] Bash: tail -c 2000 tail-big.txt
[结果] 1,999 字符 — "…The maintenance access code … is PELICAN-7731."
Claude Code 把超大工具输出落盘成文件,只给模型约 2KB 的预览。模型随后自己用一条精准的 tail -c 2000 绕了过去。这是很好的 Agent 行为——也意味着在我发现之前,那个捞针测试其实什么都没测到。
阈值是整数:
| Bash 输出 | 进上下文的量 |
|---|---|
| 29,990 字符 | 29,989 字符 — 全文内联 |
| 30,010 字符 | 2,315 字符 — 落盘 |
整 30,000 字符。 单次 Bash 输出超过它就写盘 + 摘要。注意这是 Bash 的阈值——有一轮模型自己改用了 Read,同一个文件它内联返回了 53,656 字符。(那次让我的阶梯数据看起来自相矛盾;根因是模型换了工具,不是限制变了。要量工具就得把工具钉死。)
那到底谁说了算
都不算。按「谁先拦住你」排:
| 限制 | 数值 | 由谁执行 |
|---|---|---|
| Bash 输出内联 | 30,000 字符 | Claude Code,每次工具调用 |
| Prompt 闸门 | 约 48 万字符(字符÷4 ≈ 12 万估算 token) | Claude Code,客户端,25ms,不发 API |
| 声明窗口 | 200,000 token | 没人执行——实测既不是下限也不是上限 |
| 模型硬上限 | 1,048,576 token(输入 + max_tokens) |
DeepSeek,HTTP 400 |
标称的 1M 是真的、也真能用——对裸 API 而言。走 Claude Code,你会在大约十分之一处撞上一道数字符的闸门,而在那之前早就撞上输出落盘了。
实用结论
- 想要那 1M? 直接调端点。Claude Code 带不了你到那儿。
- 别按
contextWindow: 200000做规划。 它既不作为下限也不作为上限被执行。真正的客户端闸门是约 48 万字符。 - 非英文内容只会让估算更不准。 中文、压缩 JS、base64 都远离 4 字符/token,闸门落下时的真实 token 数可能是你预期的两倍——两个方向都有可能。
- 大文件不是上下文问题,是工具输出问题。 Bash 输出超 30,000 字符就落盘。用
grep/tail/sed取你要的那段,别cat完碰运气。 - 接近上限时,
max_tokens要和输入算在同一个预算里。
踩坑速查
- 阶梯里复用同一份填充语料会悄悄启用 prompt 缓存——我第一版跑出了两个体量差一倍却 token 数相同的行。每个请求加唯一 nonce。
- 针放在第 0 位,截断了也还在——什么都证明不了。放到最后,然后读
input_tokens确认内容真的进了上下文。 - 模型可能在两次运行之间换工具(
ReadvsBash cat),数字会完全不同。要量工具就把工具钉死。 claude -p "$(cat big.txt)"会死在Argument list too long——那是你 shell 的 ARG_MAX,不是 Claude Code 的限制。改用 stdin 管道。- 「1M」是 2^20 = 1,048,576,而且含你的输出预算。
2026-09-20 实测,Claude Code 2.1.270,macOS/Apple Silicon,经 https://api.deepseek.com/anthropic 打 deepseek-flash(DeepSeek-V4.1-Flash)。本文全部实验的 API 总花费:¥5.36 ≈ $0.75,按账户余额差测得。原始日志留存。