Ollama 显存不足怎么办:24GB Mac 实测 num_ctx、并发、KV 量化各吃多少内存,以及它不会拦你的那个坑
24GB 的 M4 Mac mini,Ollama 0.19 只认到 17.8 GiB 显存,默认上下文只给 4096。实测 qwen3:4b:上下文从 4k 开到 32k,占用从 3.73GB 涨到 9.89GB;OLLAMA_NUM_PARALLEL=4 时 8k 上下文占用等于单路 32k,但 ollama ps 只显示 8192;开 Flash Attention + q4_0 KV 量化后 32k 只要 4.31GB、64k 只要 5.77GB,速度不变。上下文开到远超内存时 Ollama 不会提前拒绝,而是直接开始分配,16 秒内系统可用内存掉到 23%。全部挪到 CPU 只慢 25%。
24GB Mac mini 能跑多大的本地大模型?内存账、实测速度与提速方案汇总
一台 24GB 统一内存的 Mac mini 到底能跑什么模型?答案是:27B 的 4-bit 量化就是天花板,且我们真的把 Qwen3.8-27B 在 M4 丐版上完整跑通了——峰值内存 19.4GB,投机解码后 11.7-12.2 tok/s。本文汇总这台机器上的全部实测:各参数量级的内存账、速度预期、三条提速路线的真实效果(DFlash 2 / 原生 MTP / MLX vs llama.cpp),以及量化档位怎么选。
大模型量化到底损失多少精度?Q8 到 Q2 一张表说清,附 GGUF 怎么选
4-bit 量化会让模型变笨吗?Q3 还能不能用?本文基于 llama.cpp 官方对 Llama-3-8B 全量化档位的 PPL/KLD 实测数据,把 Q8_0 到 IQ1_S 每一档的精度损失讲清楚,给出'内存装得下的前提下选最高档'的具体选择路径,并回答 Q4 与 Q8 差多少、imatrix 有什么用、1.58-bit 是怎么回事等高频问题。
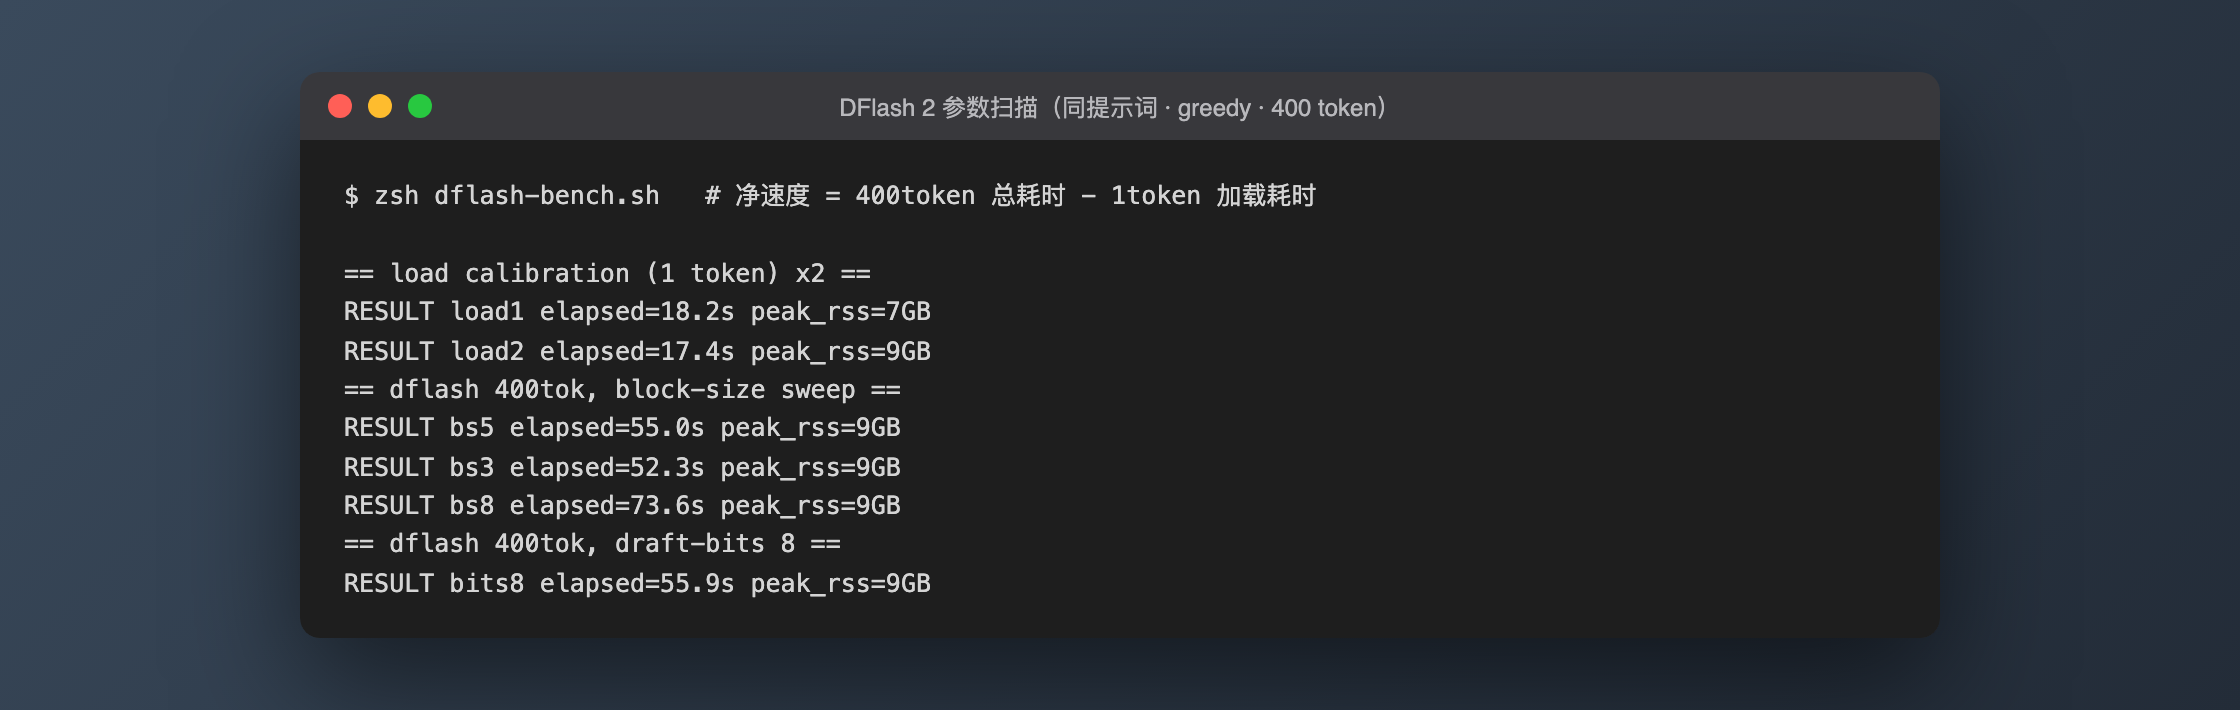
24G Mac mini 跑 Qwen3.8-27B + DFlash 2:实测 1.8x,以及为什么到不了官方的 3x
DFlash 2 发布一周后,我在一台 24G 的 Mac mini M4 上把 Qwen3.8-27B 加投机解码完整跑通:4-bit 量化下从 6.5 tok/s 提到 11.7–12.2 tok/s,稳定 1.8–1.9 倍。这篇记录完整部署命令、三轮对照实测数据、24GB 的内存账,以及官方 2.7–3.4x 数字在消费级 Mac 上打折的三个具体原因。8-29 复测追加 block-size 与草稿精度扫描:block-size 8 崩到 1.11x 坐实官方悬崖警告,block-size 3 反超默认值,8-bit 草稿不如 4-bit。