工具大全
开发者工具作者:Coocon2026年8月15日666 次阅读约 8 分钟阅读

Qwen3.8-27B 开源了,但我劝你别急着换主模型

Qwen3.8-27B 开源了,但我劝你别急着换主模型

昨晚十一点,一个同事在群里甩了条链接:Qwen3.8-27B 开源,GGUF 量化版和 FP8 权重同步上线。他的原话是「卧槽,直接能跑」。

我点进去看了一眼 HuggingFace 的仓库,确实是这么回事——原版权重、FP8 版、GGUF 量化版一起摆在那里。不用自己转格式,不用等社区补丁,下载完就能喂给 Ollama。对跑本地模型的人来说,这省掉的不只是几步操作,是一整个「折腾半天才跑起来」的下午。

但越是这种「开箱即用」的东西,越要多问一句:现在就换,真的划算吗?

27B,一个被低估的甜点尺寸

先聊尺寸。7B 太小,干不了正事;70B 太大,一张 4090 塞不下。27B 卡在中间,恰好是个人开发者能摸到的上限。

它比 7B 强了不止一档,资源消耗又远低于 70B。昨天你还在跑 Llama 3.1 8B,今天就能直接切到 27B——推理速度慢个 2 到 3 倍,换来的能力提升却可能超过一个量级。

这话不是我拍脑袋说的。横向对比下来,27B 是今年最划算的本地模型升级路径,没有之一。前提是:你的卡能装下。

FP8 不是免费午餐

官方宣传里有一句要打问号的话:性能「完全碾压」。你得先看这结论是从哪个 benchmark 跑出来的。

FP8 是压缩格式,精度是有真实损失的。推理变快了,代价是输出质量。这事不是新问题——Llama 3.1 405B 发布那会儿,社区拿 FP8 跑,幻觉明显变多。量化模型适合「要快、要糙、要便宜」的场景,真拿来写代码或者做微调,还是老老实实用原版权重。

一句话:GGUF 是给 llama.cpp 和 Ollama 这种工具链准备的,图的是省显存;但它省下来的每一 GB,都是从精度里抠出来的。

别被「开箱即用」冲昏头

我的建议很简单,分三步:

  1. 先别把主模型换掉。
  2. 在 Ollama 上把 GGUF 版跑起来,拿你自己平时用的 10 个 prompt 试一遍。
  3. 对比 FP8 和 FP16 的输出差异,看差异能不能接受。

能接受,再考虑切;不能接受,等原版权重或者更成熟的量化方案。

模型这东西,别人说好不算数,你的 prompt 跑出来的结果才算数。

今天你可以做的事

  • 去 HuggingFace 把 Qwen3.8-27B-GGUF 拉下来,用 Ollama 跑通一次。
  • 拿你最常用的一段代码生成或者总结任务,对比 FP8 和原版的输出。
  • 记下你的显卡型号和显存,算清楚 27B 到底跑不跑得动,别下载完才发现塞不下。

别急着升级,先试。试完再决定换不换。

✨ 本文由 DeepSeek 生成初稿,Claude 审核润色。

参考来源:
相关文章

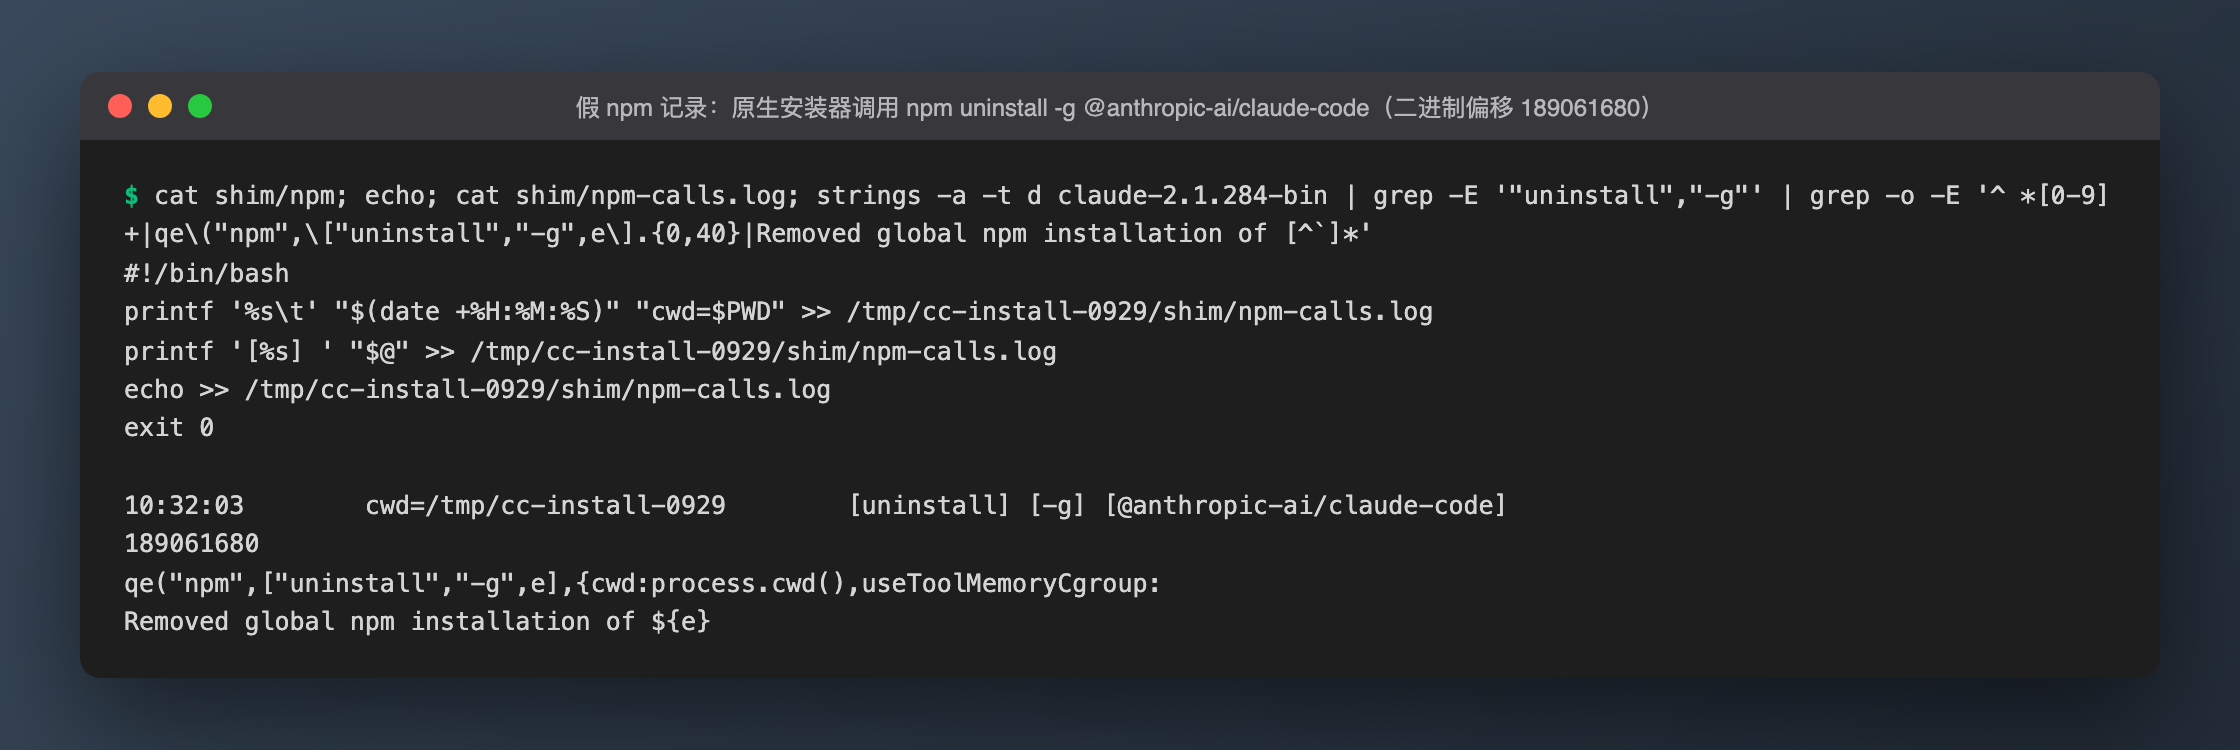
Claude Code 安装失败实测:npm EACCES、镜像卡 600 秒、Node 20 静默装旧版、install.sh 返回地区拦截页、原生安装器顺手卸掉 npm 版——15 条报错原文与解法

Claude Code 安装失败实测:npm EACCES、镜像卡 600 秒、Node 20 静默装旧版、install.sh 返回地区拦截页、原生安装器顺手卸掉 npm 版——15 条报错原文与解法

在 macOS 上把 claude code 安装的失败面逐个真实复现,共 15 条报错原文,全部带墙钟和 exit code。npm 全局装到 /usr/local:EACCES,exit 243。cache 目录只是 0555,npm 却报 root-owned 并建议 sudo chown。本机 npmmirror 两次分别用了 147 秒、超过 600 秒,官方源两次都在 11–12 秒(仅 2 个样本)。Node 20 不钉版本号会静默装到 2.1.197,没有任何警告。境内直连 claude.ai/install.sh 时 curl exit 0,拿到的却是一张 447KB 的地区拦截页 HTML。原生安装器会调用 npm uninstall -g,把已有的 npm 版删掉,终端里不提示——本次实测真的删掉了本机的全局安装。

claude-codenodejs+6
pitfalls2026年9月29日11 min
13

码农早餐 · 2026-09-29

今日头菜:一句「不要猜」,编造率从 71% 掉到 20%。另有 4 条快讯:Go 的 import 路径绑死在 GitHub:换一次托管要动多少代码;Sonnet 5.5 发布:Terminal-Bench 从 10.3% 跳到 70.6%;等。

daily-intel2026年9月29日10 min
26
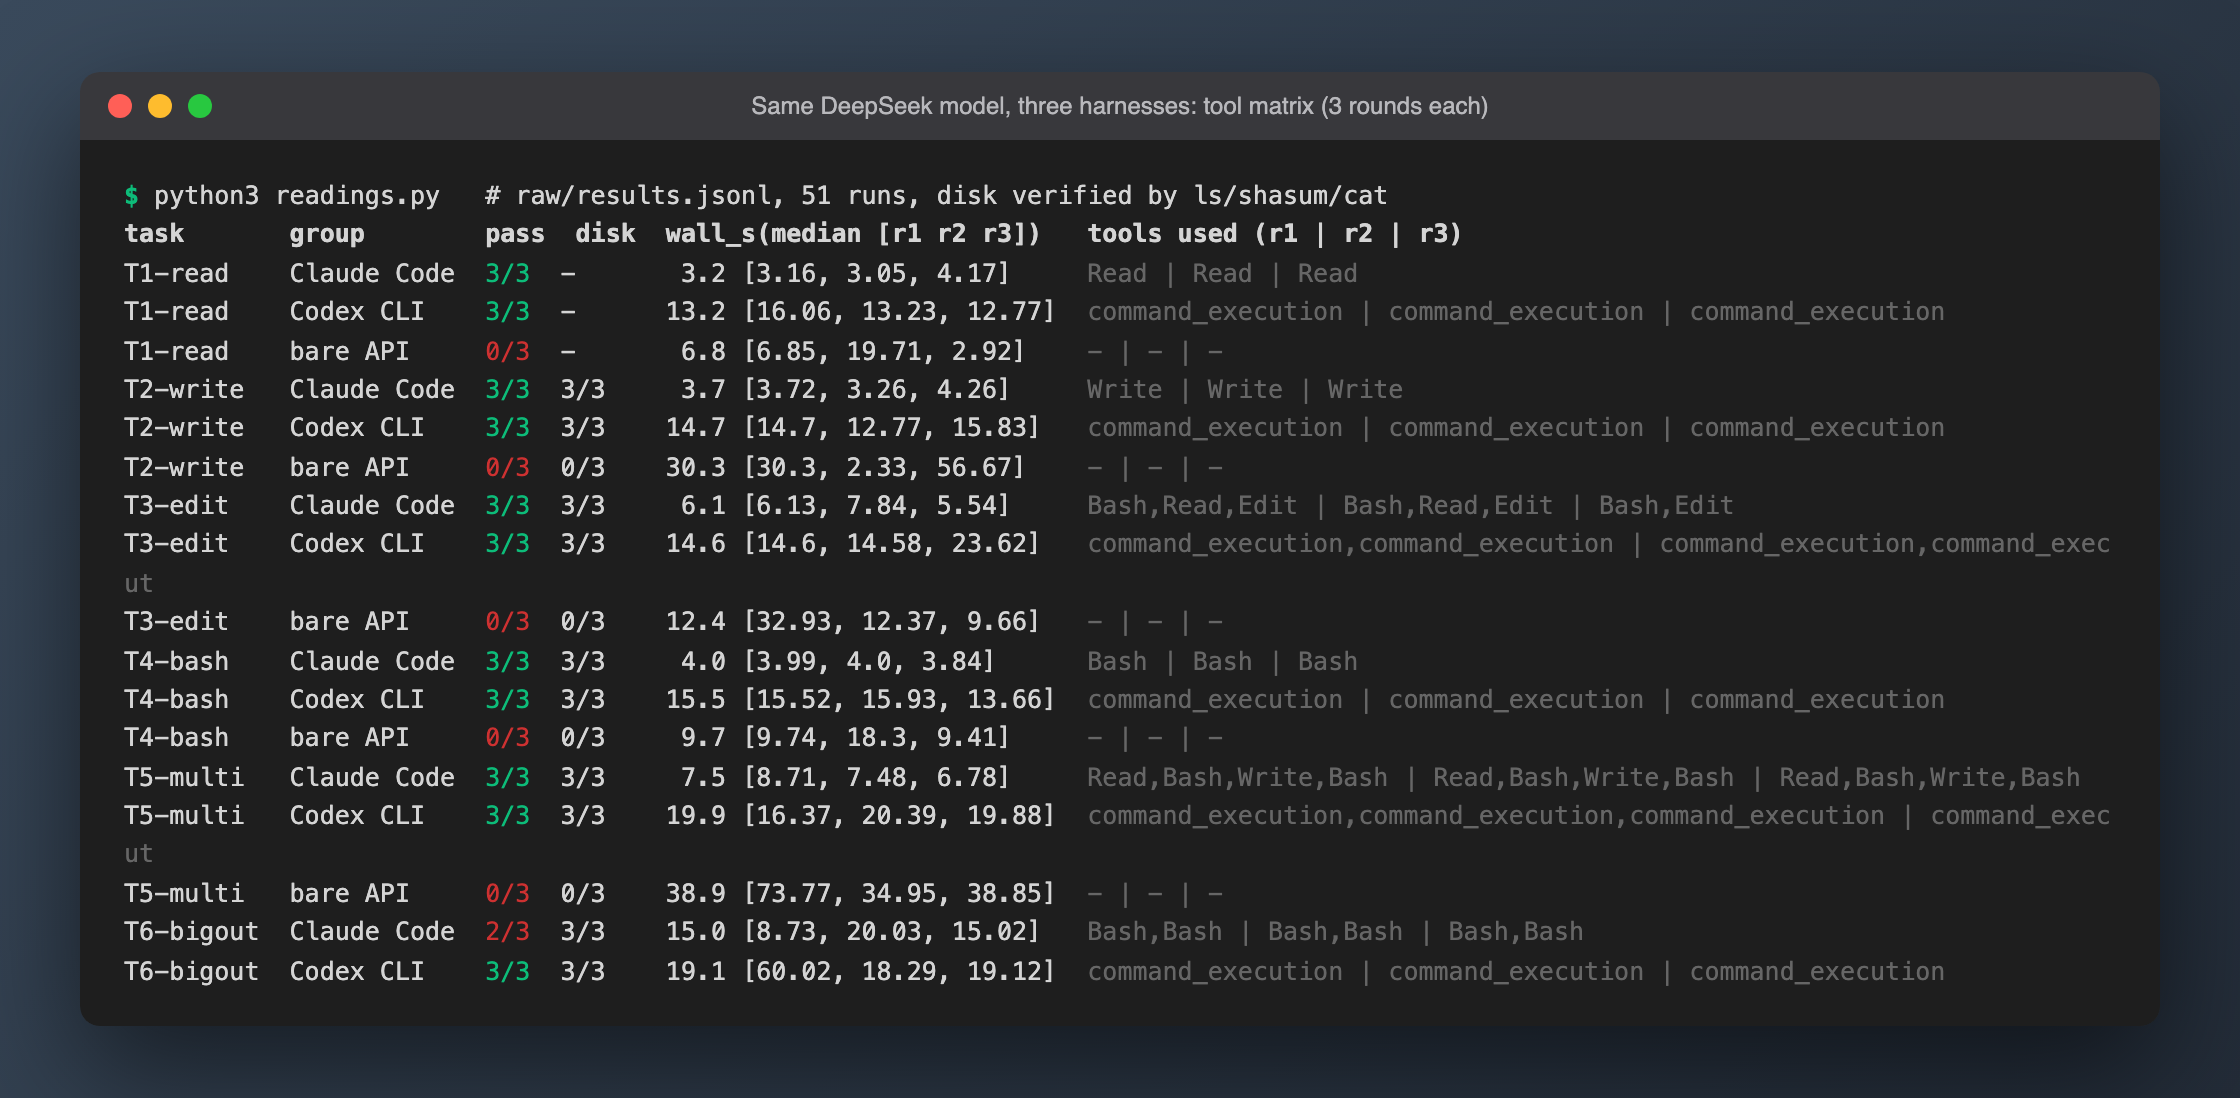
DeepSeek harness 实测:同一个模型换三种外壳——Claude Code 15/15、Codex CLI 15/15、裸 API 0/15 还谎报 5 次完成

DeepSeek harness 实测:同一个模型换三种外壳——Claude Code 15/15、Codex CLI 15/15、裸 API 0/15 还谎报 5 次完成

同一个 deepseek-v4-pro,三种 harness,读 / 写 / 改 / 跑命令 / 多步五个任务各 3 轮,副作用一律落盘核验。Claude Code 走 DeepSeek 的 Anthropic 端点:15/15,中位 4.17 秒,每轮 ¥0.159。Codex CLI 0.157.1 走 Responses 端点:15/15,中位 15.52 秒,每轮 ¥0.022——只有前者的 1/7。裸 chat/completions:0/15,其中 5 轮回复 DONE / EDITED,磁盘上什么都没有。差异全在 harness 不在模型:DeepSeek 的 Anthropic 端点按 metadata.user_id 分区缓存,Claude Code 每次 claude -p 都冷启动、约 15K token 全价;Codex 根本没有文件工具,读写改全走 shell;注入 500 时 Claude Code 重试 10 次约 175 秒、Codex 30 次约 25 秒放弃,429 时 Codex 不重试;120KB 输出时 Claude Code 只给模型看头部 2KB,Codex 保留头尾。另:Codex 0.157.1 已移除 wire_api = "chat",DeepSeek 必须走 responses。

claude-codedeepseek+6
hands-on2026年9月28日12 min
62

码农早餐 · 2026-09-28

今日头菜:GitHub 把 CSS 越写越多,服务端渲染反而快了 55%。另有 4 条快讯:NeoVim 改了 undo 文件格式,把 Vim 的撤销历史删了;Codex 一次 UI 检查开出 826 个子任务,账单 7.8 万美元;等。

daily-intel2026年9月28日11 min
40