Claude Prompt Caching 指南:降低重复输入、成本和延迟
Prompt Caching 是让 Claude 重复请求更便宜、更快的实用功能之一。Anthropic 官方文档将它描述为一种复用固定前缀的方法,例如系统指令、工具定义、示例和背景资料,而不用在每次请求里反复发送同一批内容。
这在你的工作流会不断重复同一套上下文时尤其有价值。如果你反复运行同一个 agent、同一套评分标准,或者同一组参考材料,Prompt Caching 可以减少大量无意义的输入 token,而且不会改变最终答案。
这篇文章原本只讲原理。2026-09-10 我补了文末的「本机实测」一节:真调 API,同一段 28K token 的 system 前缀连打 21 次,把 usage 里的三个 cache 字段、端到端延迟、首 token 延迟和按官方定价换算的账单全部读出来。先说结论:成本收益是量级的(命中后单次 $0.0719 → $0.0058),延迟收益在这个规模下只有一百多毫秒。
Prompt Caching 适合什么场景
Prompt Caching 最适合那些前半段几乎不变的请求:
- 很少变化的系统指令
- 长期固定的工具定义
- 大段背景资料
- Few-shot 示例
- 可复用的参考文档
Anthropic 的功能总览里把 Prompt Caching 和批量处理、引用、文件支持放在一起说明,这本身就很能说明问题:它主要是面向 API 和生产流程的优化能力,而不是给普通聊天用户准备的小技巧。
基本原理
工作方式其实很直接:
- 把稳定内容放在请求开头。
- 用
cache_control标记可复用部分的结束位置。 - 后续请求沿用同样的前缀,让 Claude 复用缓存内容。
Anthropic 建议按固定顺序组织静态内容:tools、system、messages。系统会自动匹配最长前缀,所以通常不需要到处放缓存断点。
实际使用模式
你可以把请求拆成两部分:
- 一部分是可复用的基础内容,比如角色说明、评分标准、示例或参考资料。
- 另一部分是每次变化的任务,比如新的用户问题或新的文档。
例如,一个客服分类 agent 可以把角色指令、升级标准和输出格式放进缓存,而每次只替换工单内容。文档分析流程也可以先缓存参考资料,再针对不同问题反复查询。
需要注意的限制
Prompt Caching 并不是所有请求都能直接套用的快捷方式。Anthropic 明确提到了一些限制:
- 提示词必须足够长,才能进入可缓存范围。
- 命中的前缀必须完全一致。
- 缓存按组织隔离。
- 空文本块不能缓存。
- Thinking blocks 不能直接缓存。
还有 TTL 的问题。Anthropic 支持默认的短缓存,以及部分场景下的一小时缓存。如果你要做生产流程,最好在依赖某个模型或缓存时长之前,先确认当前支持范围。
最适合缓存的工作流
Prompt Caching 在这些场景里通常效果最好:
- 多步骤 agent,反复复用同一套说明
- 固定评分标准的内部工具
- 大段上下文分析,而且参考材料变化不频繁
- 使用相同设置的批处理任务
如果每次请求都完全不同,缓存价值就很有限。系统指令、示例和上下文都变来变去时,能复用的部分很少。
常见错误
最常见的错误很简单:
- 缓存变化频繁的内容
- 以为改一点提示词措辞还能命中同一缓存
- 只缓存了一小段真正可复用的内容
- 把 Prompt Caching 当成提示词设计的替代品
只有“稳定内容真的稳定”时,缓存才有意义。提示词本身如果很乱,缓存也只是让混乱变便宜。
一个简单判断
如果你发现自己在很多 Claude 请求里反复复制同样的说明、示例或参考材料,那这部分内容大概率就适合缓存。
本机实测:同一段 63KB 的 system 前缀,连打 21 次
问题背景
上面的原理我写了半年,但一直没亲眼看过 usage 里的 cache_read_input_tokens 到底长什么样,也没算过「省 90%」落到一次真实请求上是几分钱。更要紧的是官方文档把「更便宜」和「更快」并列,这两个收益在我的环境里是不是同一个量级,没人替我测。
问题分析
要把「缓存生效」坐实,三件事必须分开量:
- 命中证据只有一处:响应
usage里的input_tokens/cache_creation_input_tokens/cache_read_input_tokens。第一次应该是 creation 有数、read 为 0;第二次反过来。没有这两个字段,其他一切都是猜。 - 延迟要剥离。端到端时间里混着网络往返、中间代理、排队和生成,缓存只影响 prefill 那一段。所以除了端到端,还得用流式请求量首 token 时间,并且拿一个没有长前缀的极小请求当基线。
- 成本按官方定价页换算:Claude Sonnet 5 输入 $2 / MTok,5 分钟缓存写入 $2.50(1.25 倍),缓存命中 $0.20(0.1 倍),输出 $10(定价页,2026-09-10 核对)。
技术方案与选型
- 模型:
claude-sonnet-5。 先打/v1/models探明代理能用的模型再选。排除 Opus 5 和 Fable 5.1:同样的 token 数贵 2.5 到 5 倍,而这个实验根本不需要智力。排除 Haiku 4.5:它的最低可缓存前缀是 4096 token,是所有在售模型里门槛最高的一档,拿它得出的结论不具代表性。 - 素材:本站
docs/CHANGELOG.md的前 45 行,63,010 字节、35,262 个字符,count_tokens实测连同用户消息一共 28,207 token。这是一份真实的中文长文档。排除随机字符填充:tokenizer 会把乱码切得很碎,token 数虚高且不代表任何真实工作负载。 - 冷热控制:每轮在 system 开头加一行 nonce。 这样每轮第一次请求必然是冷的,后两次沿用同一 nonce 必然共享前缀。排除「等 5 分钟让缓存过期」:太慢,而且 TTL 边界不精确。
- 固定输出:关掉 thinking、
max_tokens: 16、用户消息只有一句「Reply with the single word OK.」 21 次请求输出全部恰好 4 token,延迟差异只可能来自输入侧。排除「让模型总结文档」:输出长度随机,延迟没法比。 - 直接用 Node 内置
fetch打/v1/messages,不用 SDK。 目的是把请求体看得一清二楚:cache_control标在 system 数组最后一个 block 上。 - 认证走 Anthropic 兼容代理(
Authorization: Bearer+anthropic-version: 2023-06-01,本机没有 API key)。这意味着延迟里多了一跳,后面的 TTFT 实验会专门把这一跳量出来。
请求体长这样(nonce 那一行每轮换):
{
  "model": "claude-sonnet-5",
  "max_tokens": 16,
  "thinking": { "type": "disabled" },
  "system": [
    {
      "type": "text",
      "text": "[bench 20260910T0211 prefix A1]\n\n<63KB 的 CHANGELOG 正文>",
      "cache_control": { "type": "ephemeral" }
    }
  ],
  "messages": [{ "role": "user", "content": "Reply with the single word OK." }]
}
实测过程
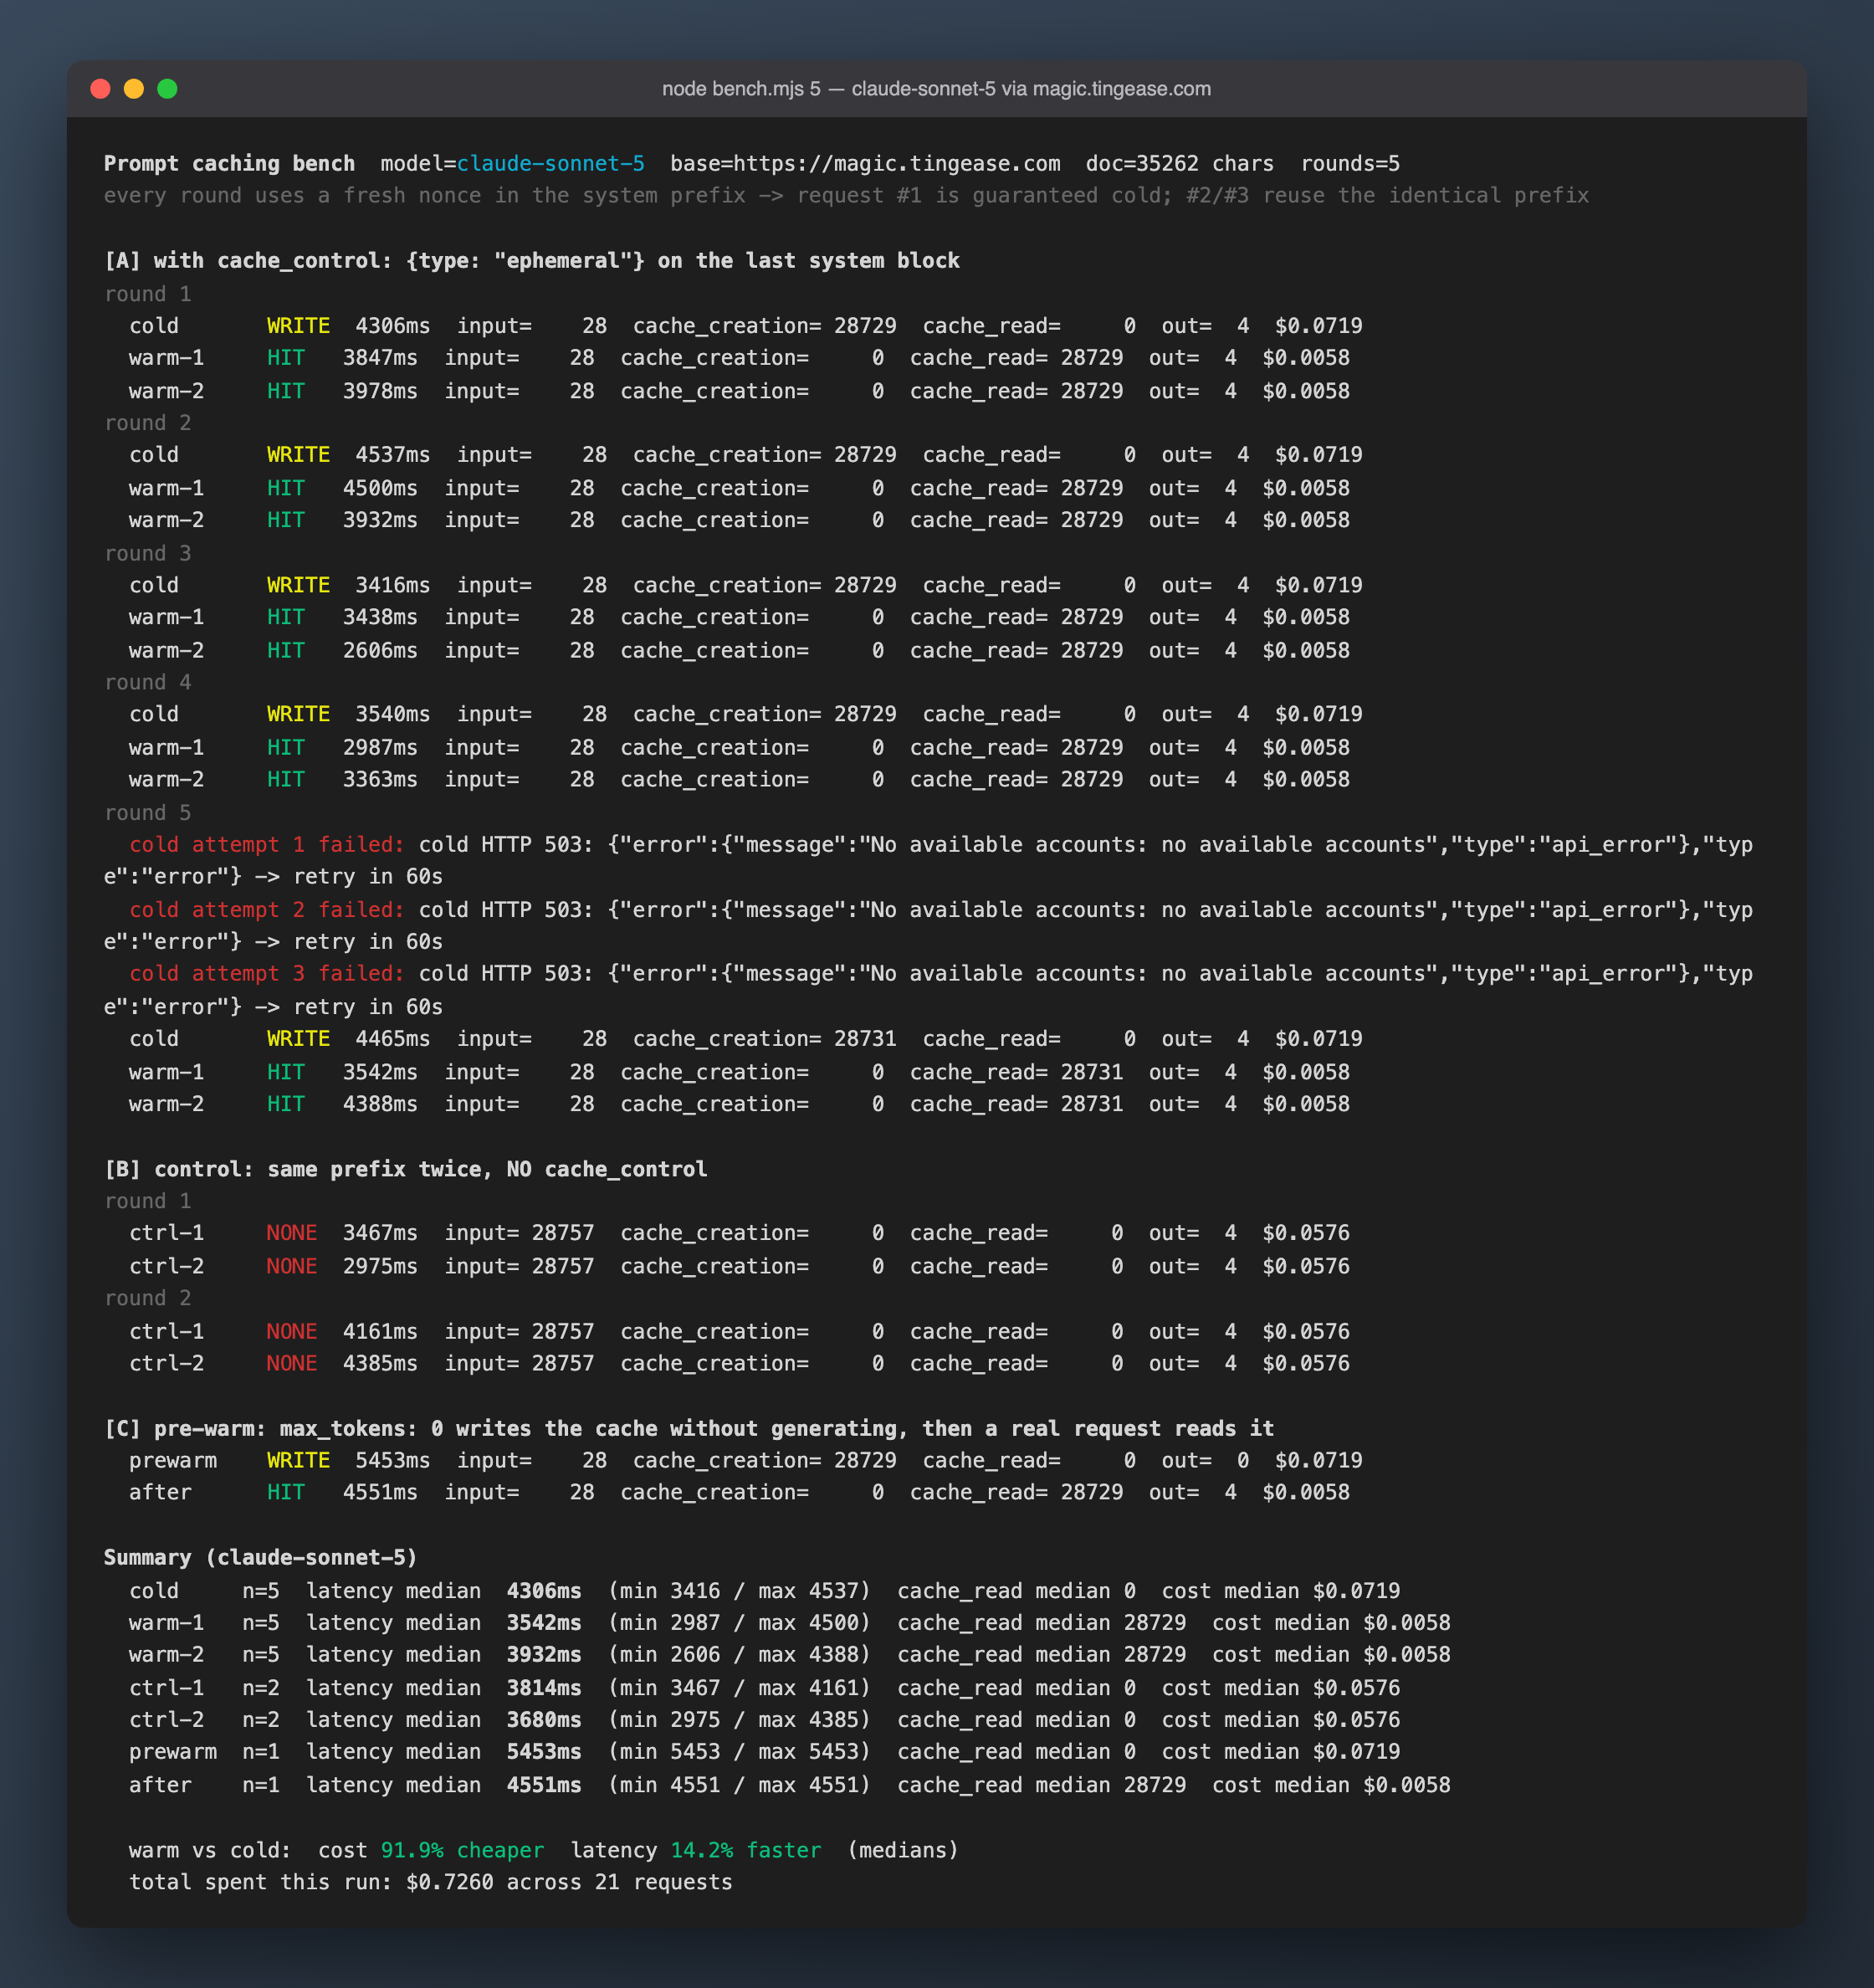
脚本跑三组,每次请求之间间隔 8 秒:
- A 组:5 轮 × 3 次,带
cache_control。每轮 1 次冷请求(新 nonce)+ 2 次热请求(同 nonce)。 - B 组:2 轮 × 2 次,同样的前缀连打两次,但不带
cache_control,作为对照。 - C 组:预热演示。第一次
max_tokens: 0,只写缓存不生成;第二次正常请求读缓存。
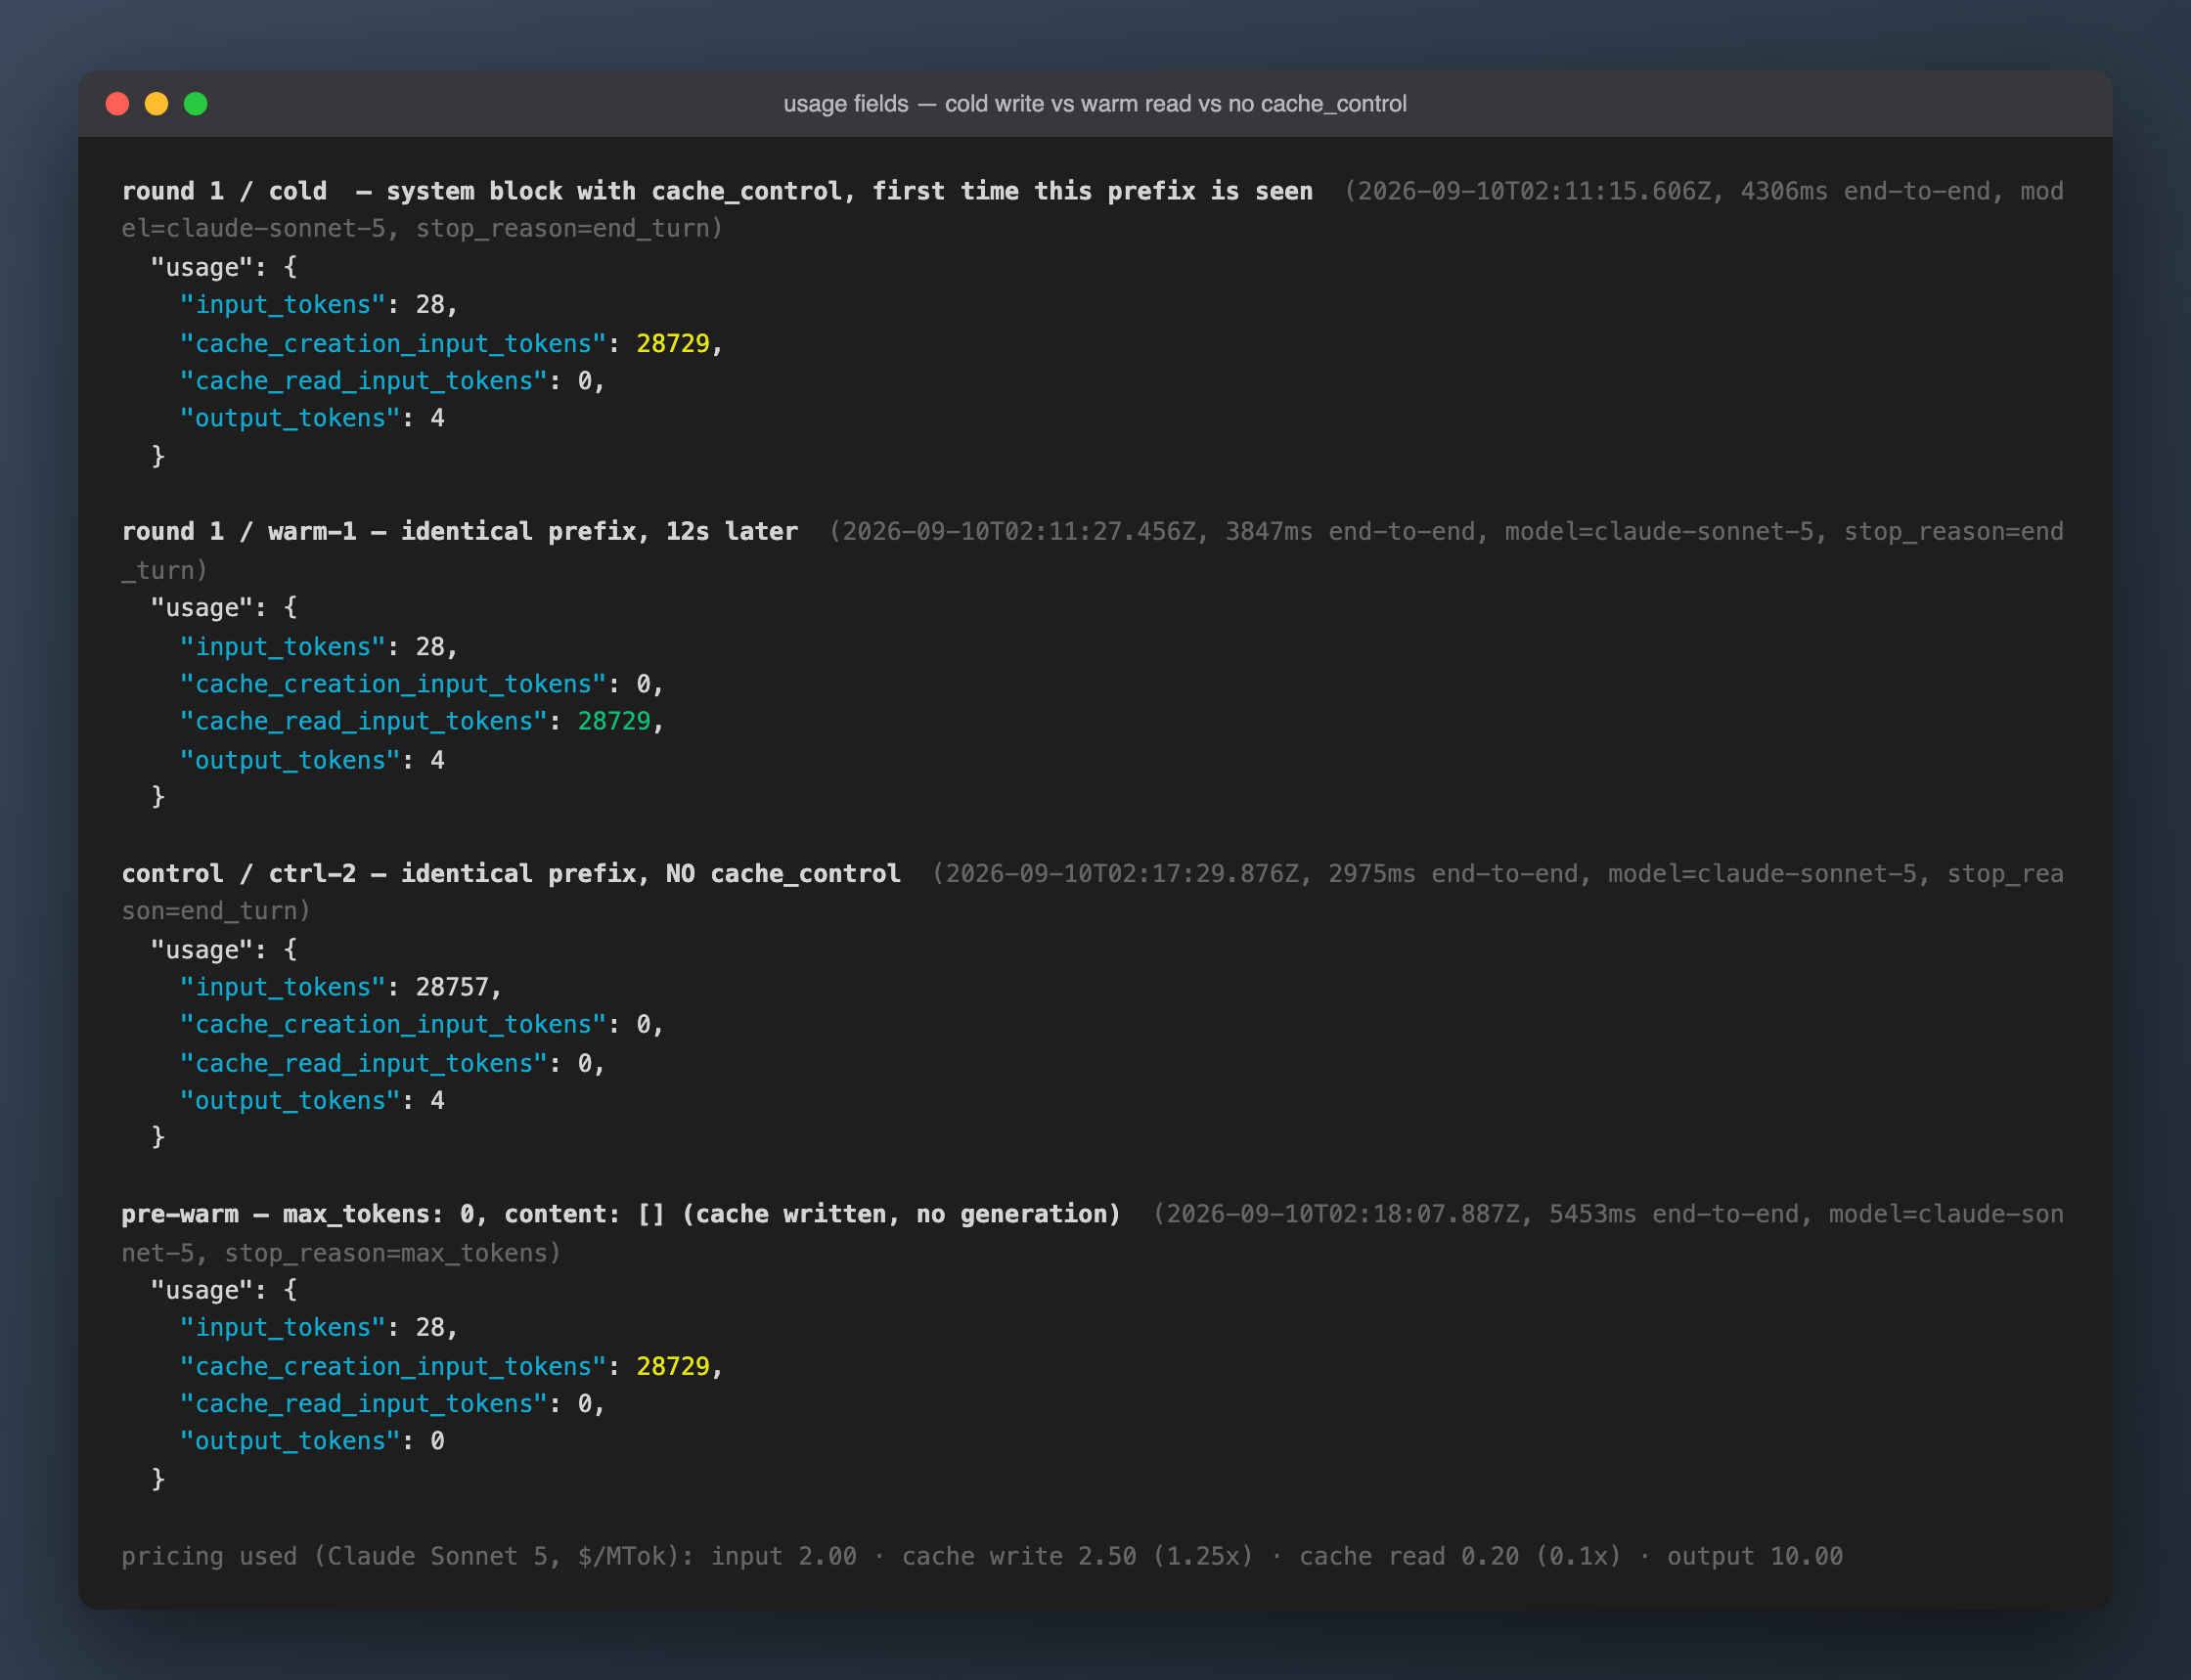
把三种情况的原始 usage 并排放一起,就是这篇文章最想让你看的一张图:
实践效果
命中 100%。 5 轮冷请求全部 cache_creation_input_tokens = 28729,10 次热请求全部 cache_read_input_tokens = 28729,热请求的 input_tokens 只剩 28(用户消息那一句)。对照组 4 次全是 input_tokens = 28757,两个 cache 字段都是 0。也就是说整段 system 前缀 + 代理注入的部分都进了缓存,缓存外只剩用户消息。
按官方定价换算,单次请求的账(输出 4 token 可忽略):
| 请求类型 | input | cache_creation | cache_read | 单次成本 | 端到端中位 |
|---|---|---|---|---|---|
| 冷请求(写缓存) | 28 | 28,729 | 0 | $0.0719 | 4,306 ms |
| 热请求(读缓存,n=10) | 28 | 0 | 28,729 | $0.0058 | 3,695 ms |
| 对照(无 cache_control,n=4) | 28,757 | 0 | 0 | $0.0576 | 3,814 ms |
几笔账:
- 热请求比冷请求便宜 91.9%,比不缓存的对照便宜 90%。
- 冷请求比不缓存贵 25%($0.0719 vs $0.0576),这是缓存写入的溢价。
- 同一前缀打 2 次:缓存 $0.0777 vs 不缓存 $0.1152,第二次就回本。打 10 次:$0.1241 vs $0.5760,省 78%。
- 整个实验(含一次冒烟和 TTFT 组,共 36 次请求)花了约 $1.3。
延迟收益比想象小得多。 端到端中位只快了 14%(4,306 → 3,695 ms),而且抖动很大:第 2 轮的热请求 4,500 ms 和冷请求 4,537 ms 几乎一样。于是补跑了流式请求量首 token 时间,并加一个没有长前缀的极小请求作基线:
| 请求 | 首 token 中位 | 区间 |
|---|---|---|
| 极小请求(无 system,基线,n=2) | 2,674 ms | 2,668 – 2,680 |
| 冷请求(写缓存,n=3) | 2,964 ms | 2,847 – 3,169 |
| 热请求(读缓存,n=3) | 2,816 ms | 2,657 – 3,036 |
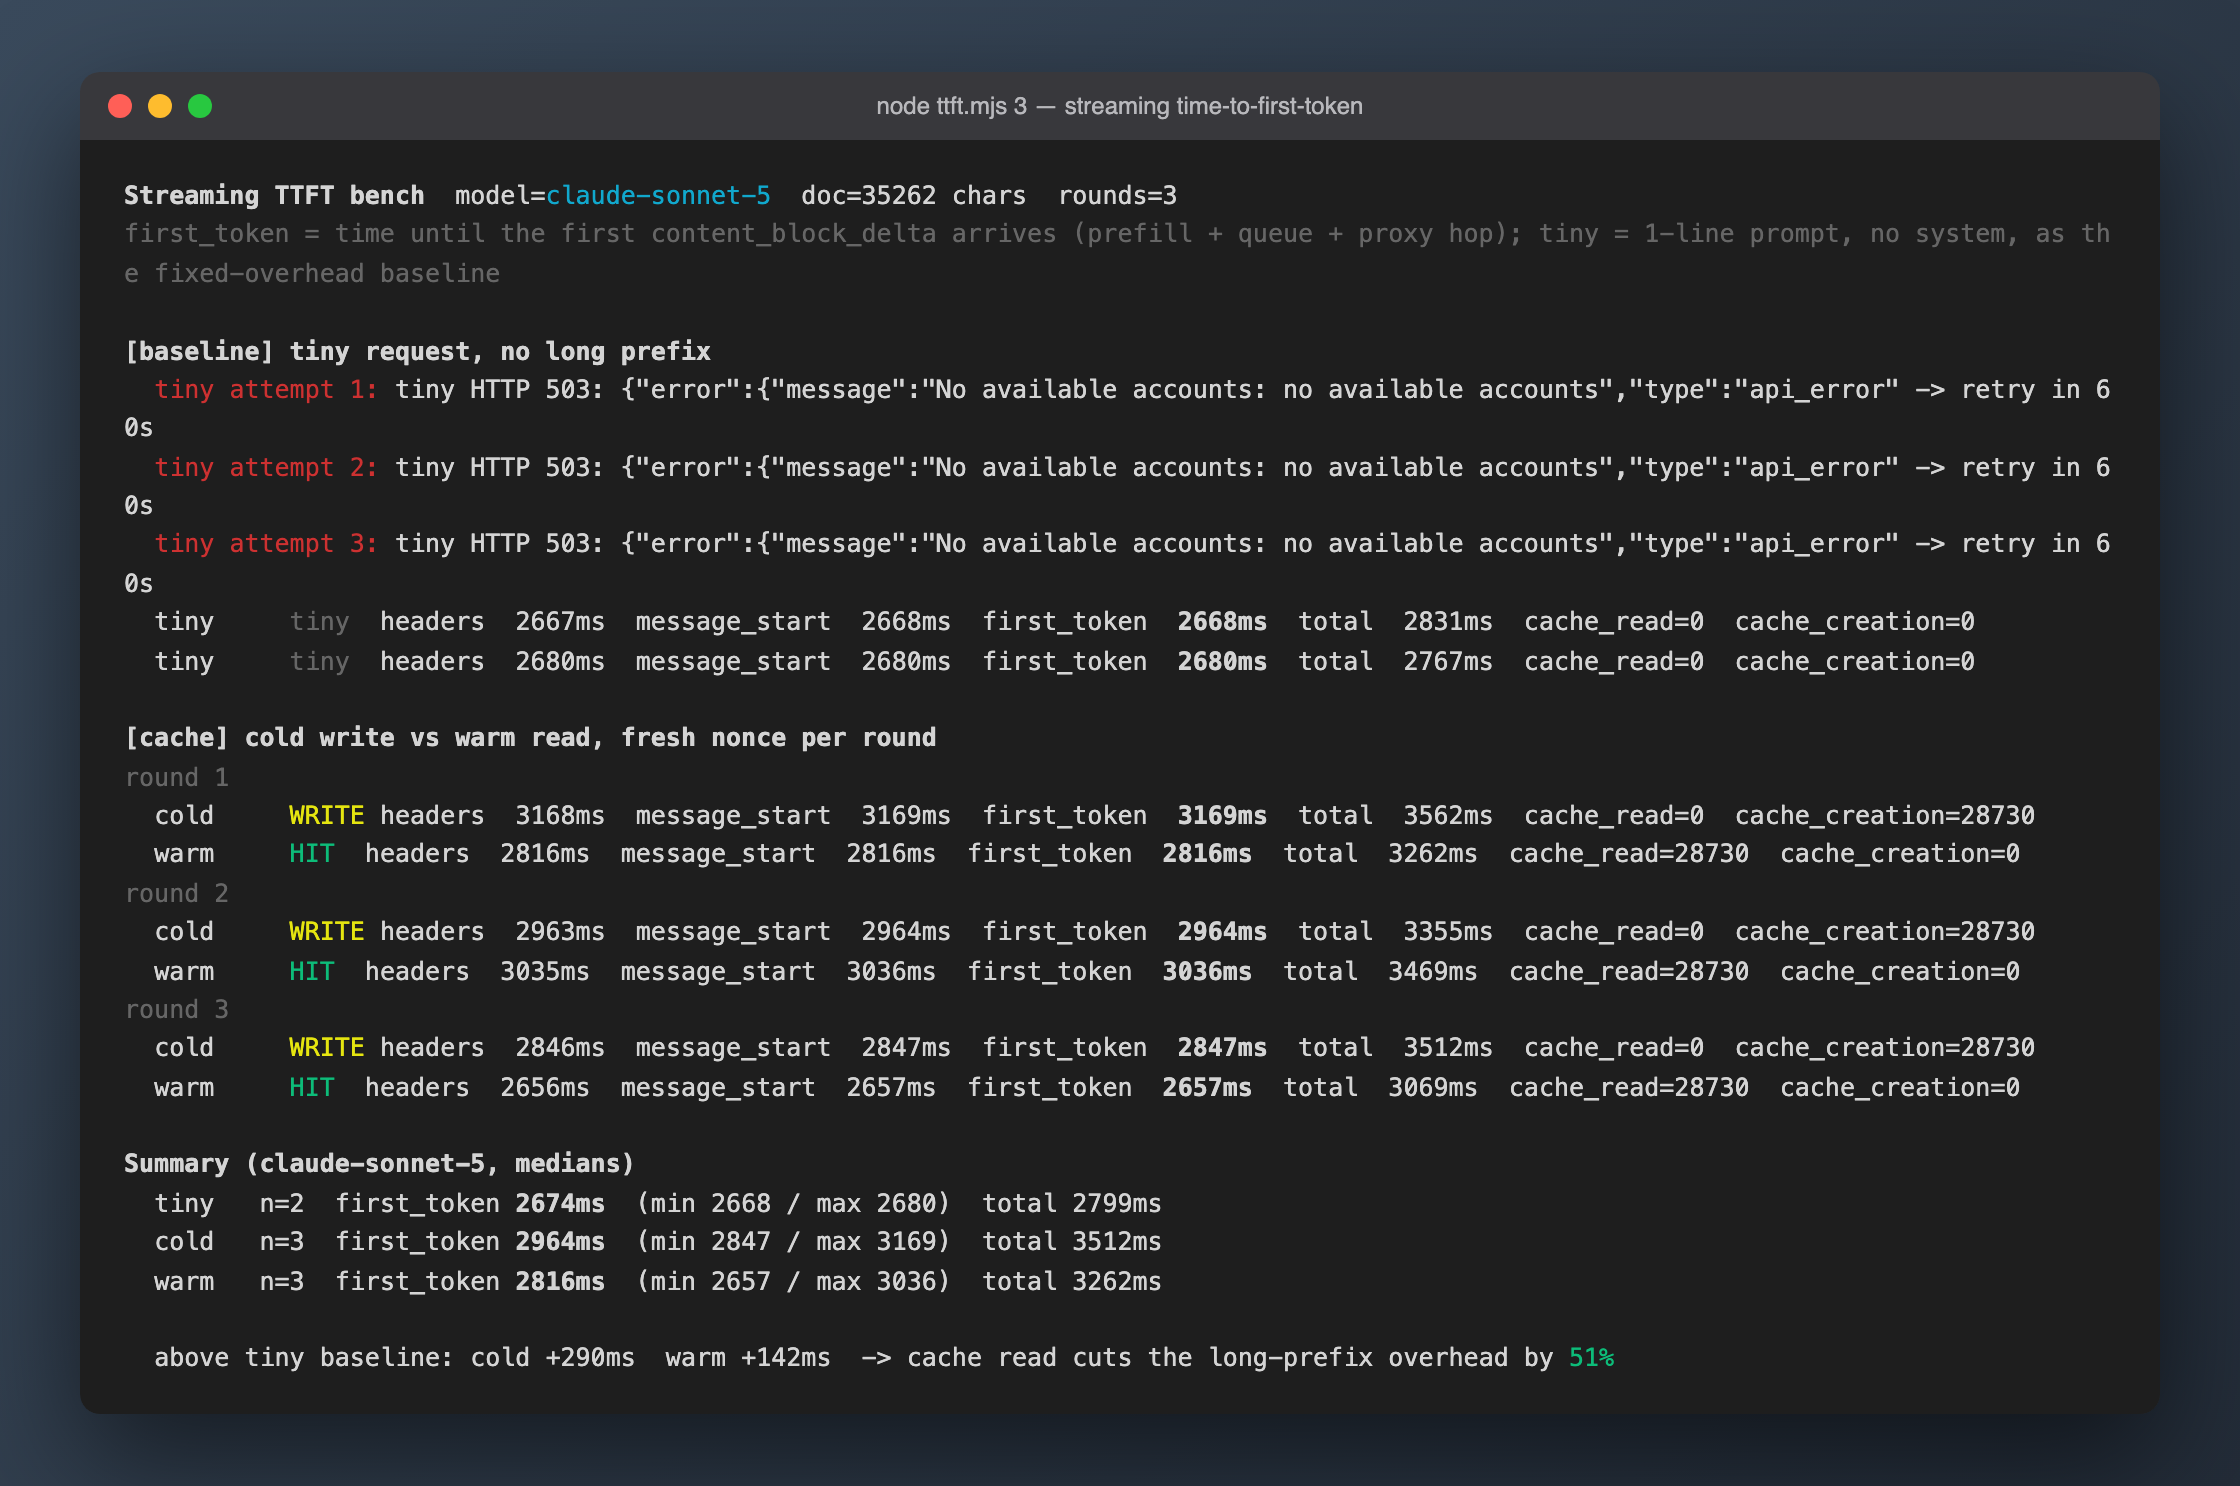
这张图说明了两件事。第一,我这条链路的固定开销是 2.7 秒:一句「hi」的首 token 也要 2.7 秒,这是代理那一跳加跨境网络,与缓存无关。第二,28K token 的 prefill 在 Sonnet 5 上只多花了约 290 ms,缓存命中把它压到约 142 ms,省了一半,但绝对值只有 150 ms 左右。在几万 token 这个规模、又隔着代理的情况下,Prompt Caching 是一个省钱功能,不是一个提速功能。 延迟收益要在前缀更长、链路更直接时才会显出来,这一点本次没测,不下结论。
max_tokens: 0 预热是可用的。 C 组第一次请求返回 stop_reason: "max_tokens"、output_tokens: 0、cache_creation_input_tokens: 28729,紧接着的正常请求直接 cache_read 28729。冷启动前先打一枪,用户的第一次请求就能吃到缓存。
踩坑
- 代理返回 503
No available accounts,与 cache 无关。 冒烟跑完 7 次请求后,紧接着的所有请求都 503,连一句「hi」都过不去;正式跑到第 5 轮冷请求、以及 TTFT 组开头又各来了一次,每次都在约 3 分钟后自动恢复。根因未完全确认,从「连发几次 28K token 冷请求就触发、只有短 prompt 时不触发、固定几分钟恢复」看,像是上游账号被打进限流冷却期,代理在冷却期内没有可用账号。解法:请求间隔 8 秒,503 退避 60 秒重试最多 4 次;冷请求重试必须换 nonce,否则上一次万一已经到达上游写了缓存,重试就不再是冷的。 - 别把第一次 503 归因给功能。 第一次
max_tokens: 0预热正好撞上 503,我差点写成「代理不支持 max_tokens 0」。第二次跑完全正常。同一个错误码先查环境再怪功能。 - 代理往前缀里注入了约 500 token。 一句「hi」不带 system 就计
input_tokens: 516;count_tokens算我的素材是 28,207,实际计费 28,757。多出来的 550 是代理注入的内容加 nonce 行。好在它落在缓存范围内(热请求input_tokens只有 28),不影响命中。启示:cache_read和你自己算的 token 数对不上时,先怀疑中间层,再怀疑自己。 - 按字节截文件会切坏 UTF-8。
head -c 40000把一个中文字符从中间切断,脚本读文件直接UnicodeDecodeError。中文素材要按行截(head -n)。 - 单轮延迟数字没有意义。 端到端抖动(2.6 到 4.5 秒)比缓存收益(约 150 ms)大一个量级,5 轮里出现过热请求比冷请求还慢的情况。必须取中位,而且要用极小请求把固定开销剥出来,否则「快 14%」和「快 51%」你不知道该信哪个。
复现脚本在仓库 tmp/2026-09-10-prompt-caching/(bench.mjs 端到端 + 成本,ttft.mjs 流式首 token),认证从本机 Claude Code 的 settings.json 读,换成你自己的 API key 就能跑。
官方参考资料
原理部分的资料检索于 2026年3月29日,实测与定价核对于 2026年9月10日。功能可用性、模型支持范围和价格细节可能会变化,发布前请以链接中的 Anthropic 官方资料为准。